
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
设想一下:
你用Claude Code手搓了一个小应用,顺便给它接了个AI客服。
本想让它自动解答用户「怎么登录」「会员服务有啥内容」之类的基础问题,好让自己当个甩手掌柜。
结果客服确实能聊天了,但你却沦为了它的全职陪练:
回答不准,赶紧补一句提示词;解释太啰嗦,再加一条限制。
更让人崩溃的是,每改一句提示词,你都得把常见问题重新问一遍,生怕它顾此失彼,刚修好一个问题,却把原本答对的又改坏了。
于是,用AI写代码省下的时间,又有不少还给了一轮轮的人工调试。
针对这类反复调试的麻烦,9月28日,Anthropic官方发布了一份调优指南。
这份指南的核心思路就一句:反复测试、修改这样的活,Claude也能干。
让它多接手一些,你就能少当几轮苦哈哈的测试员,把更多精力用来给AI把关:
给它定规矩,说清楚什么才算做好,再检查它有没有真正做到。
要让AI有方向地改错,先得把「怎样才算做对」说清楚。
平时我们总希望AI客服「靠谱一点」,但这太抽象了。
如果能把要求落到用户真正会遇到的问题上,标准就具体多了。
比如:
用户找不到导出按钮时,它能不能给出正确的点击路径?
用户问到还没开发出来的功能时,它会不会一本正经地胡说八道?
遇到退款问题,它能不能按明确的规则处理,拿不准时不乱承诺?
官方提供的第一个入口是:/claude-api build-eval。
简单来说,它能帮你把这些具体要求变成测试题,为接入Claude的小应用建一套可以反复运行的验收题库。
你可以把平时让AI频繁翻车的问题交给它,但题库不能只收录「翻车现场」,那些最常见、最普通的问题,同样也要覆盖。
否则,偏题、难题堆得再多,也可能测不准普通用户的日常体验。
题目选好了,还要把「怎么判分」说清楚。
「专业」「智能」「友好」,这些要求颗粒度都太粗,要落到一些更具体的衡量标准上。
比如哪些信息必须说清楚,哪些错误不能犯,做到什么程度才算过关。
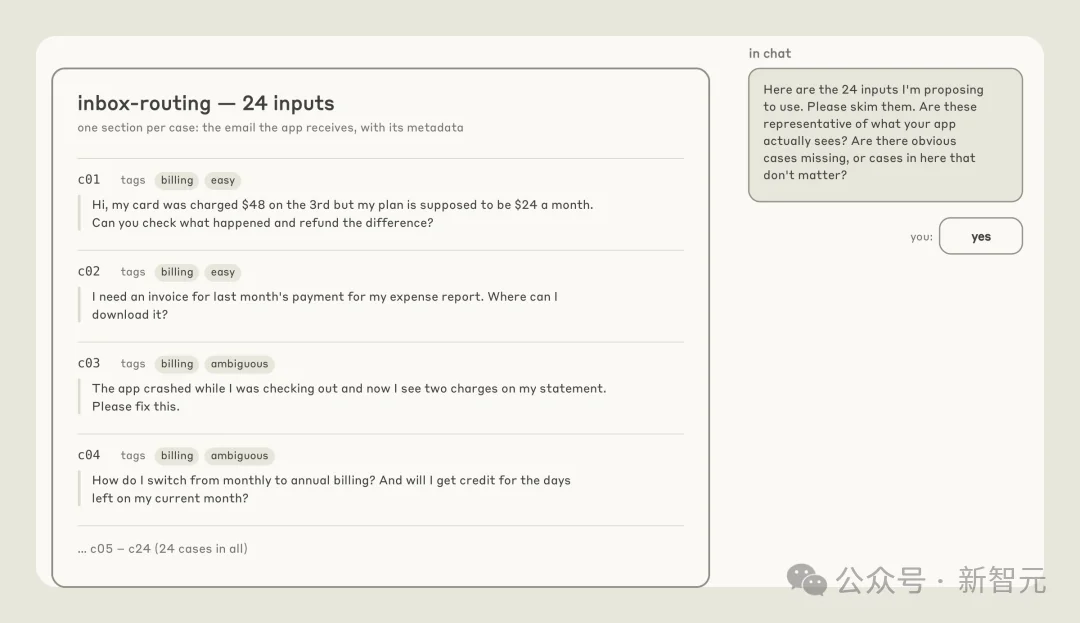
官方邮箱分类示例:测试样例需由用户确认。
Claude会帮你拟出相应的评分规则,而你要确认按这套规则拿到高分的答案,是不是真的解决了用户的问题。
有些结果可以直接用程序检查,比如有没有遗漏关键字段;遇到一些有多种合理答案的开放性问题,也可以让模型按明确的规则打分。
但评分器本身也要先过关。
拿几份已经打过分的答案,对照自己的判断,看看有没有「答对了却扣分」「没解决问题却给过关」的情况。
确认评分靠谱,再定期抽查。
对于开发者来说:这一步最大的爽点在于,你终于能把那句「怎么又答错了」的反复抱怨,变成一套可以持续运行的自动化检查。
以后每改一次提示词,就能再跑一遍,看看这次修好了哪里,有没有把别处改坏。
题库建好了,接下来就是掏出第二个官方入口:/claude-api hillclimb。
hillclimb可以理解为「爬坡」,让AI一点点尝试优化,看看有没有进步。
但这个KPI同样也要定得具体,还要说清楚允许它改什么。
比如,让客服回答得更准一点,允许它修改提示词;或者在维持回答质量的前提下,尝试省点API费用,允许它调整模型配置。
接到任务后,Claude会查看用于迭代的那些错题,每轮提出一处修改,再重新跑评估:
在既定目标下确有改善,才保留修改;改完后反而退步了,就撤回。
按官方文档,这两个入口都要求Claude Code v2.1.259及以上。
提示词、技能文件、工具说明和模型配置等,都可以成为调优对象,但具体改哪些,要由你划定范围。
你可能会担心:AI会不会变成应试教育的做题家?也就是只针对你给的那几道题死记硬背,换个问法又开始胡言乱语?
官方也确实考虑到了这一点。
这套流程会单独留出一部分题,作为不提前公开的「验收考题」。
负责提出修改的模型看不到这些题的内容。每轮改完,再用它们测试,看看效果是真的变好了,还是只对练过的题管用。
如果练过的题分数涨了,「验收考题」的成绩却没提高,就可能出现了「过拟合」:越来越会做熟题,换一批题却没进步。
遇到这种情况,Claude会撤回本轮修改;如果改完后表现反而变差,也会回退。
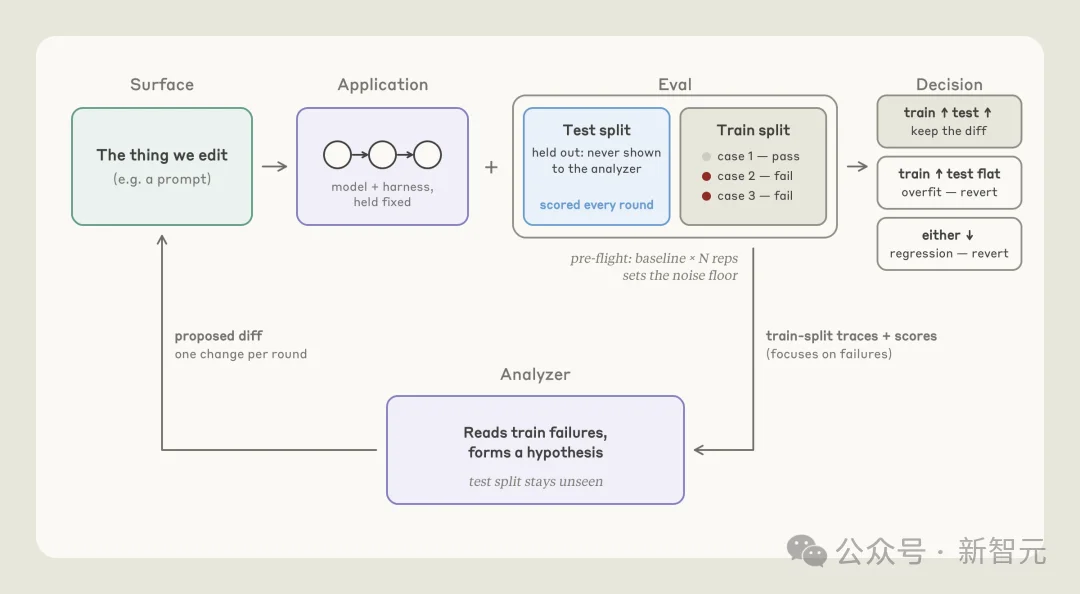
每轮修改后复测,根据结果保留或撤回。
这能帮助发现「只会做熟题」的问题,但不代表从此高枕无忧。
题库本身覆盖不到的真实问题,仍然可能让它翻车。
Anthropic用一个内部客服评测展示了效果。
在14张未参与指导修改的留出测试工单上,最终配置的决策准确率从78.6%升至90.5%,提高了11.9个百分点,模型调用成本降到了原来的约1/5。
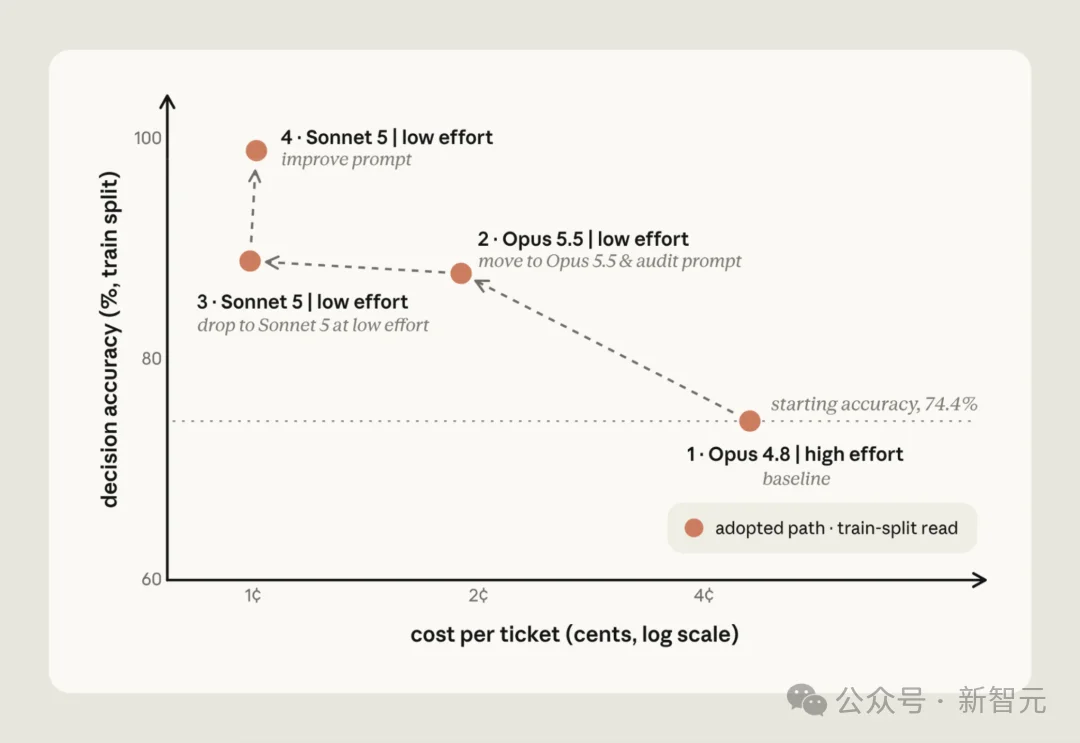
调整模型、思考强度与提示词,改善准确率和成本。图中为迭代集成绩。
不过,这是一组特定配置、特定小样本下的结果,并不意味着接上这套流程,你的应用也能省八成。
这里比较的模型调用成本,也不能当成整个项目的总成本。
但这对于自己掏腰包付API费用的个人开发者来说,仍然很有吸引力。
毕竟便宜的模型如果老是答非所问,逼得用户反复追问,最后还要你人工介入,未必划算。
而简单问题如果也用昂贵的配置,顺带生成一大段不必要的解释,同样可能花冤枉钱。
现在,你可以把回答质量和调用成本放在一起测试,让AI在满足质量要求的前提下,尝试更省钱的方案。
不过,调优本身也要消耗模型调用费用。
先定好愿意掏多少实验费,再决定让AI跑几轮,才更踏实。
当这套自动化流程跑起来后,你就有机会少做一些重复的提示词修补,把精力放回产品本身。
首先,是洞察用户。
你觉得理所当然的操作,第一次打开应用的人可能连入口都找不到。你要做的,是把这些真实发生的困惑补充进题库,AI的下一次优化才会更接地气。
其次,是把控标准。
回答再客气,没解决问题,能算过关吗?意思明明相同,只是换了种说法,评分器会不会误判?
评分标准本身要是有漏洞,AI忙活半天,可能只是分数涨了,用户的问题却还在。
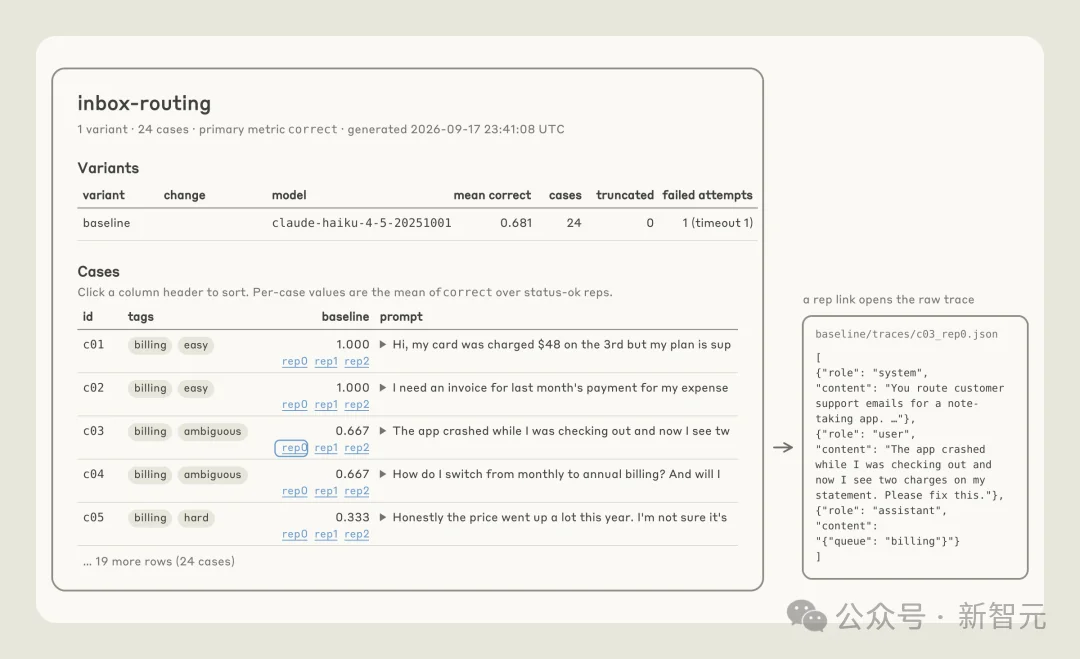
邮件分类评测:左侧查看各题得分,右侧回看模型输入与回答,核查评分是否合理。
最后,是做权衡。
回答精简会不会漏掉必要步骤?追求便宜会不会牺牲准确度?这些关乎用户体验的关键取舍,依然需要你来拍板。
给应用接入AI,初衷是为了省心。
如果最后演变成你全天候陪着它改答案,就本末倒置了。
当Claude能多接手一些重复调试,普通开发者就能多花时间打磨自己的小工具、小应用,让那些搁置的想法重新往前走。
参考资料:
https://claude.dev/blog/automating-eval-design-and-hillclimbing/?utm_source=chatgpt.com
文章来自于"新智元",作者 "元宇"。

【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
