
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
一边打游戏,一边给自己升级?
好家伙,华为这波直接让AI学会了《边玩边变强》啊?!
最新一项研究,华为诺亚方舟实验室联合UCL等团队拿出了一个名叫Memento 3的AI智能体系统——
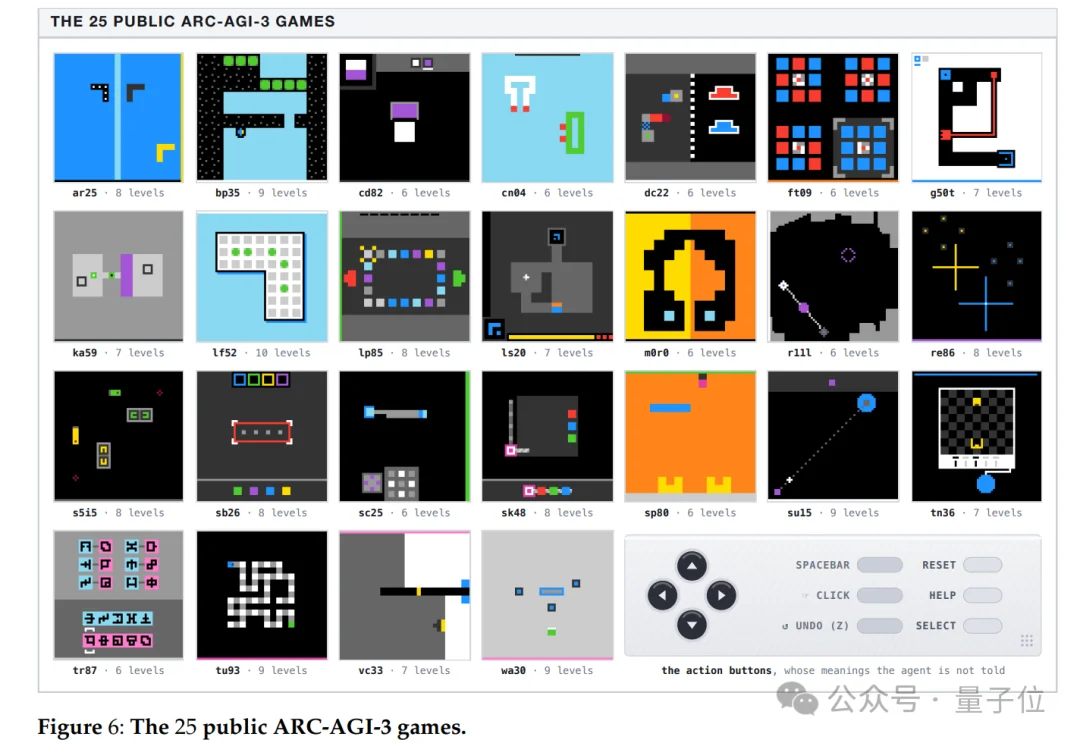
直接把ARC-AGI-3公开集里的25款游戏、183个关卡,全部打通了。
还不是靠无脑试错硬闯过去的。
人类完成同样一套关卡,需要17135次操作。
而Memento 3只用了7518次,比人类少操作约56%,最终拿下了满分100的RHAE成绩(Relative Human Action Efficiency,相对人类行动效率)。
更离谱的是,这套系统以Claude Opus 5为底模,全程没有更新模型权重,也没有针对游戏进行微调。
它就这么自己上手玩,自己琢磨规则,自己写代码,玩错了还会反思、修改。
然后就……满分通关了。
作为对比,Claude Opus 5在ARC Prize官方标准测试框架下,平均RHAE只有约40.7分。
同样的底模,换了套智能体系统,成绩居然直接飙升了59.3分。
还没完。
这套方法不光能玩解谜游戏,研究团队还让它跑去打了Atari经典游戏Pong(乒乓球)。
结果,AI自己摸索出控制策略,随后不用再向大模型请求推理,就连续三局把对手打成了21:0。
不是,大模型都不参与后续操作了,游戏居然还能打得这么溜?!
关键就藏在这项研究的题目里:
Model-Based Recursive Self-Improvement,基于世界模型的递归自我改进。
先说说这25款游戏到底什么来头。
它们来自ARC Prize推出的ARC-AGI-3,关注AI评测的朋友,对ARC系列应该不陌生。
但这一代有个非常明显的变化:
不再只是出题解题那一套了,这次是直接把AI扔进陌生的游戏世界。
规则,是需要AI自己猜的;目标,是需要AI自己找的;操作会产生什么效果,是需要AI自己试的。
AI:合着全都靠我呗~
这25款公开游戏一共包含183个关卡,画面大多由简单的像素、方块、颜色和图形组成。
乍一看,甚至有点像几十年前的小游戏合集。
但可别被这朴素的画风骗了。
对AI来说,怎么操作不是最难的,最麻烦的是压根不知道这个世界怎么运转。
踩上特殊地板会发生什么?一扇门打不开,是颜色没对上,还是形状不匹配?
更麻烦的是,后面的关卡还可能出现新规则,把之前摸索出的经验全部推翻。
别说AI了,人类玩家也会卡住。
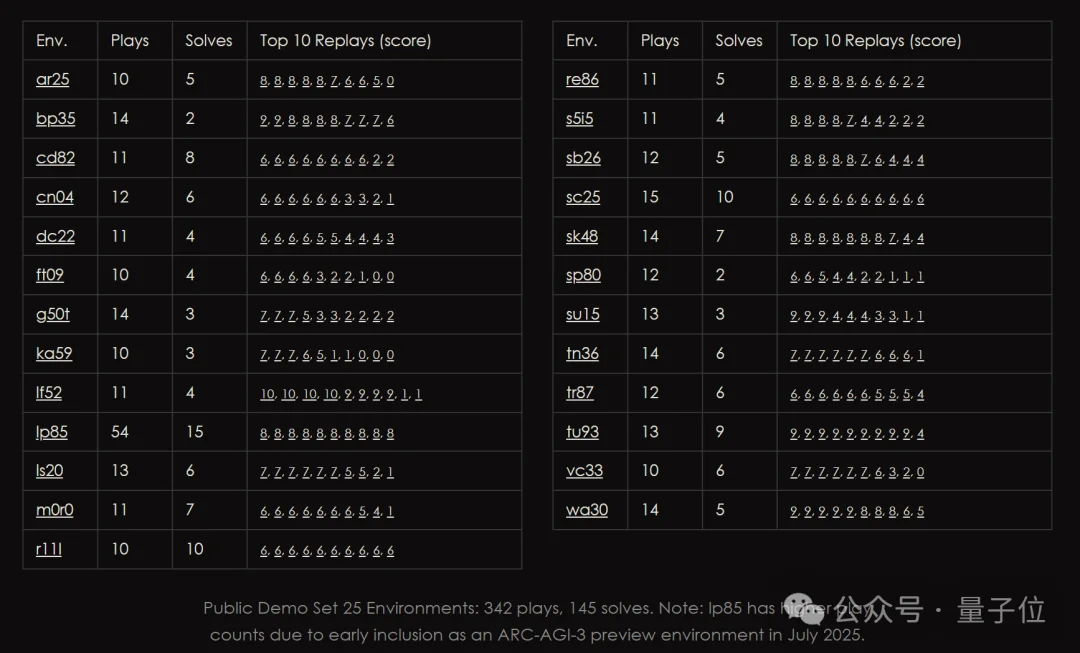
ARC Prize的测试数据显示,在一款需要操控变形虫移动、变色的益智游戏r11l中,10名参与者全部通关;而另一款考验符号破译能力的解谜游戏tr87,12人挑战,只有6人成功。
在华为AI之前,各路研究团队就已经卷得相当激烈了:
普林斯顿大学推出的Continual Harness只通关了3款游戏,拿下20.5分。
英伟达研究人员参与开发的DreamTeam稍好一些,通关6款,得分38.1。
再往上,独立研究者David Courtis开发的OPINE-World,以及英伟达团队的NOOA,分别拿到了78.4分和85.1分。
最猛的是独立开发者Sergey Rodionov的baseline1,不仅把25款游戏全部打通,还拿到了99分,距离满分只差1分。
但华为团队这次,直接把最后这1分也补上了。
Memento 3不仅以100分的成绩通关全部25款游戏、183个关卡,还把总操作次数压到了7518次,比baseline1的8347次又少了829次。
不光通关了,而且还用更少的步骤通关。
怎么做到的??
翻了下论文,Memento 3的核心方法叫Code as Model(代码即模型)。
听着有点抽象,其实就是让AI在玩游戏的过程中,给自己准备两样东西:
一本不断更新的游戏攻略,以及一套能模拟游戏运行的代码。
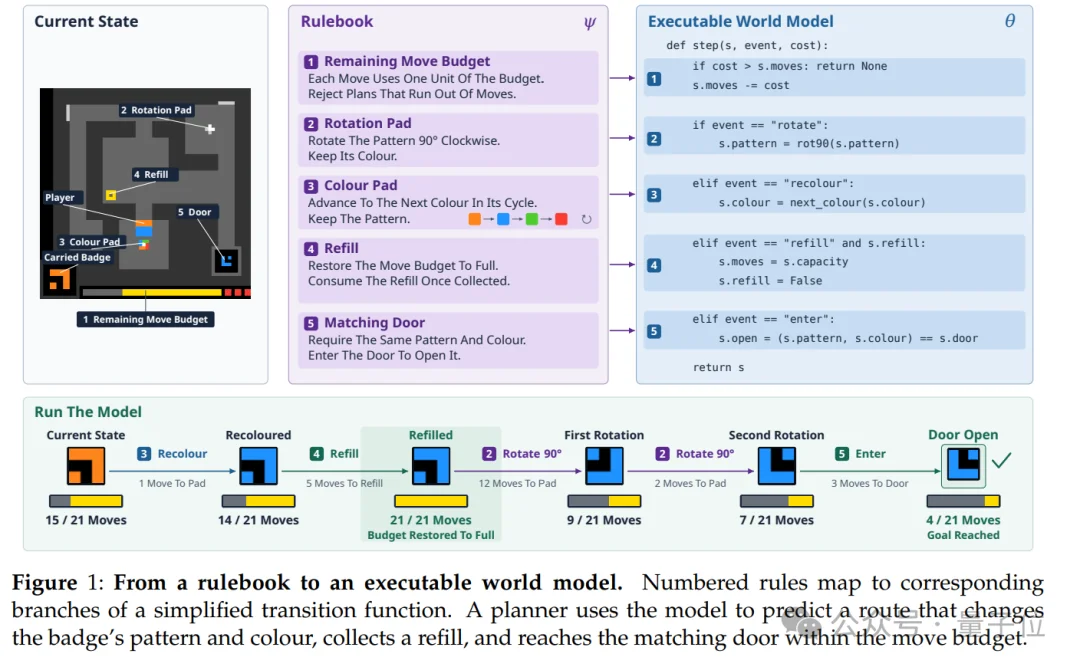
有了这两样东西,AI就能先在自己搭建的模拟器里推演不同路线,再决定下一步怎么走。
但问题来了,万一一开始理解的游戏规则就是错的呢?
别急,Memento 3不仅会自己写攻略,发现写错了,还能自己推翻重来。
论文里就展示了一个例子。
AI在一款解谜游戏中遇到特殊地板,起初以为踩上去后,角色携带的图案会根据进入方向发生镜像翻转。
结果真正试过才发现,图案不是翻转,而是顺时针旋转90度,并且与进入方向无关。
于是AI修改规则手册,对应的Python代码也跟着更新。
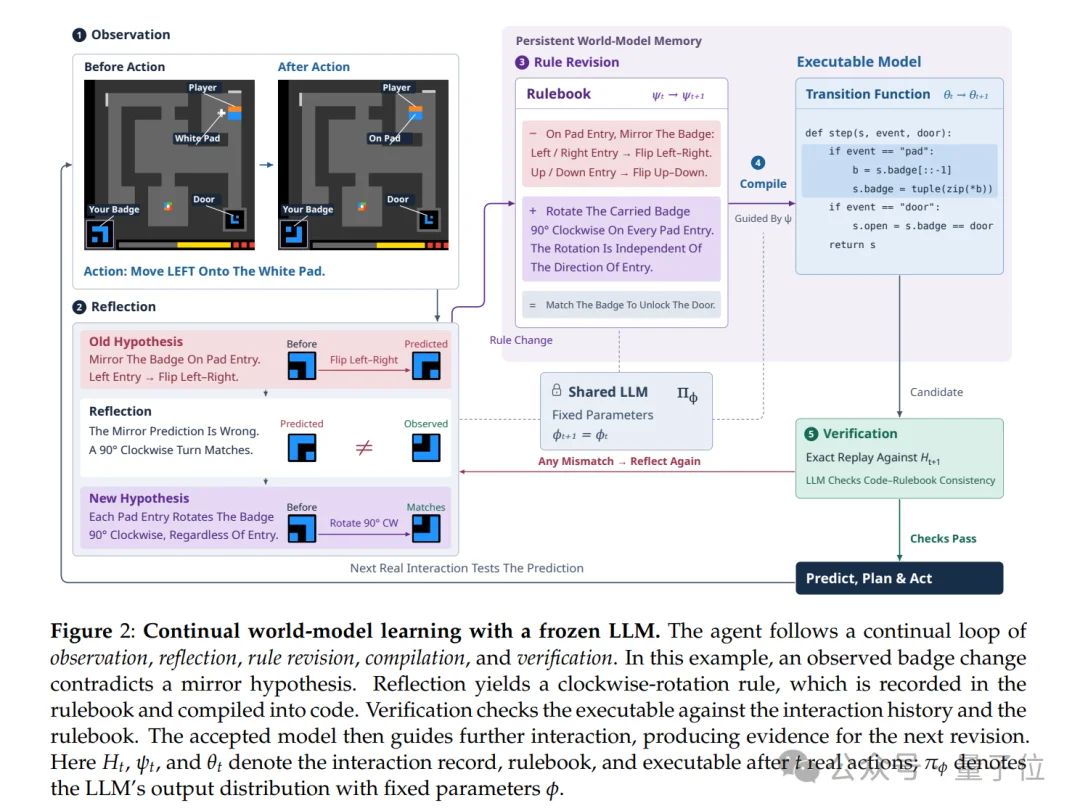
不过,改完还得验。
系统会重新模拟此前的操作,逐格对比64×64的游戏画面,确认代码能准确复现真实结果。
对不上,就继续改。
就这样,AI一边探索,一边纠错,规则越改越准。
而且前面学到的经验,还能带到后面的关卡。
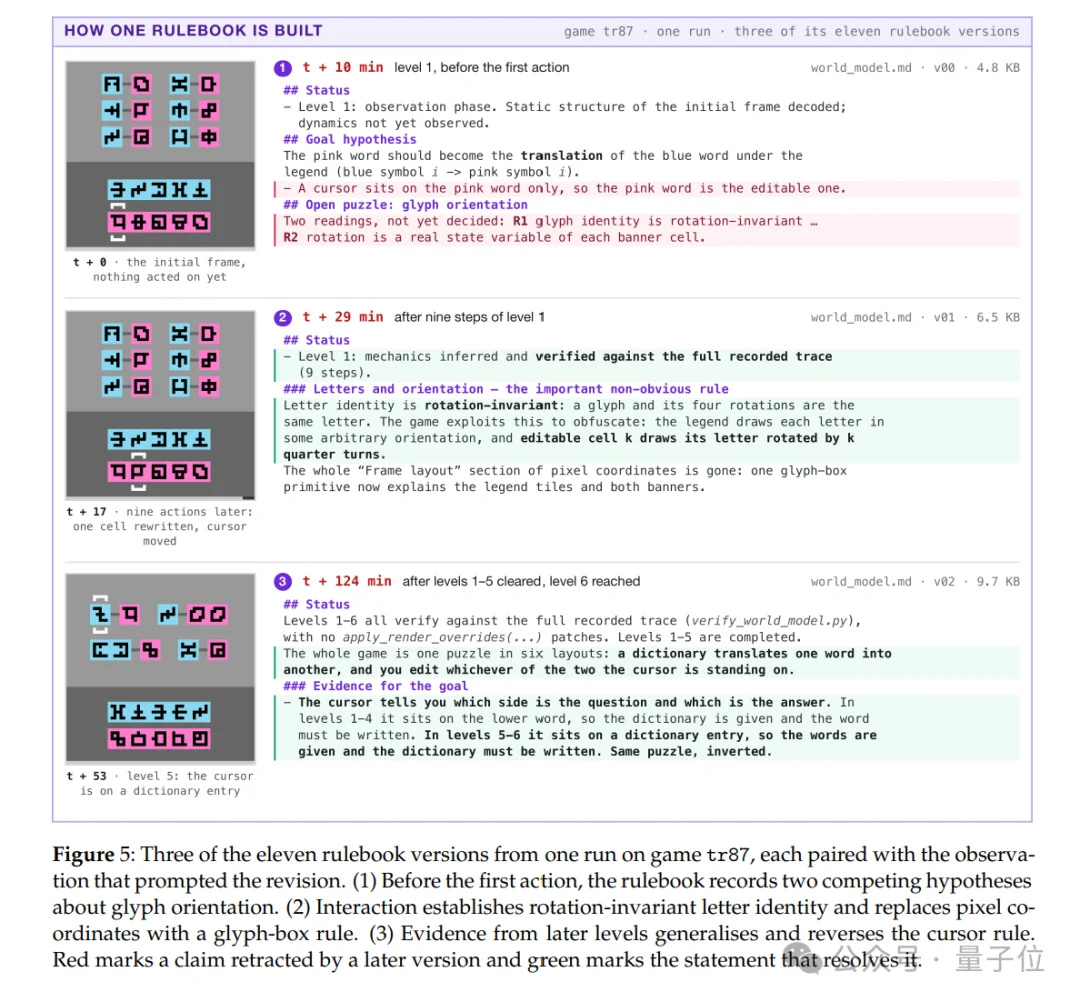
比如符号解密游戏tr87,AI最初分不清符号朝向是否影响含义,后来发现不同方向的符号可能代表同一个字母。
随着新关卡出现,它又推翻了之前对游标位置的理解。
整场游戏下来,同一份规则手册迭代了11个版本。
为了方便回溯,研究团队甚至引入了Git版本管理。
每次修改规则和代码都会留下记录,发现哪里改错了,还能翻看历史版本,必要时直接恢复。
好家伙,打个游戏还顺手维护起代码仓库了。
这也正是研究团队所说的递归自我改进(RSI)。
大模型参数不用动,AI通过不断积累经验、修改规则和代码,就能让自己越玩越熟练。
而且,这套方法还真有数据支撑。
研究团队在三款游戏中做了对照实验:
保留规则手册时,AI总共用了617次操作;去掉规则手册,只保留代码世界模型,则需要677次。
相当于有了这本攻略,操作次数减少约9%,智能体执行轮次也减少了约18%。
但研究团队还不满足于此。
既然一个世界模型能帮助AI少走弯路,那同时用两个呢?
于是,他们让AI同时维护两套世界模型,共享游戏操作记录,但各自推演不同的规则假设。
结果,在游戏wa30中,单世界模型需要899次操作才能通关,换成双世界模型后,直接降到了597次。
操作次数又减少了约34%。
当然,这一提升目前只在wa30上得到验证,还不能直接推广到其他游戏。
但至少在这些实验里,Memento 3证明了一件事:
不用重新训练大模型,AI也能靠不断修正自己对世界的理解,越玩越强。
那这套方法只能用来玩解谜游戏吗?
研究团队决定再加点难度,直接把Memento 3拉去挑战经典街机游戏Atari Pong(乒乓球)。
和前面的解谜游戏不同,这次小球会不断移动、反弹,AI不仅要摸清游戏规则,还得实时判断球的运动轨迹,控制球拍接球。
结果这一试,还真试出了点新东西。
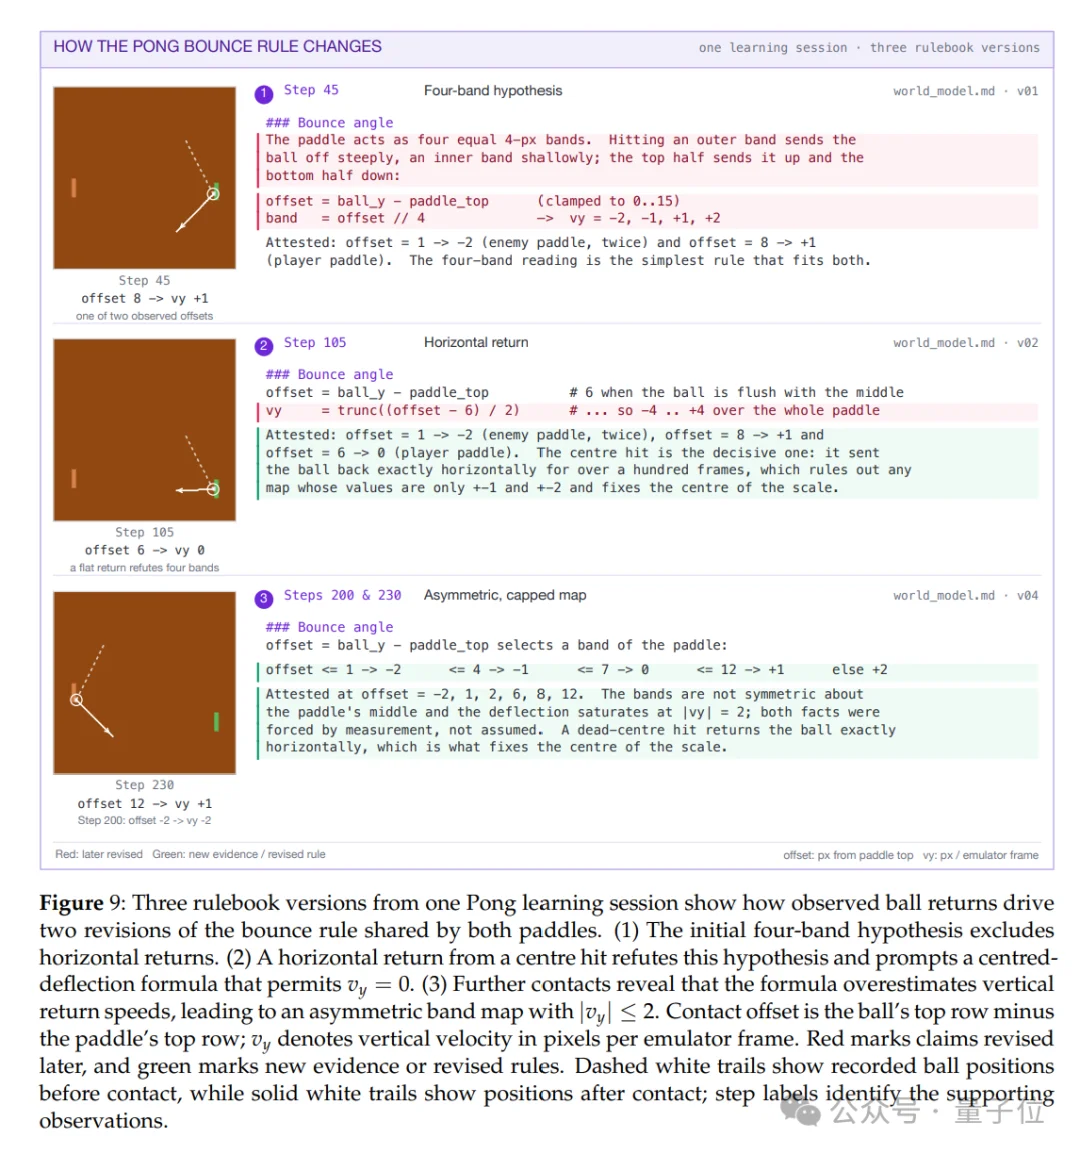
一开始,AI同样不知道球的反弹规律,只能边打边摸索。
它最初以为,球拍可以分成四个区域,小球打在不同位置,就会朝对应方向弹出去。
结果打着打着,突然出现了一次水平反弹。
诶?这和之前总结的规则对不上啊。
于是AI重新分析碰撞位置,修改反弹公式,后来又遇到新的轨迹偏差,就继续调整,逐渐总结出更符合实际情况的运动规律。
等到控制策略成熟,研究团队干脆让这套程序独立上场。
不再调用Claude Opus 5,也不再更新规则。
结果,三次不同开局,全部打出了21:0。
好家伙,前面还在摸索怎么接球,后面直接把对手打了个零封???
而且注意了,这时候的大模型已经不用亲自上场了。
它只负责前期摸索规则、总结打法,等策略学会了,直接交给代码执行。
作为对比,如果不使用世界模型,只让大模型根据眼前的画面决定下一步怎么操作,最终得分只有-19,和随机乱按的-20.7差不了多少。
这一对比,差距就出来了。
与其让大模型每一步都重新思考,不如先让它学会怎么玩,再把打法交给程序。
而且效率也挺夸张。
论文数据显示,Memento 3大约只用了9500帧游戏画面,就学出了这套控制策略。
相比之下,部分传统强化学习方法往往需要数十万甚至上亿帧训练数据。
当然,这不代表Memento 3没有成本。
毕竟,它背后用的是开启Extra-High推理强度的Claude Opus 5,探索、生成代码和验证的过程,都需要消耗不少Token和算力。
而且目前实验主要针对规则相对明确的游戏环境,如果换成更加复杂、多变的现实世界,这套方法还能不能奏效,仍有待验证。
不过,这项研究倒是指出了一个值得关注的方向:
递归自我改进(RSI)并不一定要动模型底层权重。通过构建可检查、可执行、可回滚的外部世界模型,冻结参数的通用大模型同样能在陌生领域里自我迭代、迅速进化。
论文地址:
https://arxiv.org/abs/2610.11794
参考链接:
https://x.com/ScarletKc/status/2109169173540884935
文章来自于"量子位",作者 "一水"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
