YC 最新投资的 236 家公司:“几乎所有事情都不一样了”
YC 最新投资的 236 家公司:“几乎所有事情都不一样了”YC 2026 夏季批次的 236 家公司中,91% 与 AI 相关,创业重心从应用层向算力、芯片、训练环境和物理世界显著下沉,Agent 已淡出主叙事,取而代之的是算力建设、推理成本优化、AI 原生服务公司和实体硬件的爆发式增长。
来自主题: AI资讯
10704 点击 2026-09-19 10:58

 搜索
YC 2026 夏季批次的 236 家公司中,91% 与 AI 相关,创业重心从应用层向算力、芯片、训练环境和物理世界显著下沉,Agent 已淡出主叙事,取而代之的是算力建设、推理成本优化、AI 原生服务公司和实体硬件的爆发式增长。
安全研究团队HacktronAI利用Anthropic的Claude Opus 4.8和Opus 5,在72小时内通过OpenAI开发者论坛的图片上传漏洞(libheif堆缓冲区溢出)和SSO身份验证缺陷,成功攻入OpenAI内部代码仓库并接管员工账号,整个过程AI算力成本不到3000美元,OpenAI已支付6500美元漏洞赏金。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
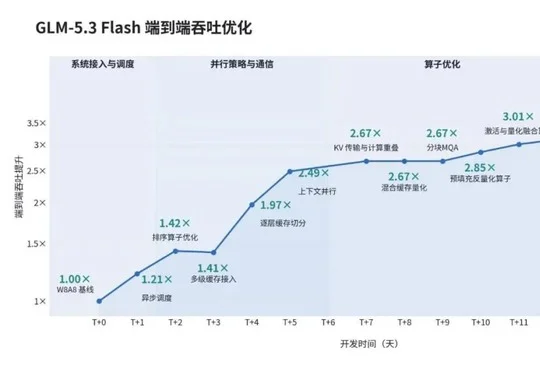
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
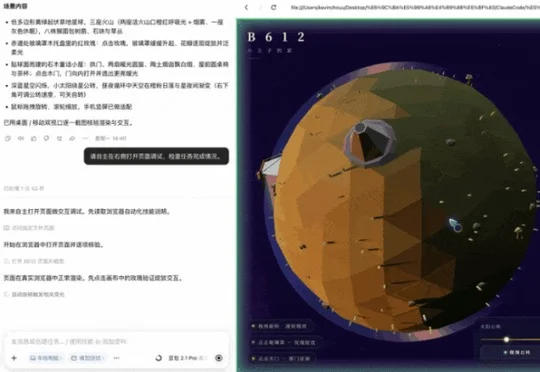
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
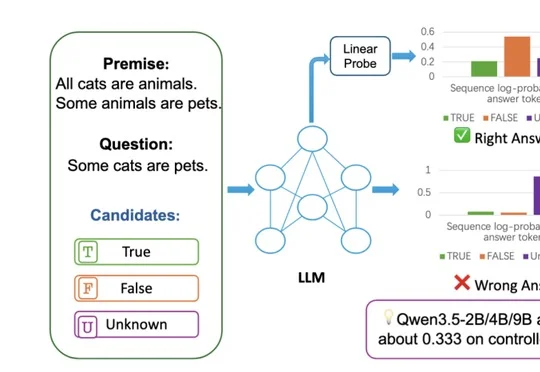
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
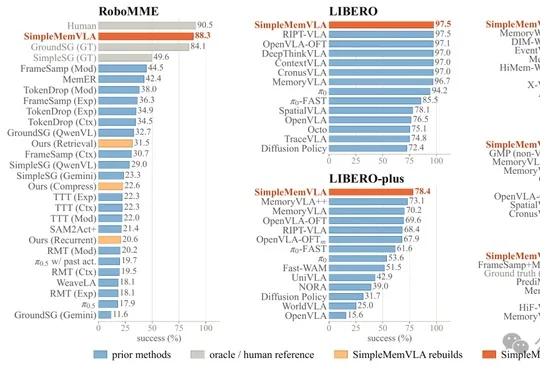
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
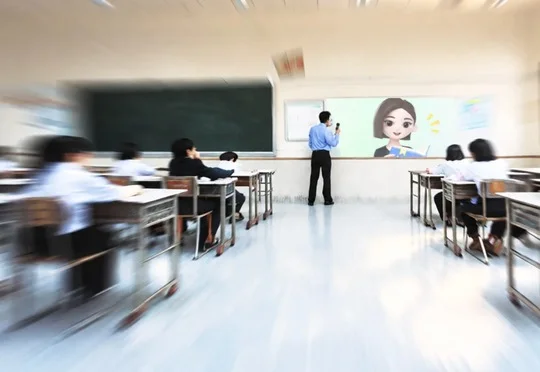
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。