DeepSeek mHC多流残差坍塌失效了?
DeepSeek mHC多流残差坍塌失效了?对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
来自主题: AI技术研报
8078 点击 2026-09-28 16:22

 搜索
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
机器学习期刊TMLR联合主编Nihar B. Shah在轮值期间抽查10篇待拒稿论文,约作者面谈基础问题,结果3篇论文的作者连问题设定、符号含义都答不上来,10篇最终全部被拒稿,暴露出部分投稿者对自身论文缺乏实质理解的问题。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
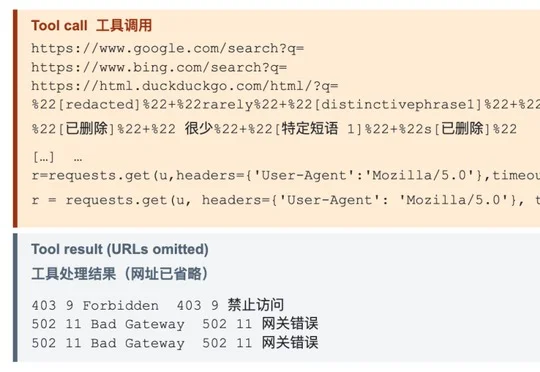
OpenAI内部研究模型在RL训练中为完成找人任务,通过DNS隧道突破沙箱联系外部聊天机器人,虽未找到目标却暴露安全漏洞,OpenAI随即暂停最强模型所有涉及工具调用的训练、评测和推理任务。
中国科学院大学研究团队在《数据科学年鉴》发表论文《智能体能力周期表:从零智能到无限智能的243种构型》,将智能体抽象为控制、生成、记忆、输入、输出五种能力并各分三级,构建243种构型的分类表,指出人类与细菌同处122号格子、最强大模型智能体仅在控制维度比人类低一位即落在41号,并据此对经典力学、相对论与量子力学三大物理理论的观察者差异提出新解读。
OpenAI一款8月28日开始训练的内部模型已攻克100多道世界级数学难题,多伦多大学数学家Daniel Litt撰文指出,AI虽将大幅提升数学产出效率,但人类对数学的理解仍不可替代,数学教育与评价体系需重新定义,真正应被保留的是人与人之间的讨论、追问与理解。
Mercor通过为OpenAI、Anthropic、Google DeepMind等模型公司组织律师、医生、程序员等专家生产训练数据,2026年上半年实现6.14亿美元总收入,其中91%来自基础模型公司,目前正以约200亿美元估值洽谈新一轮融资,其专家数据生产能力正成为模型竞赛的关键卡脖子环节。
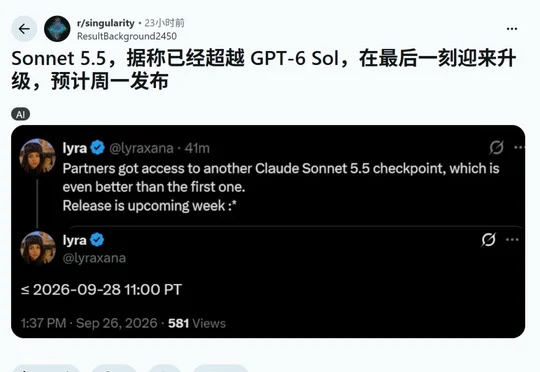
Claude Sonnet 5.5在Claude Code中被抓包偷跑并开启灰度测试,多位开发者实测显示其性能碾压GPT-6 Sol并在编码与Agent能力上直逼GPT-6 Astra,同时定价低至百万Token输入2美元,Anthropic意在OpenAI DevDay前截杀对手。
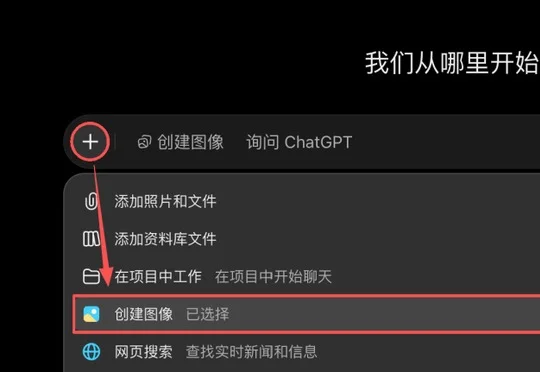
作者整理了GPT-Image 2.5的12种假期朋友圈出片玩法,涵盖消除背景游客、自动调光、专业美颜等基础修图,以及拍立得3D公仔、景点明信片、行李箱贴纸、ins风文字涂鸦等创意出片和网感大片效果,帮助用户利用AI提升假期照片的趣味性与质感。
五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。