500亿元!DeepSeek接近完成第二轮融资,年化营收快速增长
500亿元!DeepSeek接近完成第二轮融资,年化营收快速增长DeepSeek接近完成500亿元人民币的第二轮融资,其年化营收在融资启动后显著增长,且公司近期迎来首任CFO并推进上市筹备工作。
来自主题: AI资讯
9069 点击 2026-09-24 16:12

 搜索
DeepSeek接近完成500亿元人民币的第二轮融资,其年化营收在融资启动后显著增长,且公司近期迎来首任CFO并推进上市筹备工作。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
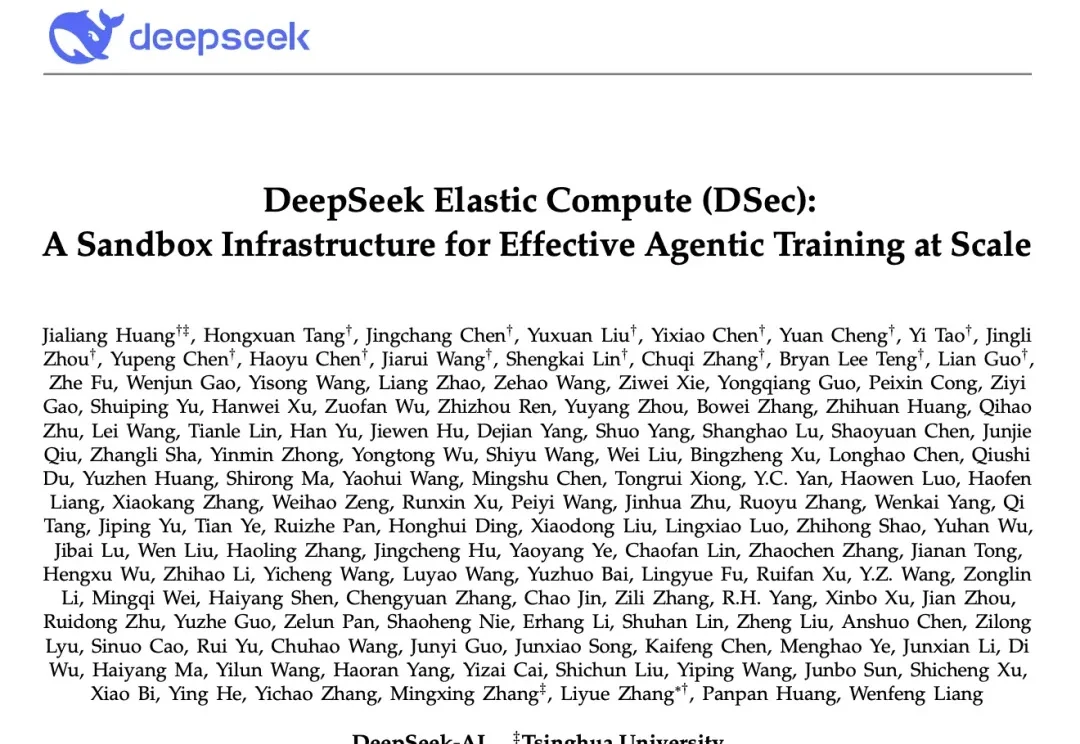
大模型训练拼的是算力,Agent训练拼的是环境。
价格卷过DeepSeek Flash。
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
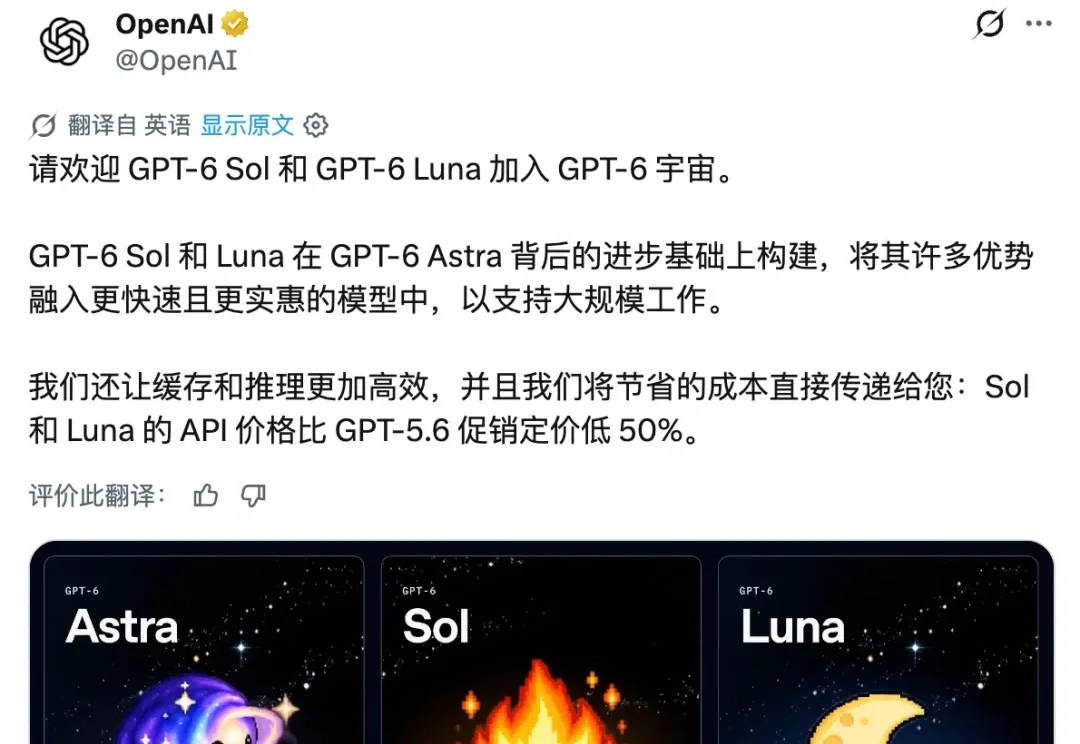
DeepSeek 快醒醒,ChatGPT 要打到家门口了。
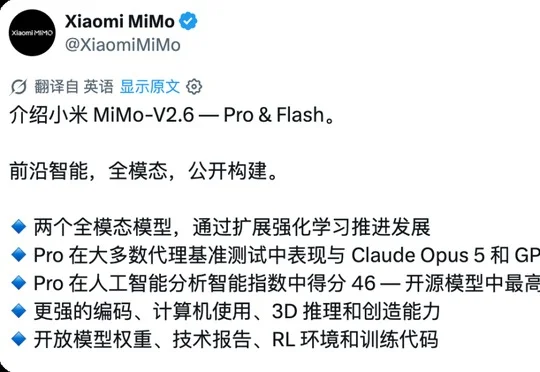
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
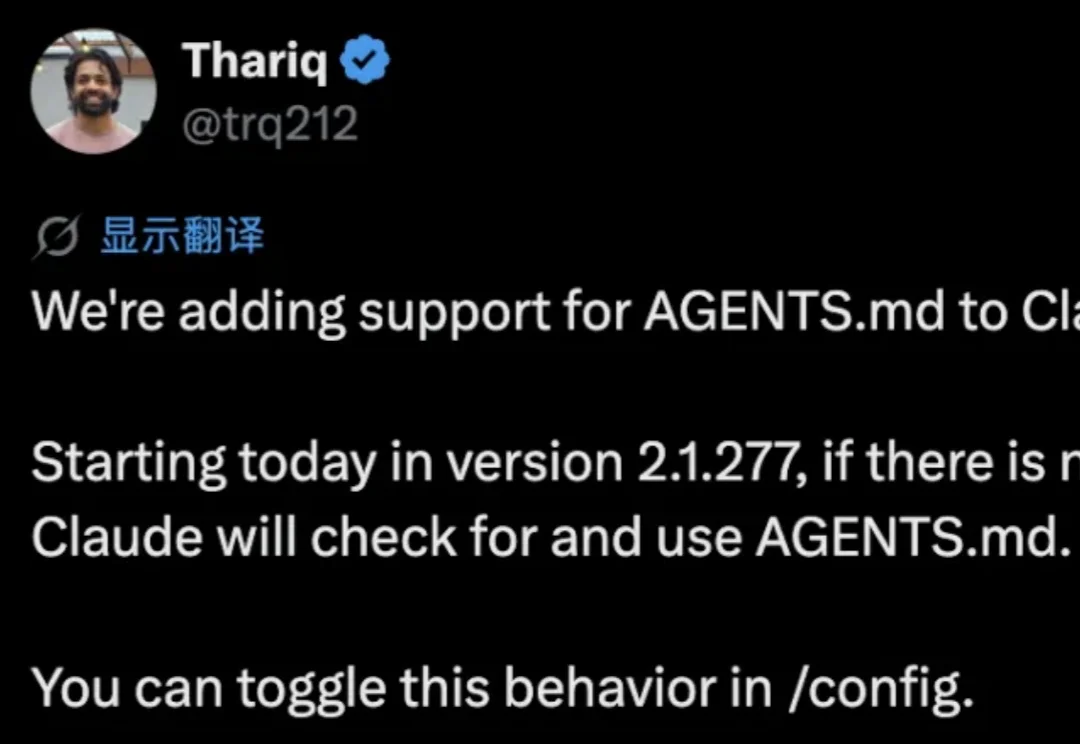
Claude向OpenAI格式投降了。
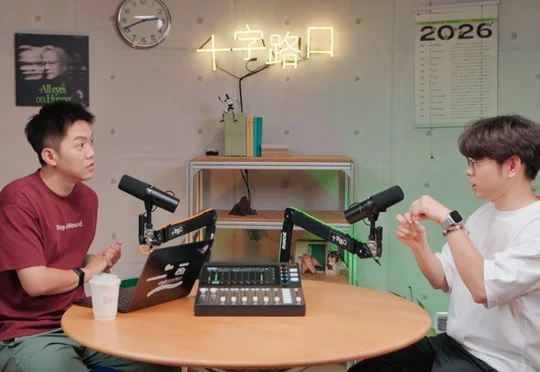
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
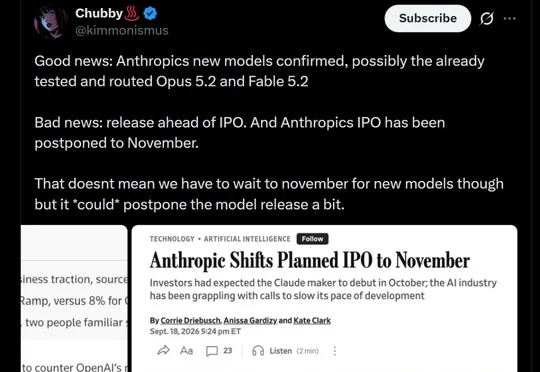
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。