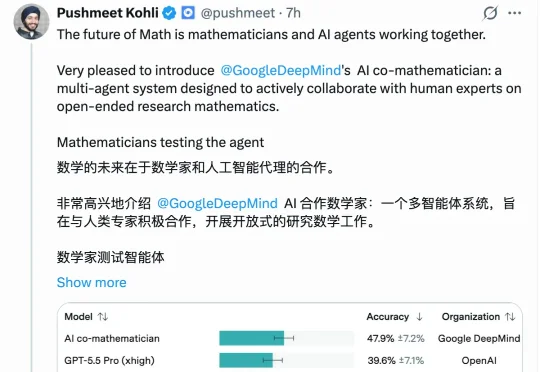
谷歌「AI联合数学家」来了!刷新最难数学AI基准SOTA,牛津教授用它解开群论悬案
谷歌「AI联合数学家」来了!刷新最难数学AI基准SOTA,牛津教授用它解开群论悬案群论领域几十年无解的第21.10号问题,被牛津数学家Marc Lackenby用谷歌一个新系统破解了。过程也很有意思:AI第一次给出的证明是错的,被系统里的审查Agent揪出了漏洞。
来自主题: AI资讯
9546 点击 2026-05-09 13:18

 搜索
群论领域几十年无解的第21.10号问题,被牛津数学家Marc Lackenby用谷歌一个新系统破解了。过程也很有意思:AI第一次给出的证明是错的,被系统里的审查Agent揪出了漏洞。
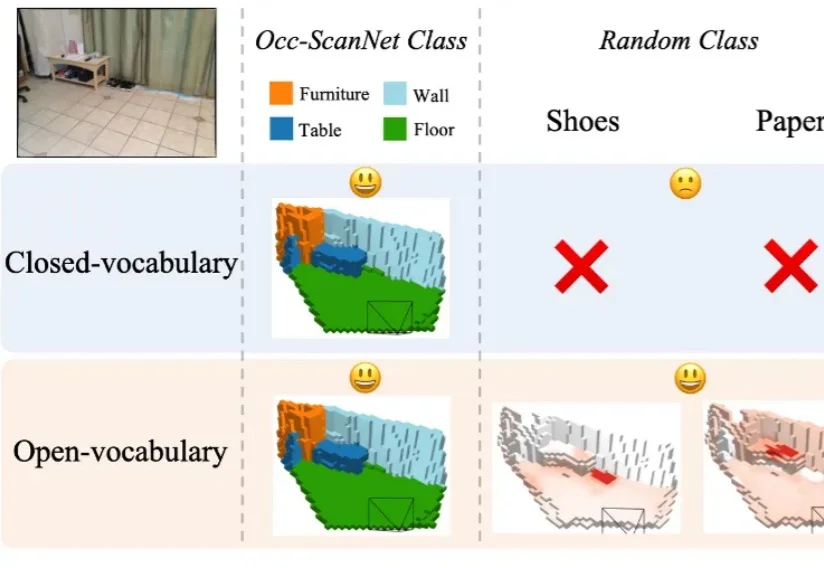
在具身智能研究中,如何让智能体精准理解周围环境的精细几何结构与开放语义信息,始终是具身感知的核心难题。近年来,语义占据预测(Semantic Occupancy Prediction) 将稠密几何与语义信息统一到三维体素网格中,用于构建 3D 语义占据地图,为机器人的空间推理、导航与交互操作提供了场景表达基础。
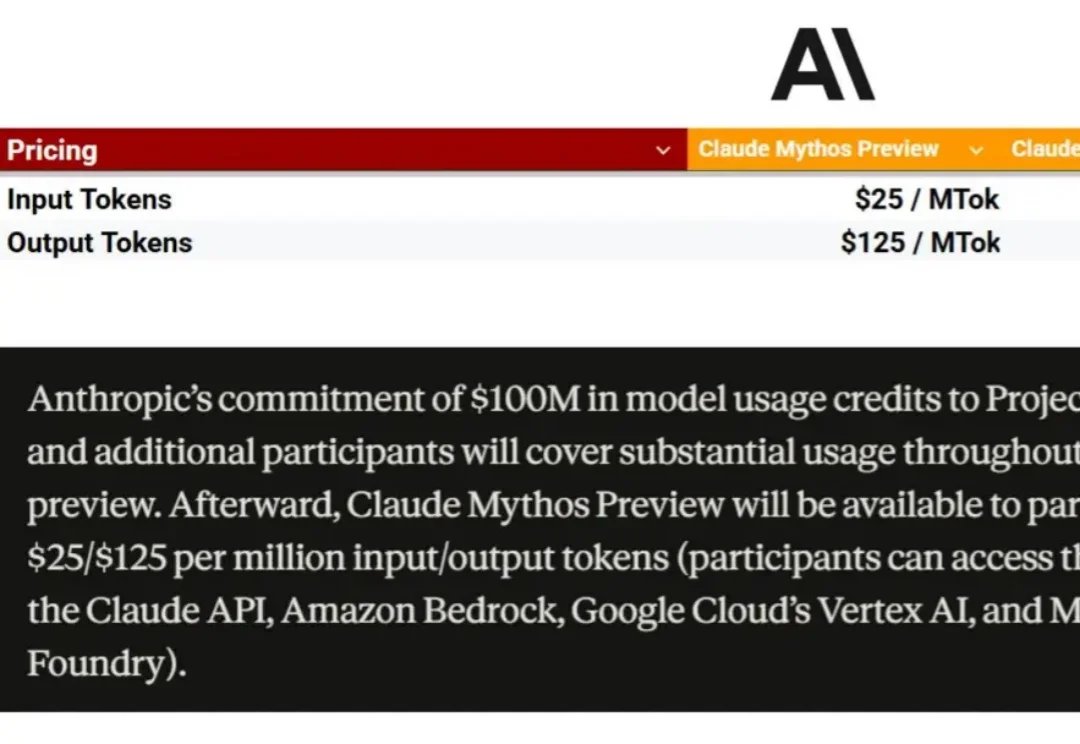
Anthropic 发布了史上最强的模型 Claude Mythos。
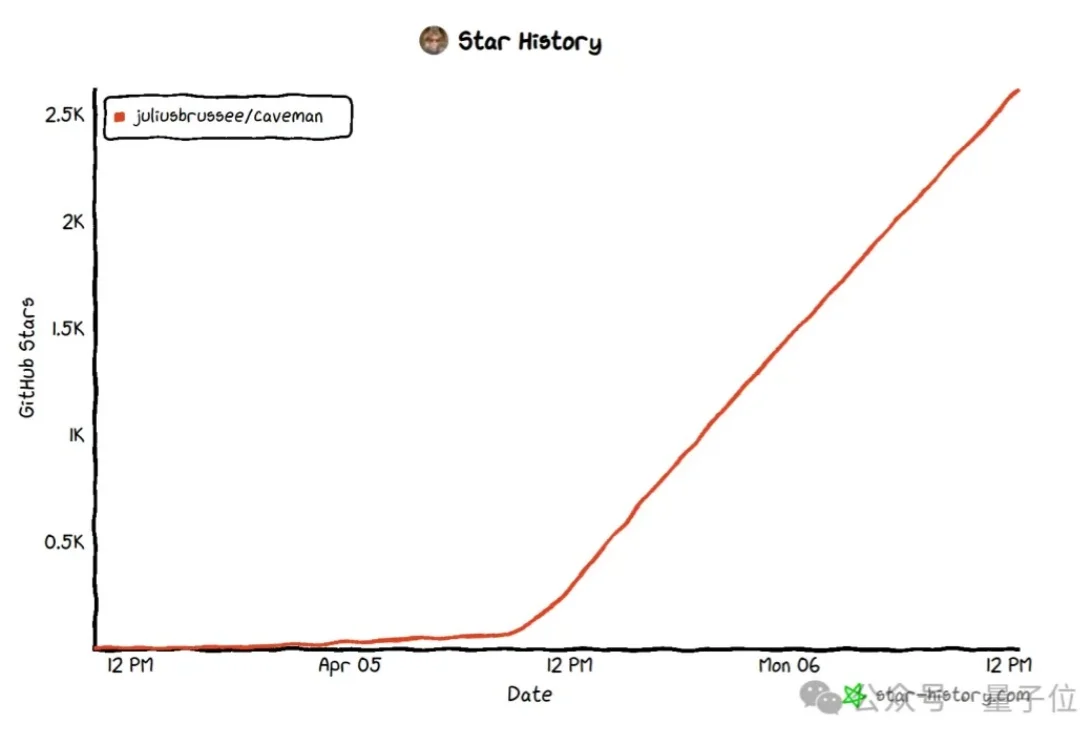
信息无损Token最高节省87%,一款省Token神器正在GitHub蹿红。
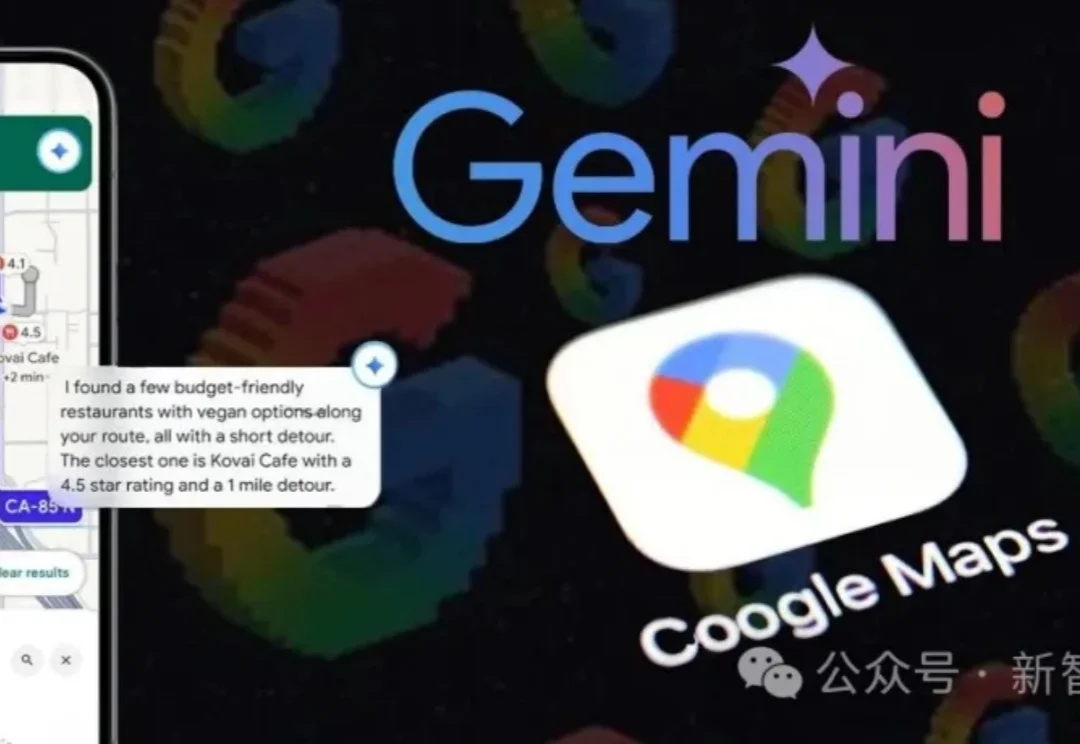
GoogleMaps核弹更新:Gemini接管步行骑行导航!问厕所咖啡馆?问EV充电剩几个坑?问街区Vibe?Gemini秒懂人话、懂物理世界。路痴起立,再也不用举手机转圈自闭了!

最近,谷歌 NotebookLM 又出了个好玩好用的小功能:Cinematic Video Overviews(电影级视频概览)。与普通模板不同,这项功能可以根据我们上传的资料,自动生成定制化、沉浸式的视频讲解。
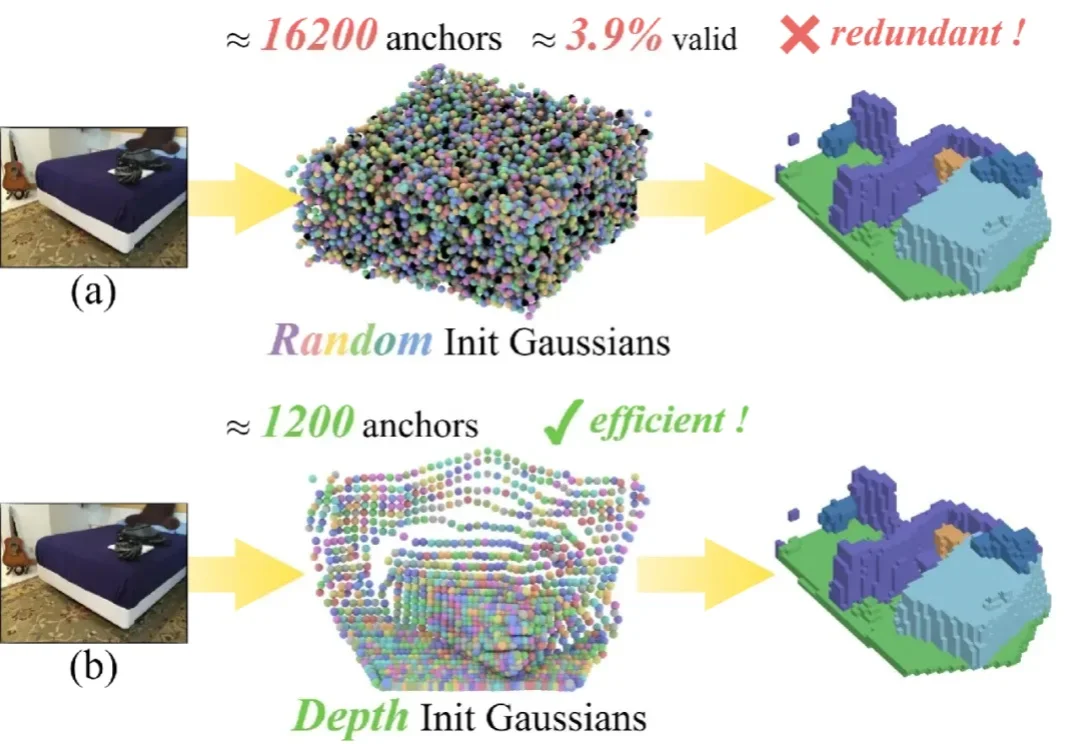
单目 3D 语义场景补全 (Semantic Scene Completion, SSC) 是具身智能与自动驾驶领域的一项核心技术,其目标是仅通过单幅图像预测出场景的密集几何结构与语义标签。
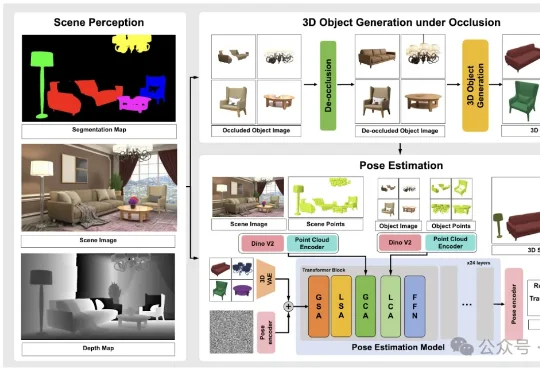
IDEA研究院张磊团队与香港科技大学谭平团队联合推出SceneMaker框架,有望攻克这一问题。 它以视启未来的万物检测模型DINO-X与光影焕像的万物3D生成模型Triverse为基础,实现了从任意开放世界图像(室内/室外/合成图等)到带Mesh的3D场景的完整重建。
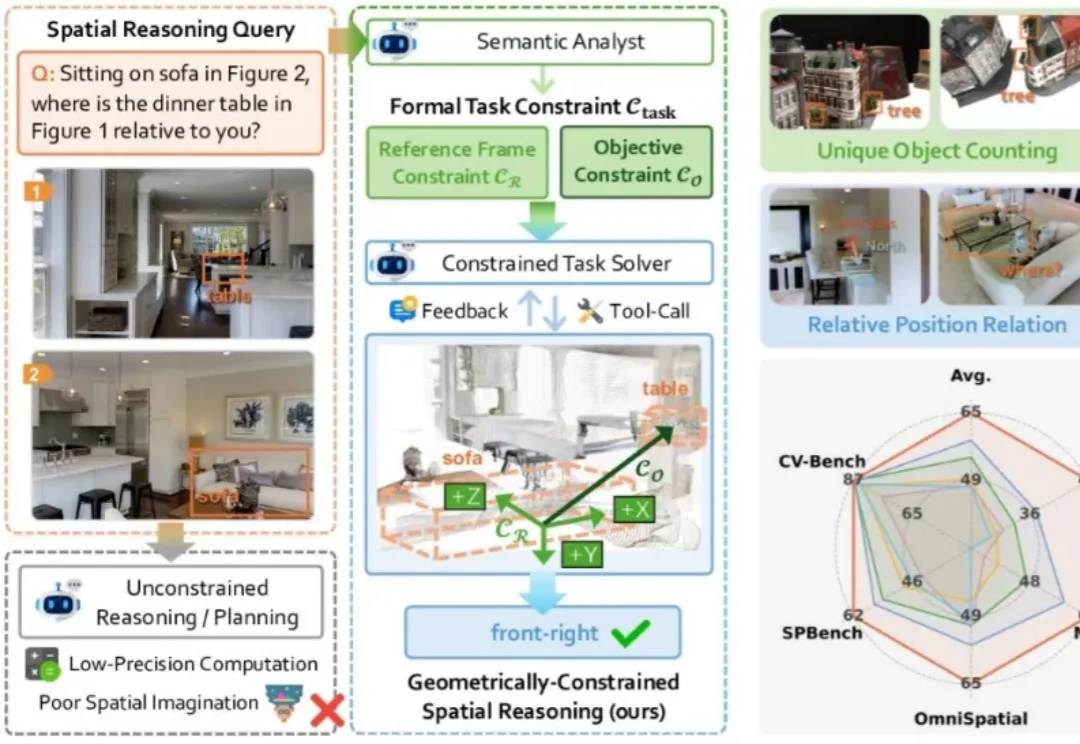
现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。

今天聊一聊怎么在RAG、agent场景中实现语义高亮(Semantic Highlight)。