FlashAttention-4正式发布:算法流水线大改,矩阵乘法级速度
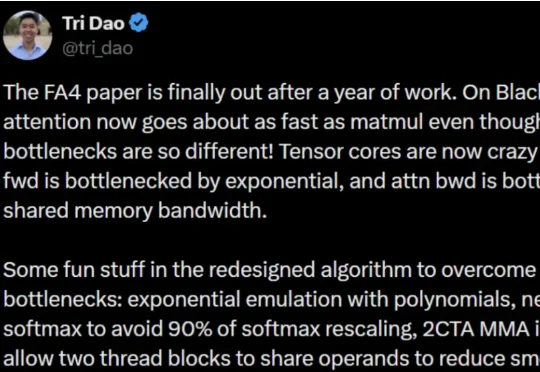
FlashAttention-4正式发布:算法流水线大改,矩阵乘法级速度近日,深度学习领域重要底层优化技术 FlashAttention 迎来大版本更新。FlashAttention 核心作者、普林斯顿大学助理教授 Tri Dao 表示,在 Blackwell GPU 上,即使瓶颈截然不同,注意力机制的执行速度现在也几乎与矩阵乘法一样快了!
搜索
近日,深度学习领域重要底层优化技术 FlashAttention 迎来大版本更新。FlashAttention 核心作者、普林斯顿大学助理教授 Tri Dao 表示,在 Blackwell GPU 上,即使瓶颈截然不同,注意力机制的执行速度现在也几乎与矩阵乘法一样快了!
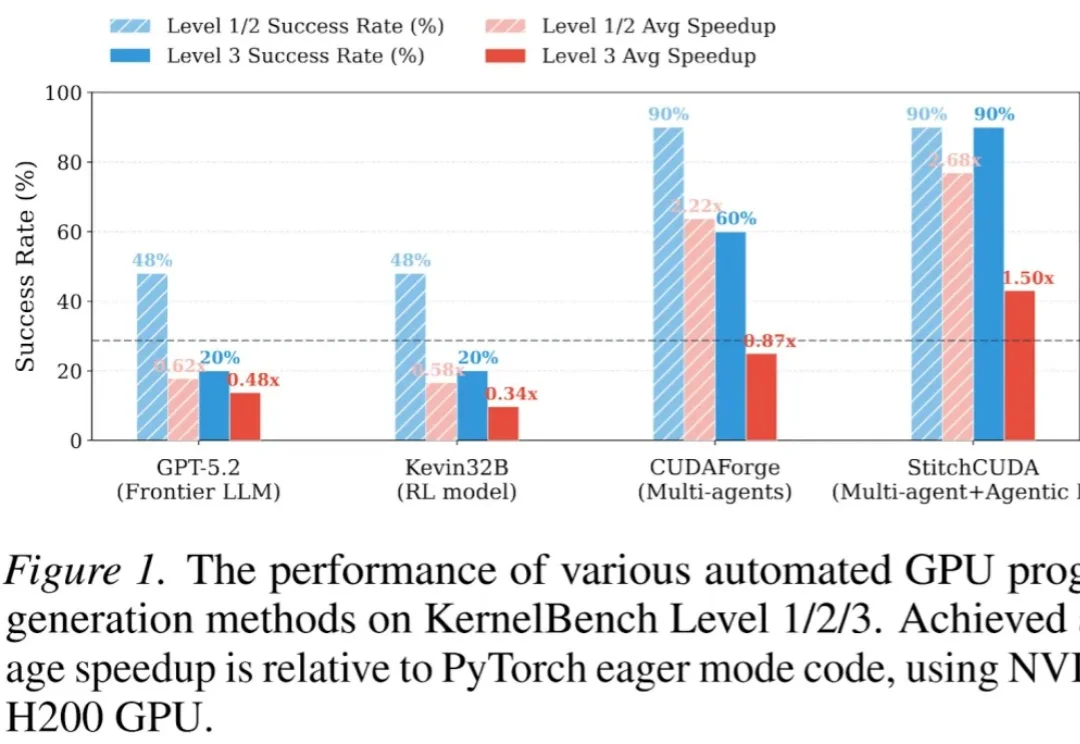
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。
让AI自己写高性能GPU代码,字节Seed与清华AIR团队做到了。
据悉,在即将开幕的3月圣何塞GTC大会上,黄仁勋将发布一套全新的AI推理系统—— 核心是一颗专为推理优化的新芯片。而且芯片的首位大客户已经敲定,就是刚刚完成1100亿美元巨额融资的OpenAI。
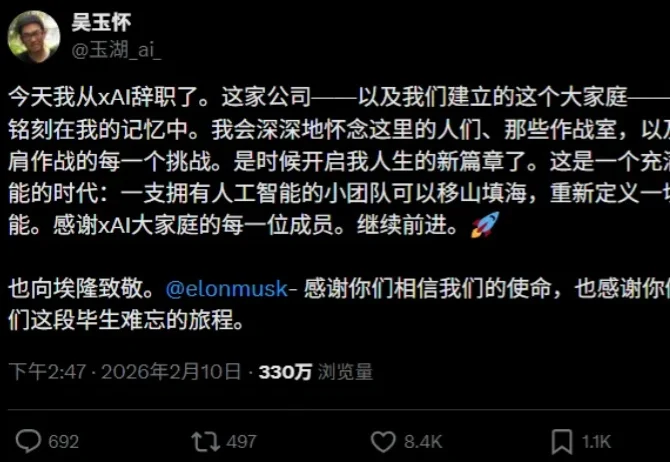
当地时间 2 月 10 日和 11 日,xAI 的联合创始人 Tony Wu 和 Jimmy Ba 先后在社交平台 X 上宣布离职,这是继 Igor Babuschkin、Christian Szegedy 等人之后,xAI 创始团队在不到三年内的又一次核心人员变动。截至目前,xAI 最初 12 人的创始团队中已有六位成员离开。
首个统一系统:将物理机器人提升为与 GPU 同等的计算资源,打破硬件隔阂。
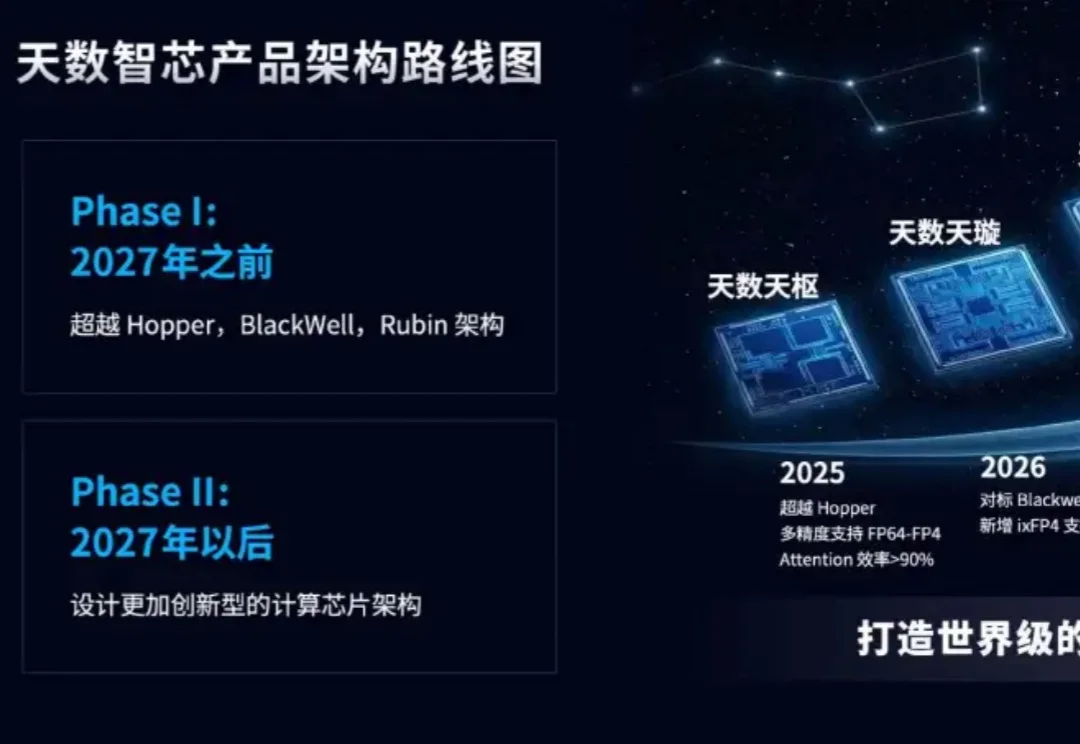
对于国产 GPU 行业来说,没有哪个时间节点比当下更宝贵。在政策支持硬科技企业上市的背景下,国产 GPU 迎来了难得的上市黄金窗口期。但上市并非终点,在敲钟的那一刻,下一战场大幕已经拉开——GPU 厂商的技术路线、产品能力和长期判断,被放到了更公开也更严苛的舞台上,谁能撑起资本市场和大众期待,谁就能撑起市值。
10倍速度,重写单位经济:Fal.ai 通过自研推理引擎和极致的软件优化,实现比主流方案快一个数量级的推理速度。商业指标惊人。据Sacra估算,Fal在2025年7月达到约9500万美元年化收入run rate,较2024年7月约200万美元同比约4650% 。技术优势完全转化为市场无法忽视的经济优势。
英伟达正通过重磅布局服务器CPU领域,进一步巩固其在AI基础设施市场的统治地位。
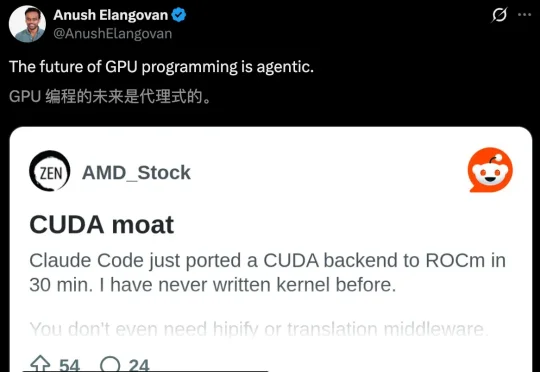
英伟达护城河要守不住了?Claude Code半小时编程,直接把CUDA后端迁移到AMD ROCm上了。 一夜之间,CUDA护城河被AI终结了? 这几天,一位开发者johnnytshi在Reddit上分享了一个令人震惊的操作: