从未见过现实世界数据,MIT在虚拟环境中训练出机器狗,照样能跑酷
从未见过现实世界数据,MIT在虚拟环境中训练出机器狗,照样能跑酷如今,机器人学习最大的瓶颈是缺乏数据。与图片和文字相比,机器人的学习数据非常稀少。目前机器人学科的主流方向是通过扩大真实世界中的数据收集来尝试实现通用具身智能,但是和其他的基础模型,比如初版的 StableDiffusion 相比,即使是 pi 的数据都会少七八个数量级。
来自主题: AI技术研报
9802 点击 2024-11-18 09:14

 搜索
如今,机器人学习最大的瓶颈是缺乏数据。与图片和文字相比,机器人的学习数据非常稀少。目前机器人学科的主流方向是通过扩大真实世界中的数据收集来尝试实现通用具身智能,但是和其他的基础模型,比如初版的 StableDiffusion 相比,即使是 pi 的数据都会少七八个数量级。

今日凌晨,Stability AI 发布了 Stable Diffusion 3.5 的提示指南。该指南提供了 Stable Diffusion 3.5 的实用提示技巧,让使用者能够快速准确地完善图像概念,更好地使用 Stable Diffusion 3.5 这一在可定制性、高效性能、多样化输出和多功能风格方面均表现出色的模型。

大模型理解复杂表格,能力再次飞升了! 不仅能在不规则表格中精准找到相关信息,还能直接进行计算。
现在正是多模态大模型的时代,图像、视频、音频、3D、甚至气象运动都在纷纷与大型语言模型的原生文本模态组合。而浙江大学及其计算机创新技术研究院的一个数十人团队也将结构化数据(包括数据库、数仓、表格、json 等)视为了一种独立模态。
过去 24 小时内发布或更新的 AI 服务包括但不限于 Stable Diffusion 3.5 最强模型全家桶、能操作用户电脑的 Claude 3.5 Sonnet、Genmo 开源的可商用的 Mochi 1 DiT、Runway 推出的一款生成式角色表演工具…… 以及我们这里要介绍 Ideogram Canvas,一款基于 AI 的无限创意画板服务,可用于组织、生成、编辑和组合图像。
就在刚刚,Stability AI发布了自家最强的模型Stable Diffusion 3.5,而且是一个全家桶,包含三个版本。
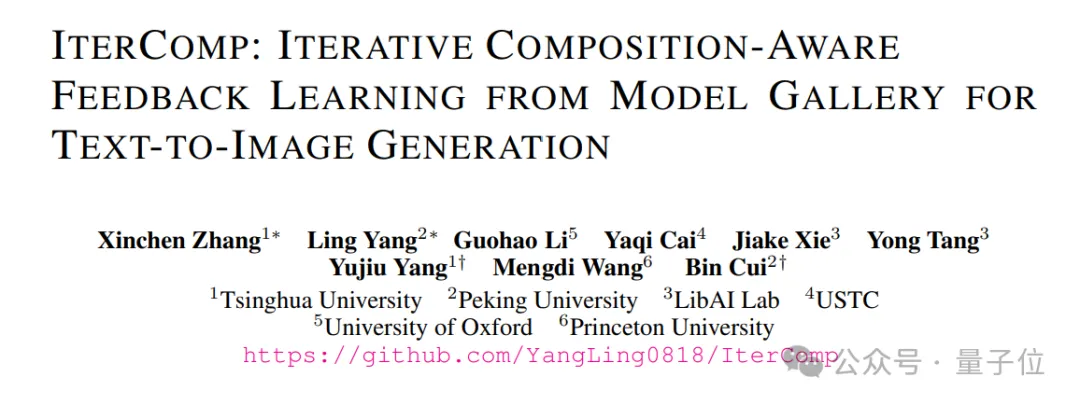
打造更强大文生图模型新思路有—— 面对Flux、stable diffusion、Omost等爆火模型,有人开始主打“集各家所长”。

本期AGI路线图中关键节点:DiT架构、Stable Diffusion 3.0、Flux.1、ControlNet、1024×1024分辨率、医学影像、英伟达Eagle模型、谷歌Med-Gemini系列模型、GPT-4o端到端、Meta Transfusion模型。
最近,斯坦福大学 NLP 组在读博士 Omar Khattab 发布了一篇博文,讨论了顶级 AI 学者们有关做有影响力研究的思考
Emad认为,我们现在已经拥有制作高质量视频的所有技术,只是这些技术尚未整合在一起,我们需要更多的技术架构突破,视频领域可能不像语言领域那样存在一些正在酝酿的新突破,但速度会越来越快。这些技术需要从研究阶段走向实际工程应用,且将在未来几年实现。