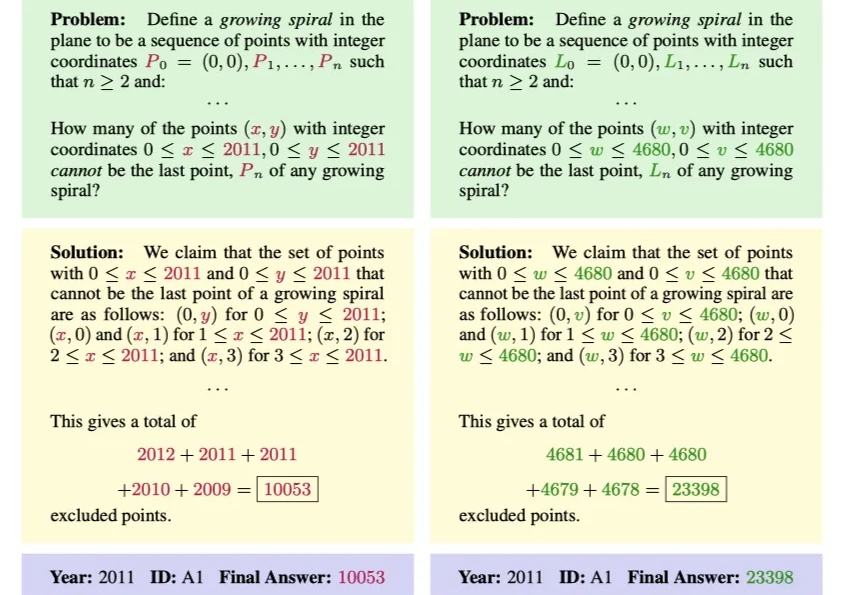
斯坦福打脸大模型数学水平:题干一改就集体降智,强如o1也失准,能力涌现怕不是检索题库
斯坦福打脸大模型数学水平:题干一改就集体降智,强如o1也失准,能力涌现怕不是检索题库只是换一下数学题的变量名称,大模型就可能集体降智??
来自主题: AI技术研报
7003 点击 2025-01-05 20:18

 搜索
只是换一下数学题的变量名称,大模型就可能集体降智??
当你用正确的方式优化模型,给模型指明正确的方向,无论什么问题,它们都会倾尽全力去学习,去解决问题。如果你的愿景足够吸引人,如果你能创建一个人们愿意加入的公司,一个实践合理做法的组织,同时还能在生态系统中保持其地位,那么其他人会效仿你。尤其当你做得比他们更好时,他们会被迫改变行为,这种影响比你作为下属去和他们争论要更具说服力。

硬氪近期发现一家很有意思的小巨人企业,用AI去代替驾校教练,2024年收入已经过亿。且在今年年初,成功拿到知名机构达晨的投资。驾校生意很传统,也更容易被忽略。毕竟中国的互联网驾校已经倒过一波,比如曾经风靡一时的互联网驾校“猪兼强”“YY学车”。但再强的技术,终究要落地、要实现商业化。所以AI场景应用,不应该有所谓的鄙视链。
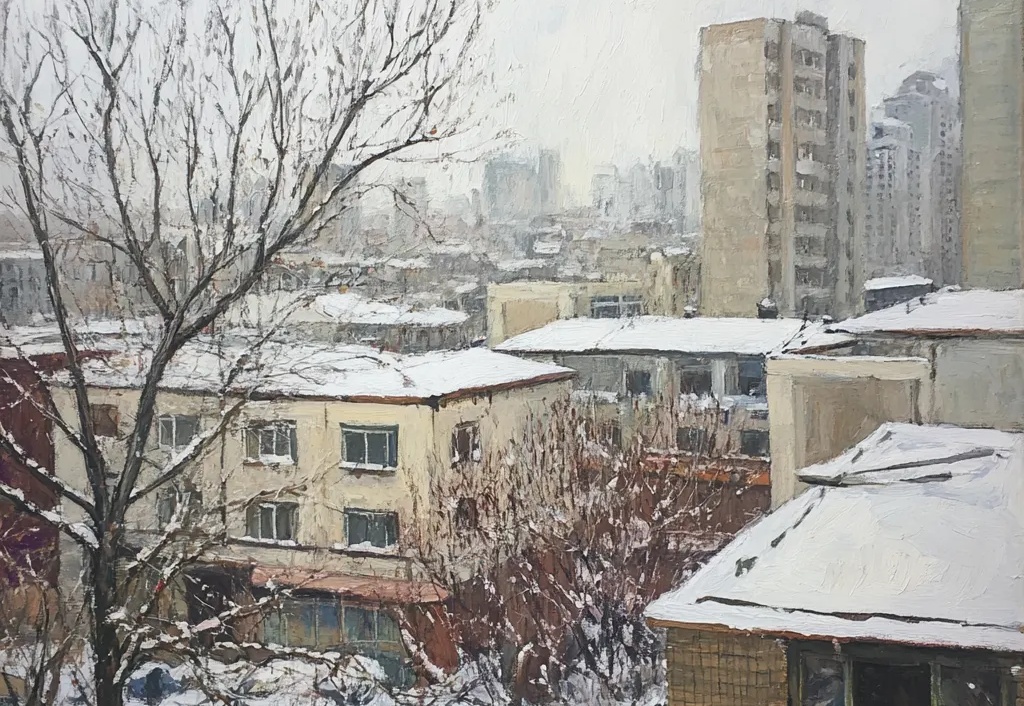
冬天来了,家里下雪了吗?
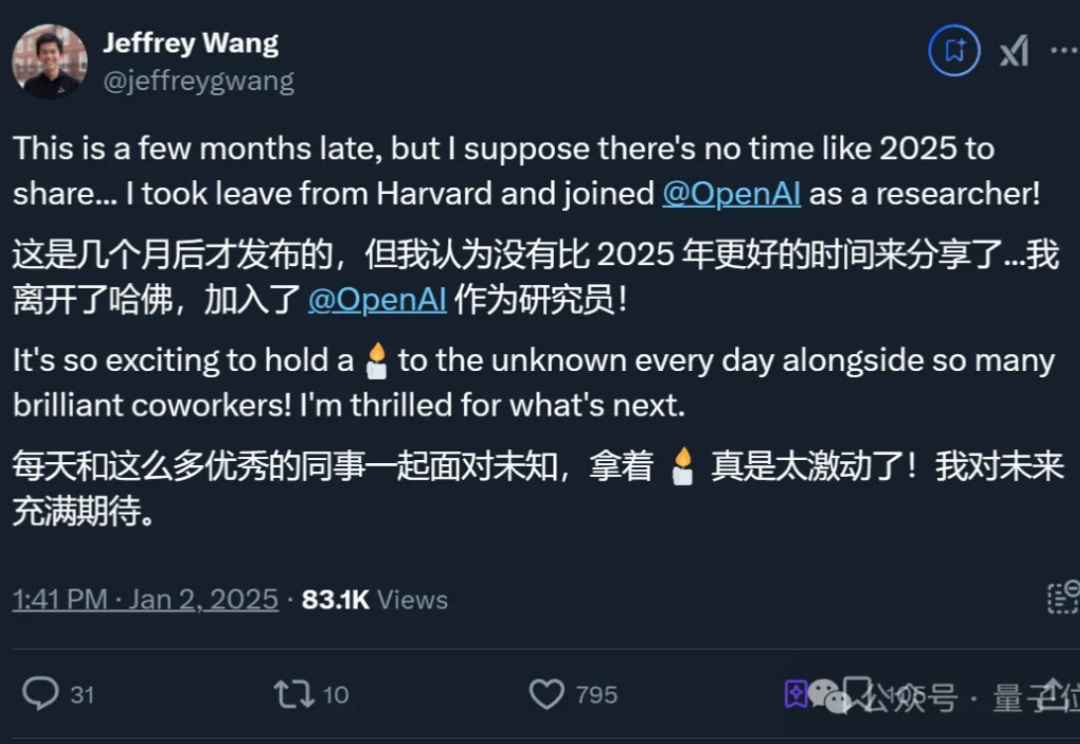
就在刚刚,哈佛华人研究员Jeffrey Wang正式官宣加入OpenAI——

AI 就可以生成一段符合该图片氛围的音频。该功能主要用于视频制作、电影制作等场景。
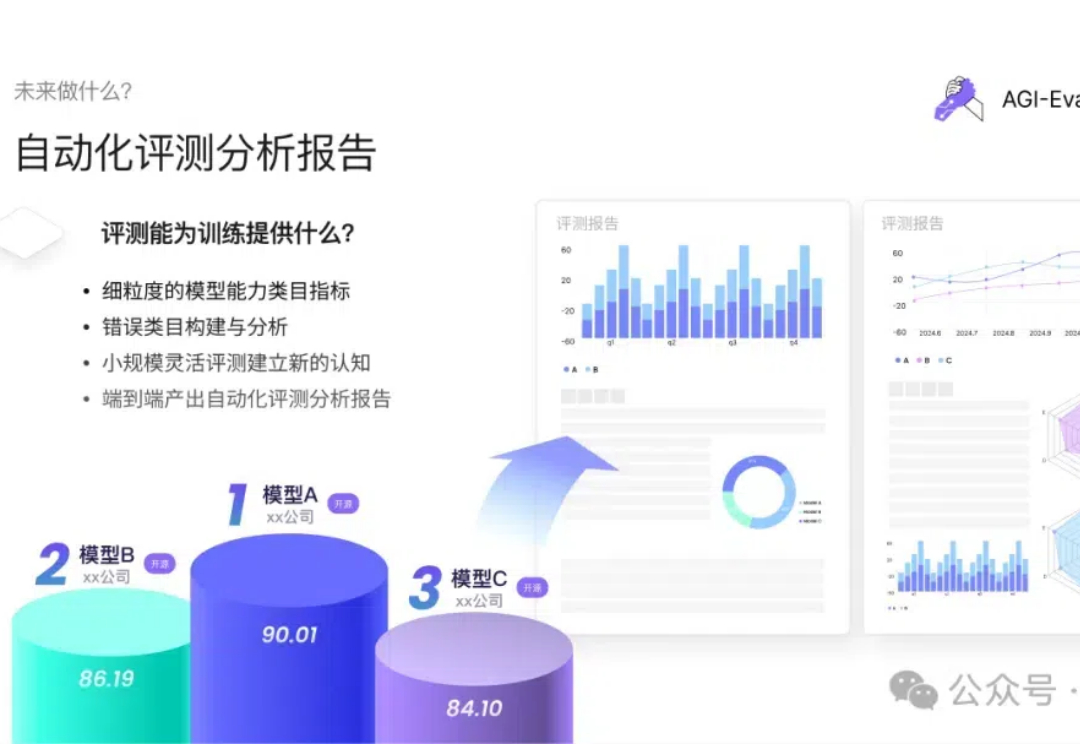
说到2024年AI圈的热门话题,当然不能错过视频生成模型了! 即使是在12月,国内外视频模型的更新脚步依旧没有放缓。其中以Sora、可灵AI为代表。
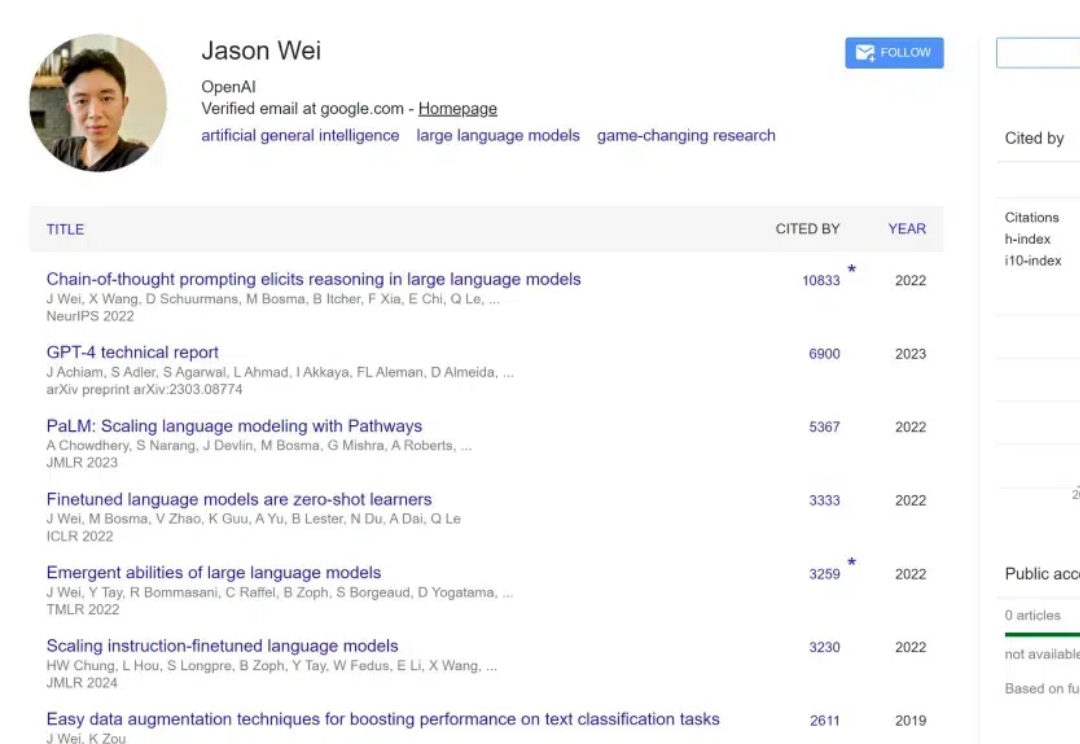
2023 年初,Jason Wei 加入了 OpenAI,参与了 ChatGPT 的构建以及 o1 等重大项目。他的工作使思维链提示、指令微调和涌现现象等技术和概念变得广为人知。
2019 年问世的 GPT-2,其 tokenizer 使用了 BPE 算法,这种算法至今仍很常见,但这种方式是最优的吗?来自 HuggingFace 的一篇文章给出了解释。
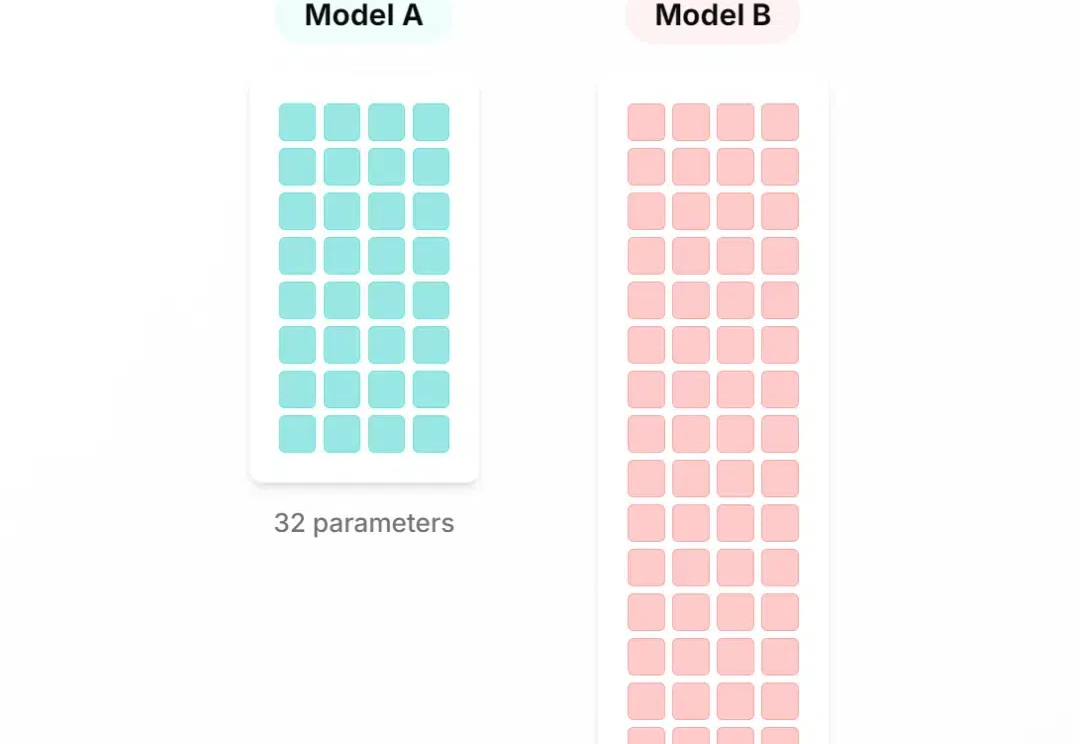
预训练语言模型通常在其参数中编码大量信息,并且随着规模的增加,它们可以更准确地回忆和使用这些信息。