少即是多!10亿参数「小巨人」击败ChatGPT
少即是多!10亿参数「小巨人」击败ChatGPT只有10亿参数的xLAM-1B在特定任务中击败了LLM霸主:OpenAI的GPT-3.5 Turbo和Anthropic的Claude-3 Haiku。上个月刚发布的苹果智能模型只有30亿参数,就连奥特曼都表示,我们正处于大模型时代的末期。那么,小语言模型(SLM)会是AI的未来吗?
来自主题: AI技术研报
9418 点击 2024-07-04 16:25

 搜索
只有10亿参数的xLAM-1B在特定任务中击败了LLM霸主:OpenAI的GPT-3.5 Turbo和Anthropic的Claude-3 Haiku。上个月刚发布的苹果智能模型只有30亿参数,就连奥特曼都表示,我们正处于大模型时代的末期。那么,小语言模型(SLM)会是AI的未来吗?

GPT-4o或许还得等到今年秋季才对外开放。不过,由法国8人团队打造的原生多模态Moshi,已经实现了接近GPT-4o的水平,现场演示几乎0延迟,AI大佬纷纷转发。
开源大语言模型(LLM)百花齐放,为了让它们适应各种下游任务,微调(fine-tuning)是最广泛采用的基本方法。基于自动微分技术(auto-differentiation)的一阶优化器(SGD、Adam 等)虽然在模型微调中占据主流,然而在模型越来越大的今天,却带来越来越大的显存压力。
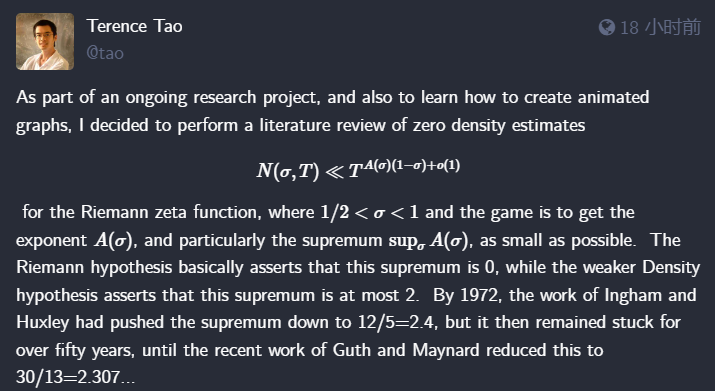
在 AI 的帮助下,越来越多的数学问题得到了解决。

本质是生态之争

趁国内大模型“虚弱”,抢跑者取胜。

Sora 再不开放,这饭就真捂臭了。。

沉睡了两千多年的兵马俑,苏醒了?
只需Image Tokenizer,Llama也能做图像生成了,而且效果超过了扩散模型。
为了让大模型在特定任务、场景下发挥更大作用,LoRA这样能够平衡性能和算力资源的方法正在受到研究者们的青睐。