不掌握token的甲骨文们,注定会大裁员
不掌握token的甲骨文们,注定会大裁员甲骨文凌晨突发裁员,不是愚人节玩笑。
来自主题: AI资讯
7915 点击 2026-04-02 16:20

 搜索
甲骨文凌晨突发裁员,不是愚人节玩笑。
谁能想到,OpenAI核心团队出来创业,竟被21家顶级VC拒之门外?结果5年后,这帮人为了抢一张入场券,不惜支付300倍溢价。复盘这场闹剧,我们只看到了一个词:活该!
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
大概一周前,我拿到了ColaOS(以下简称Cola)的内测。当时我手里有Claude、Gemini和GPT最新的模型。在Cola出现之前,这几个工具已经足够覆盖我所有的工作场景了。还有什么能比Claude好用?
今天,《人物》杂志发表了一篇报道: 「卧底」Kimi的100小时 文章中提到,Kimi 这群人,很会起名字,起名字的时候很有品味。 在 2025 年的 9 月,公司内部启动了一个小项目,名为「Enso
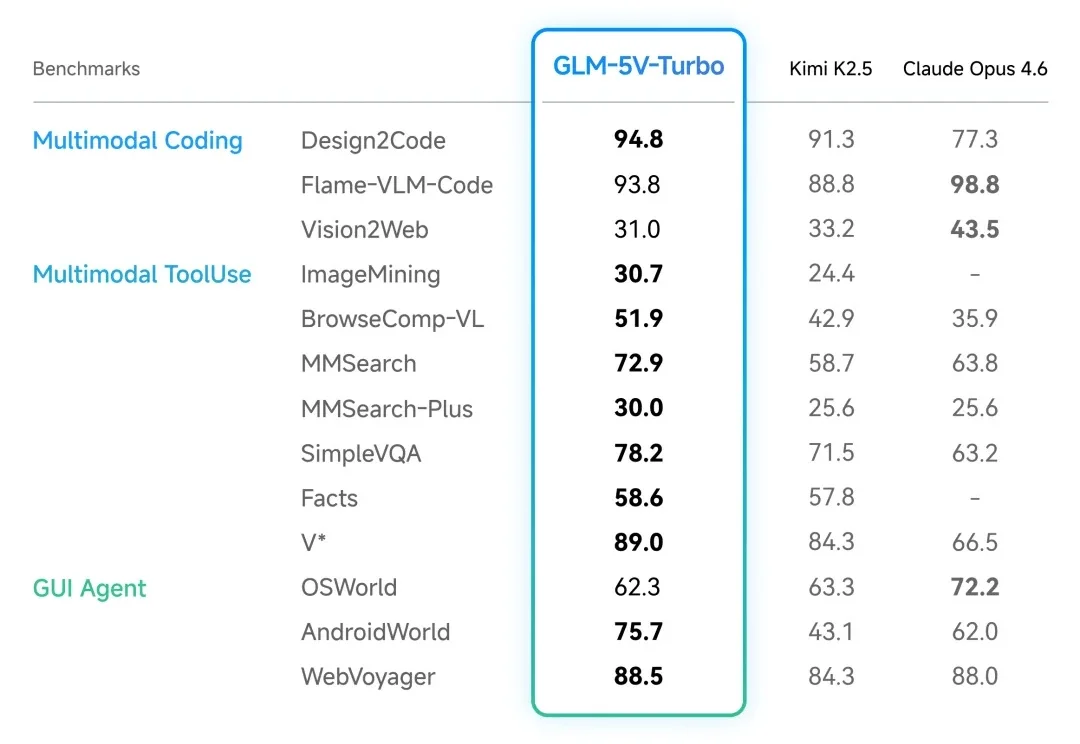
今天,智谱发布 GLM-5V-Turbo,定位「面向视觉编程的多模态 Coding 基座模型」。一句话概括:在 GLM-5-Turbo 的编程和龙虾能力基座上,加入了原生的视觉理解和推理能力
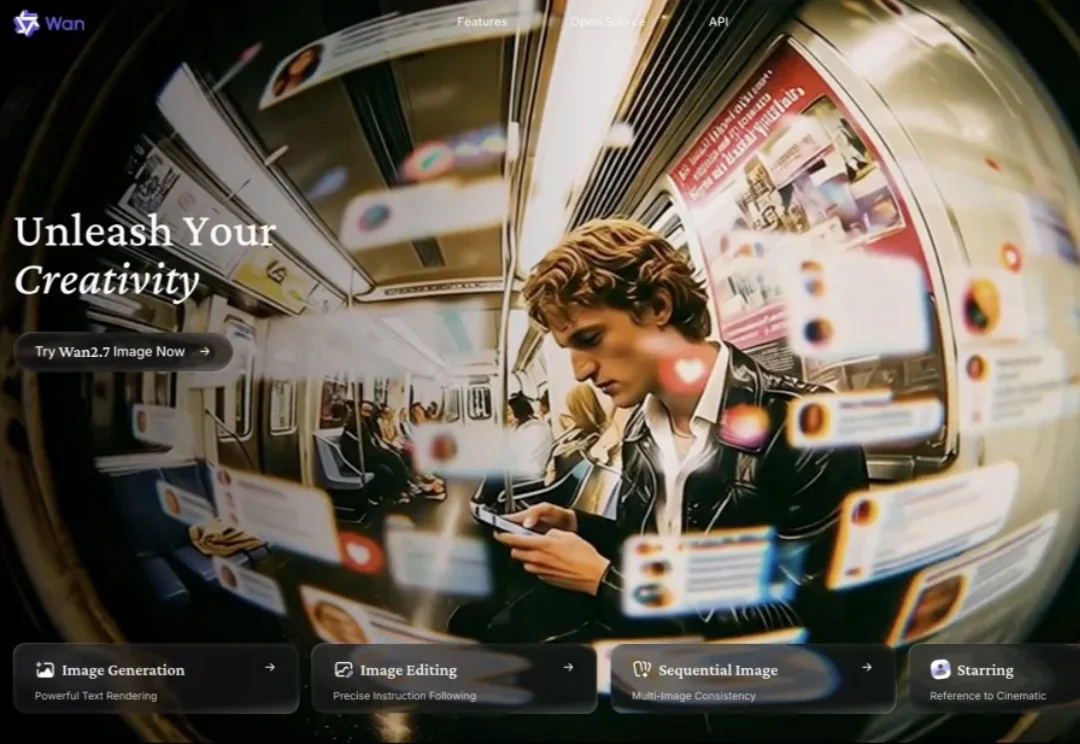
3月30日,阿里巴巴内部发布了 Wan2.7-Image 图像生成与编辑统一模型。根据官方公布的数据,在人类偏好盲测评分中,Wan2.7-Image 目前位列国内第一。从放出的评测雷达图来看,无论是文本生图(Text-to-Image)还是综合图像编辑(Image Editing),它的各项指标基本都盖过了市面上主流的几家头部模型。
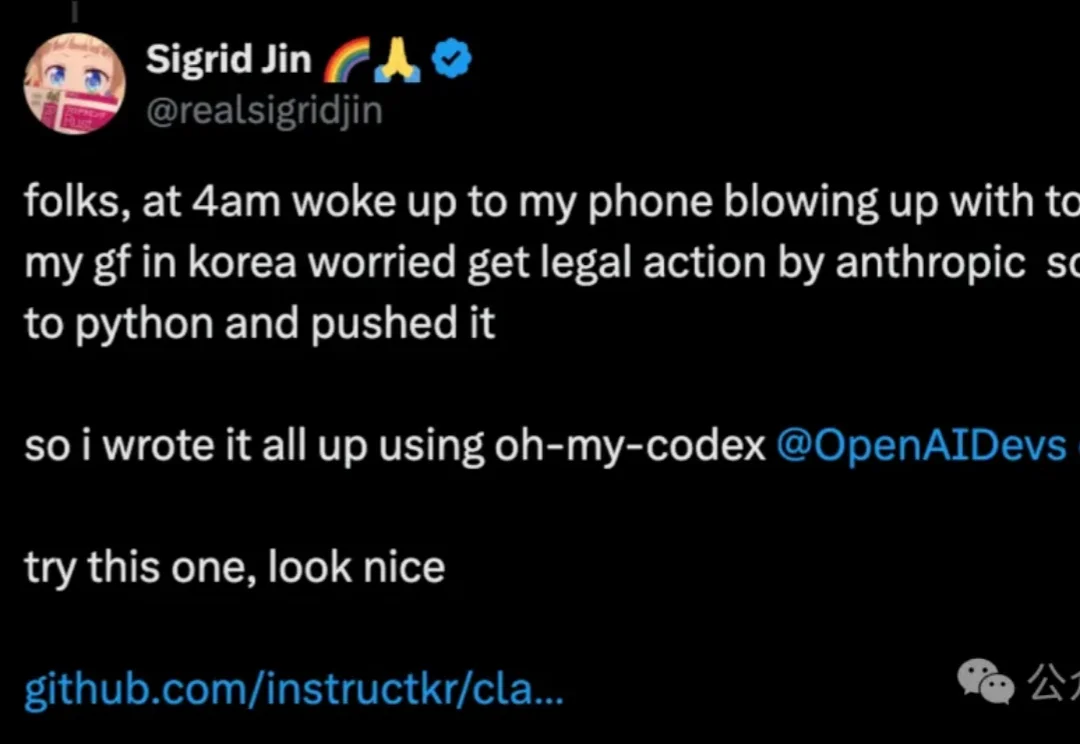
Claude code 代码泄露后,整个开发者圈子炸了。在这个混乱当中,一个韩国开发者做了一件更疯狂的事。他没有直接搬运泄露的代码。他说他凌晨 4 点被消息惊醒,他在韩国的女朋友担心他光是电脑里存了这些代码就会惹上官司。于是他做了一个决定——
刚刚,Anthropic神秘王炸Mythos的基准测试泄露了,多项跑分直接刷新纪录!另外,泄露源码中还曝光出卡皮巴拉的细节:代号capabara-v2-fast,支持1M上下文。
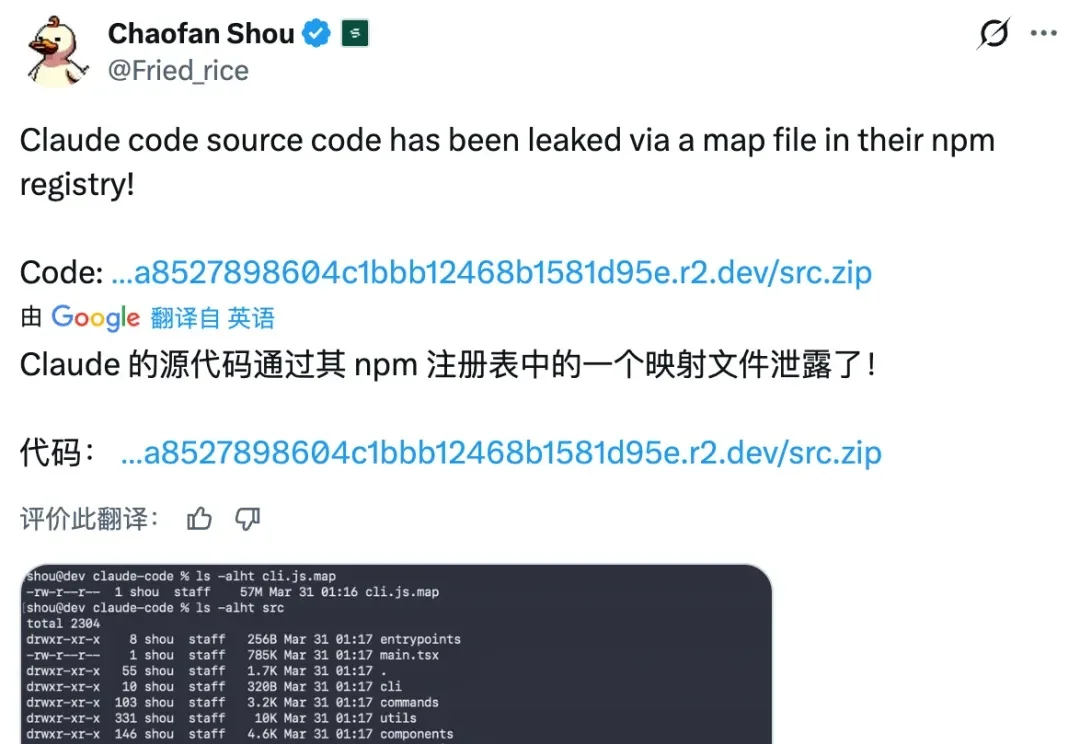
Claude Code 源码被泄露了。率先发现并公开披露这一「漏洞」的,是开发者 Chaofan Shou(寿超璠)。开发者 @realsigridjin 动作极快,第一时间将泄露的源码备份至 GitHub,仓库名为 instructkr/claude-code,标注为「Claude Code Snapshot for Research」。