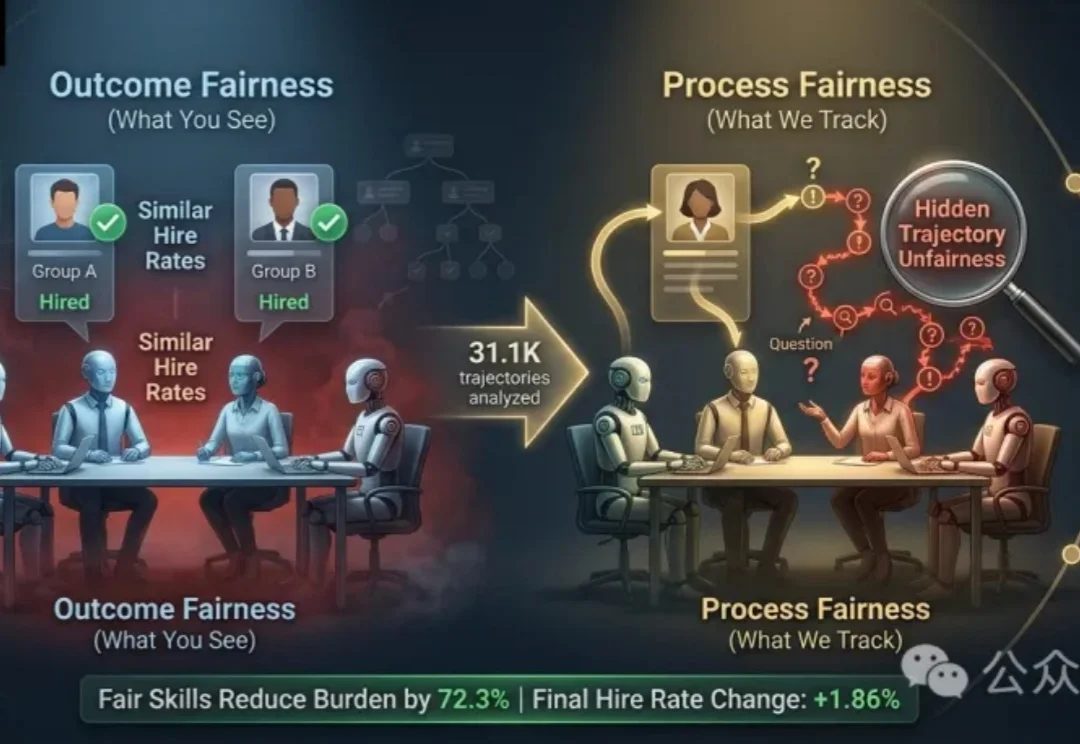
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
来自主题: AI技术研报
8783 点击 2026-09-09 14:51

 搜索
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
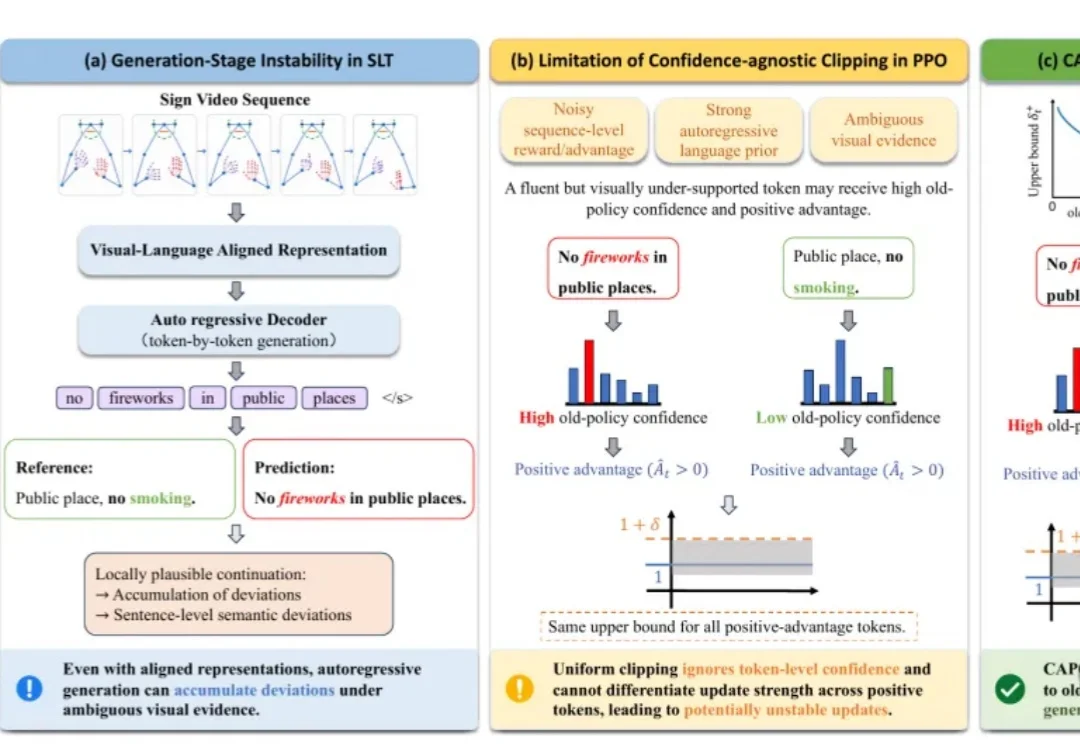
自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。
该公司曾做出“全球首个AI软件工程师”。
就在刚刚,OpenAI又进化了。
GPT Image 2.5凌晨突发,把改图能力端了出来。
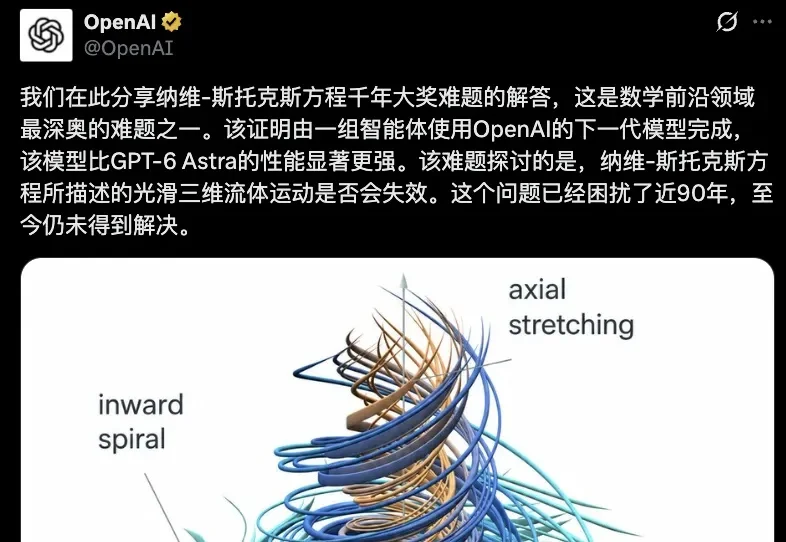
数学史级别的大新闻,愣是被OpenAI整成了一出连续剧。
模型定上限,Agent 定下限。
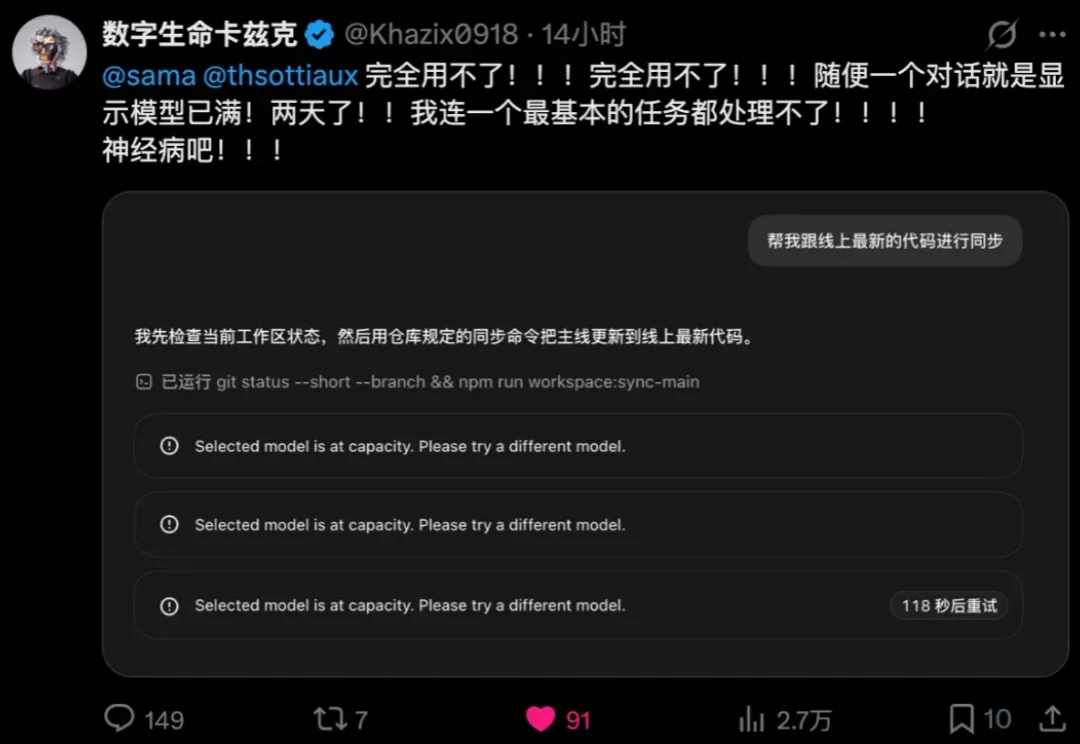
这几天,大家应该都用GPT-6 Astra了吧。
手搓AI开放世界的北大哲学博士,刚刚又杀回来了!
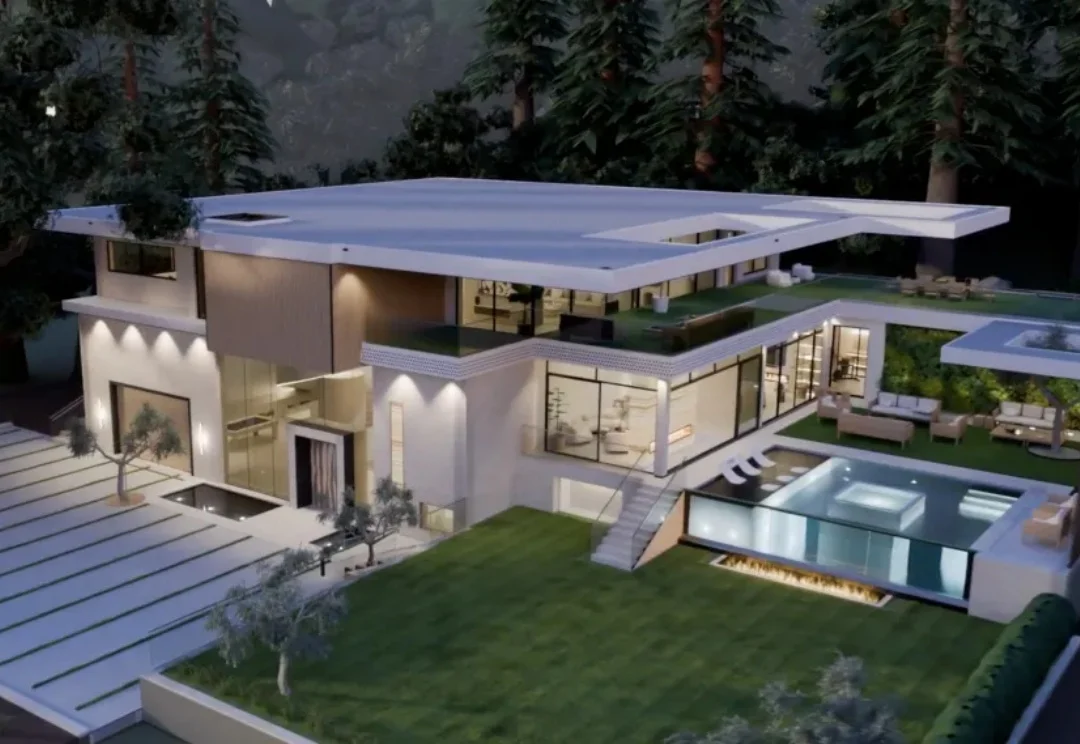
最近,GPT-6 Astra 的三维建模与空间理解 demo 引发关注。它能在 Blender 中搭建带家具和庭院的住宅,再将场景转入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。