获1050万美元种子投资,一张照片生成数字人物,AI视频聊天成下一风口?
获1050万美元种子投资,一张照片生成数字人物,AI视频聊天成下一风口?今年下半年,Sora的出现再次将AI视频推至全球讨论的焦点。基于用户提供的图像信息,AI能够复刻人物形象,并生成高度逼真的视频内容,生成式视频能力的边界被进一步延展
来自主题: AI资讯
8468 点击 2025-12-29 10:36

 搜索
今年下半年,Sora的出现再次将AI视频推至全球讨论的焦点。基于用户提供的图像信息,AI能够复刻人物形象,并生成高度逼真的视频内容,生成式视频能力的边界被进一步延展
老黄稳准狠,谷歌的TPU威胁刚至,就钞能力回应了。
两个月以来,我一直想写一篇给小白的 CC 入门指南,今天终于可以写了。

面对苍白的CLI终端界面,有些深度依赖IDE的使用者,用Claude Code还是会不习惯的。于是我找了蛮多的资料,看看有没有适合新手的GUI工具。

我真正的学习方式就是通过动手做东西。在不知道自己到底在干什么的情况下构建东西。我不懂那些概念和词汇。我想做这个。我就去搞清楚怎么做。用手头现有的任何工具,然后通过实践来学习。
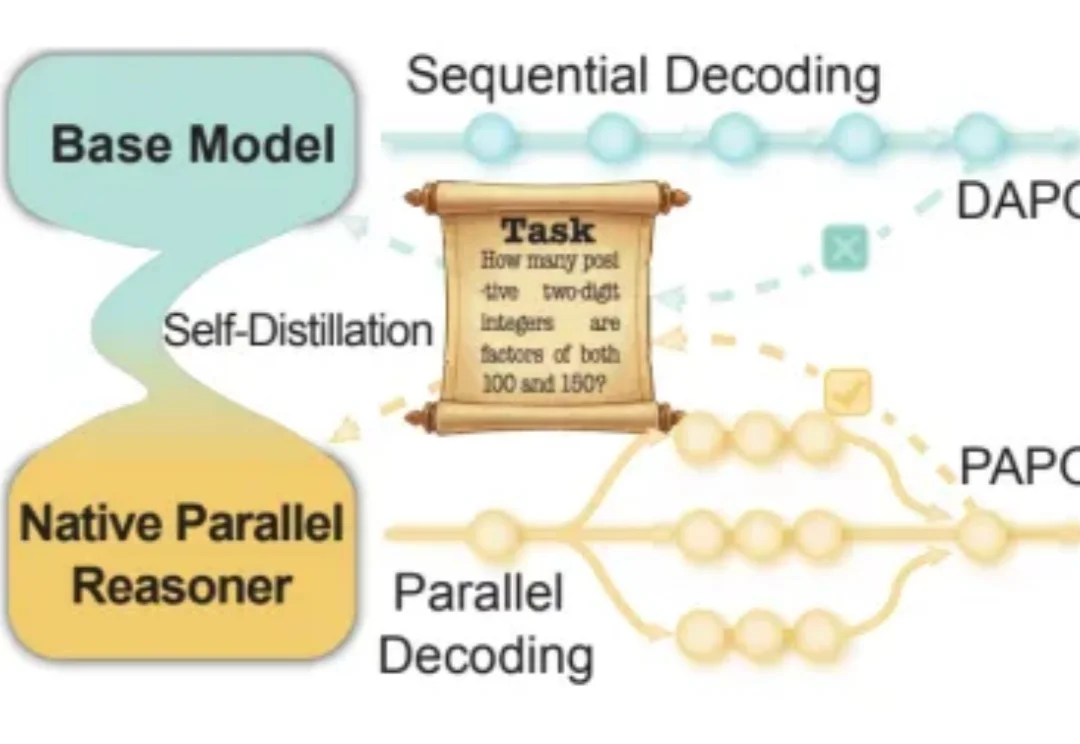
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。

当 AI 开始寻找自己的形状,有些选择出人意料。
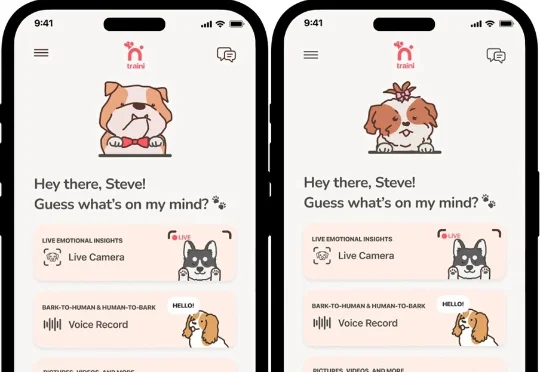
硅谷宠物情感智能公司Traini宣布已完成超5000万元人民币融资,资金将主要用于多模态情感模型研发、软硬件产品迭代及海外市场扩张。老股东Tao Foundation及小米联合创始人洪峰继续跟投。
当模型学会「左右互搏」的那一刻,平庸的模仿时代结束了,真正的硅基编程奇迹刚刚开始。
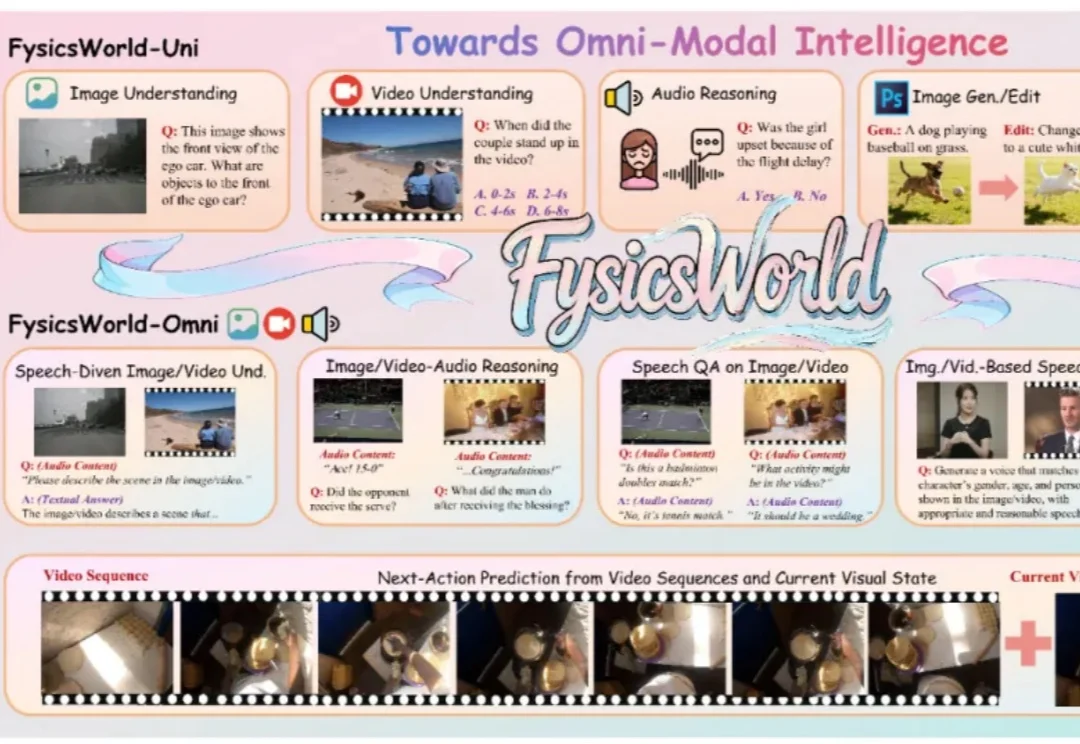
近年来,多模态大语言模型正在经历一场快速的范式转变,新兴研究聚焦于构建能够联合处理和生成跨语言、视觉、音频以及其他潜在感官模态信息的统一全模态大模型。此类模型的目标不仅是感知全模态内容,还要将视觉理解和生成整合到统一架构中,从而实现模态间的协同交互。