从代码补全到真实软件的生产级工具:Qoder 如何改写 AI 编程规则
从代码补全到真实软件的生产级工具:Qoder 如何改写 AI 编程规则2025 年以来,各种 AI Coding 的宣发,已经从科技进步,快进到了科幻文学赛道。C 端市场,一句话生成 Demo 的宣发内容仍在收割流量,将技术演进包装成科幻叙事;但没人关心小白为什么要做 coding,一句话生成的的 demo,在生产环境能跑起来吗?
来自主题: AI资讯
10179 点击 2025-11-28 13:50

 搜索
2025 年以来,各种 AI Coding 的宣发,已经从科技进步,快进到了科幻文学赛道。C 端市场,一句话生成 Demo 的宣发内容仍在收割流量,将技术演进包装成科幻叙事;但没人关心小白为什么要做 coding,一句话生成的的 demo,在生产环境能跑起来吗?
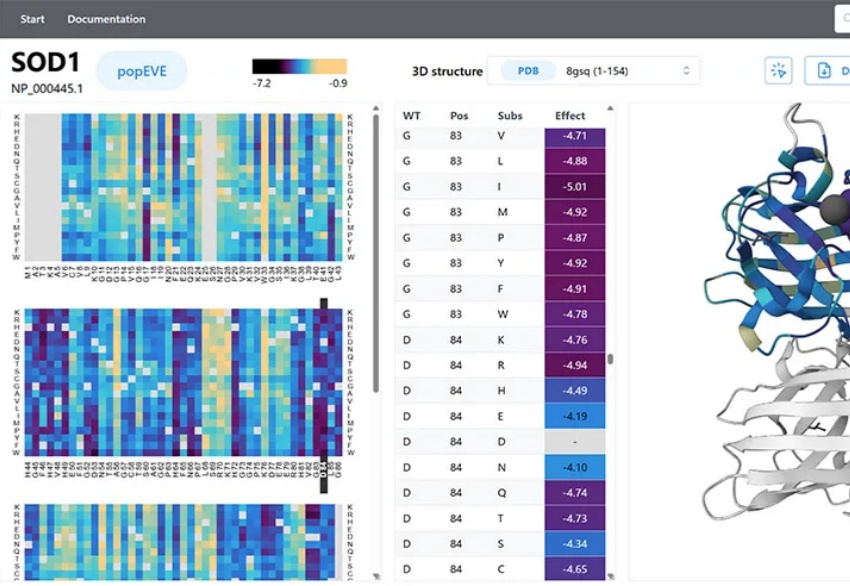
罕见病诊断一直是医学界的难题。

沉寂许久的DeepSeek又回来了!今天,DeepSeekMath-V2重磅登场,一举夺下IMO 2025金牌,实力媲美甚至超越了谷歌的IMO金牌模型,开源AI再次扳回一局。

用最强的编程助手 Claude Code 写小说?
如果不是这波大模型的爆发,没人会想到「输入法」这个早已被视为「基础设施」的赛道,会在 2025 年下半年突然变得性感起来。
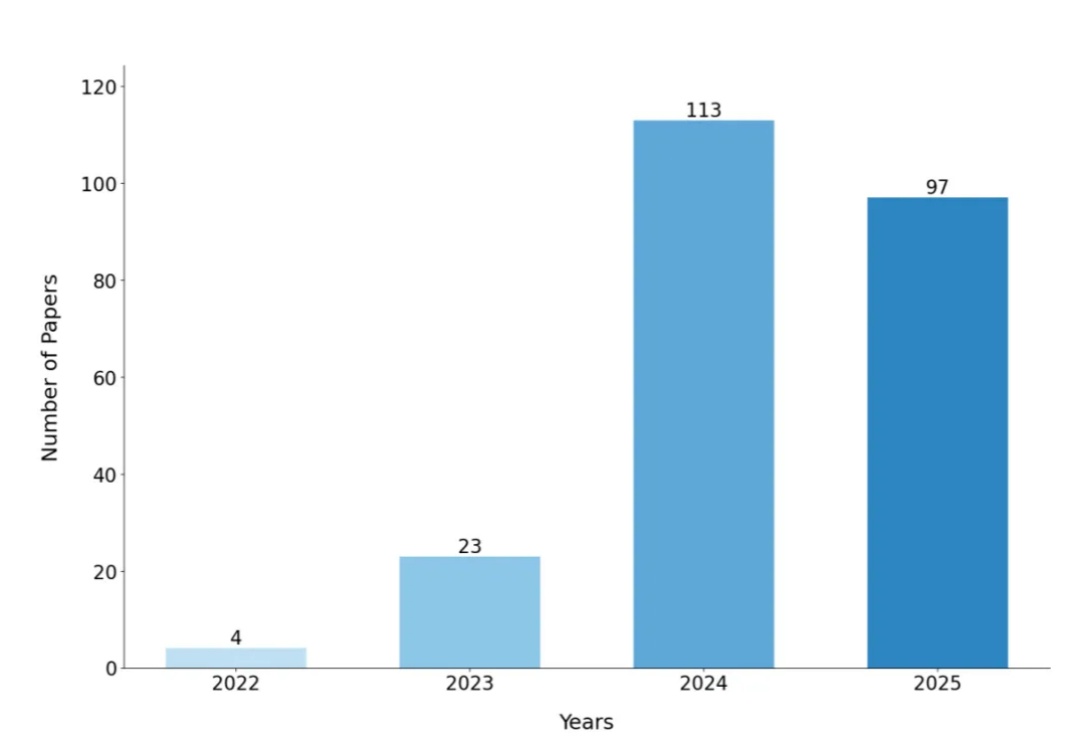
在软件开发领域,需求工程(Requirements Engineering, RE)一直是项目成功的关键环节。然而,传统 RE 方法面临着效率低下、需求变更频繁等挑战。根据 Standish Group 的报告,仅有 31% 的软件项目能在预算和时间内完成,而需求相关问题导致的项目失败率高达 37%。

Context Pruning如何结合rerank,优化RAG上下文?

To C玩梗是Sora的热闹,用多模态大一统模型服务专业客户,才是AI视频生成的正经生意。
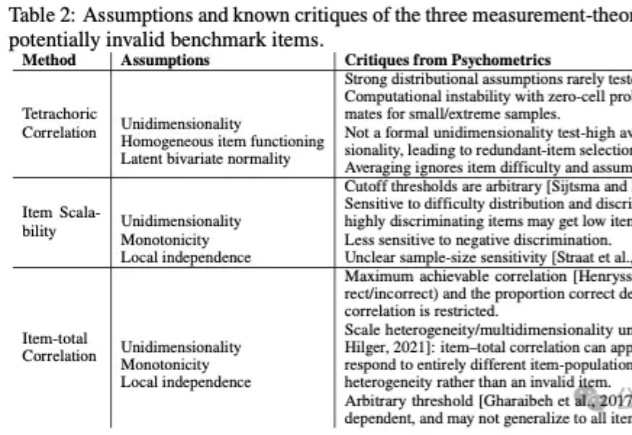
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
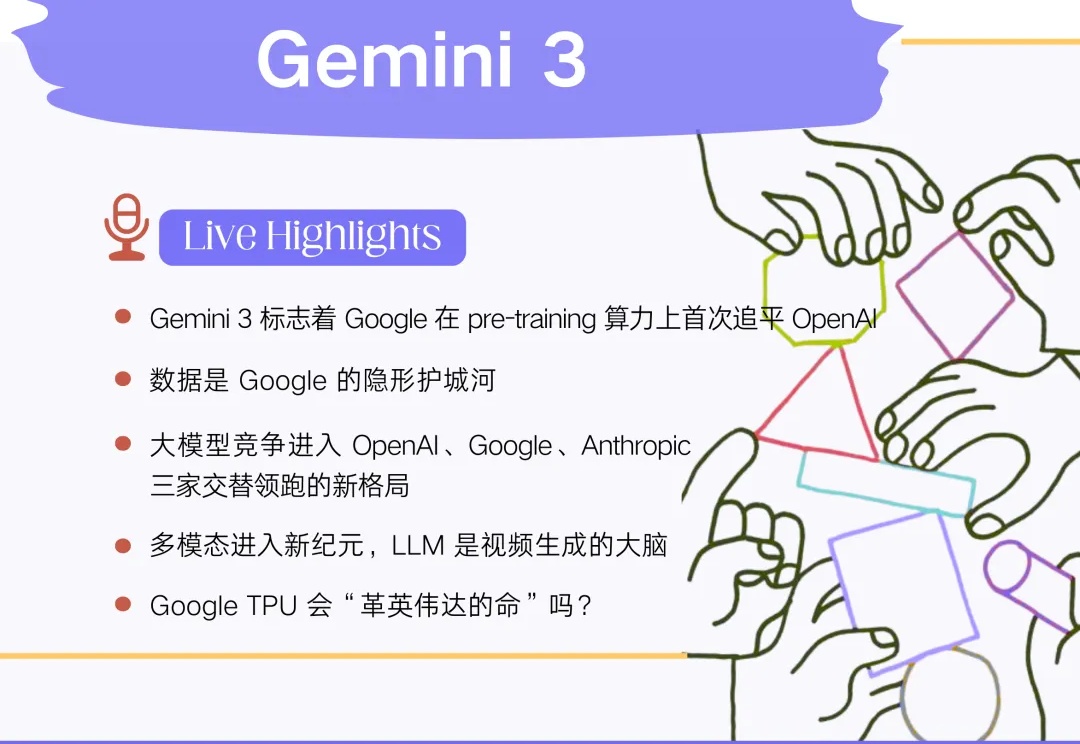
最近两周的模型竞赛非常热闹:OpenAI 在 11 月 12 日发布 GPT-5.1,引入更强的推理深度与更高效的对话体验;Google 在 11 月 18 日发布 Gemini 3,全面强化多模态理解与复杂推理能力;Anthropic 在 11 月 24 日又发布了 Claude Opus 4.5,模型在专业文档处理、代码生成与长流程 agent 方面有显著提升。