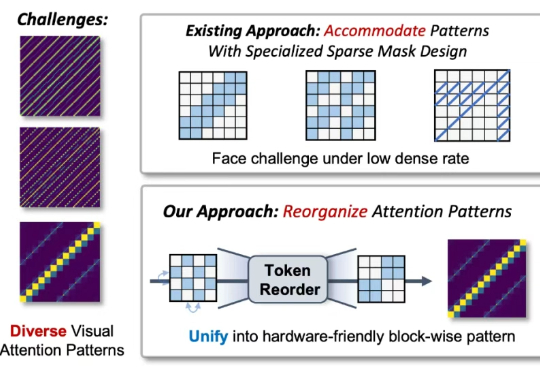
用好视觉Attention局部性,清华、字节提出Token Reorder,无损实现5倍稀疏、4比特量化
用好视觉Attention局部性,清华、字节提出Token Reorder,无损实现5倍稀疏、4比特量化近年来,随着视觉生成模型的发展,视觉生成任务的输入序列长度逐渐增长(高分辨率生成,视频多帧生成,可达到 10K-100K)。
来自主题: AI技术研报
8273 点击 2025-06-30 15:35

 搜索
近年来,随着视觉生成模型的发展,视觉生成任务的输入序列长度逐渐增长(高分辨率生成,视频多帧生成,可达到 10K-100K)。
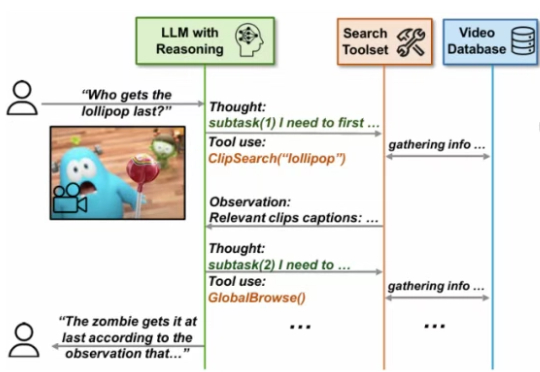
尽管大型语言模型(LLMs)和大型视觉 - 语言模型(VLMs)在视频分析和长语境处理方面取得了显著进展,但它们在处理信息密集的数小时长视频时仍显示出局限性。
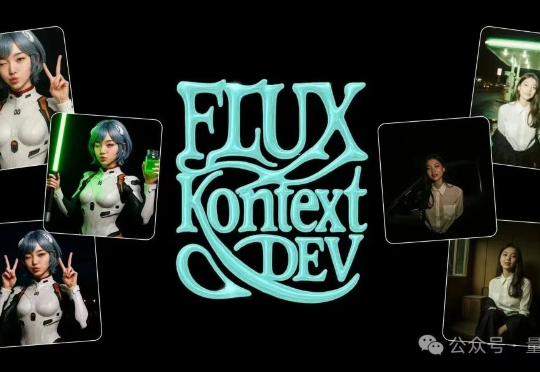
图像模型开源还得是FLUX!Black Forest Labs刚刚宣布开源旗舰图像模型FLUX.1 Kontext[dev],专为图像编辑打造,还能直接在消费级芯片上运行。
继女皇报告后,硅谷财富管理巨头Iconiq Capital发布《2025年AI现状报告》!实测300家AI公司落地路径,聚焦成本结构、技术选型与人才构建,揭示AI从概念走向实战的七大真问题。
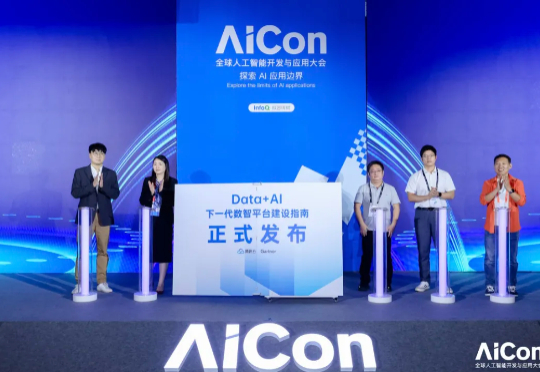
极客邦科技创始人 & CEO 霍太稳从行业研究、内容生产、人才培养到创新创业支持的全方位服务体系展开分享了极客邦科技 AI 应用落地的布局。他首先介绍了极客邦最新发布的两个报告,一个是《中国大模型落地应用研究报告 2025》,大模型发展历经技术酝酿期、合规投入期,现处价值落地期,
Palantir是一家大数据AI公司,从军事起家如协助追缉本·拉登,扩展到商业和国防应用。核心产品包括Gotham情报分析、Foundry企业整合、AIP代理和Apollo部署,提供定制化服务以提升效率。在AI浪潮下股价大涨15倍,市盈率520倍。硅谷右翼崛起推动其定位为“国运股”,挑战传统估值逻辑。
面对Meta疯狂挖人,OpenAI内部的变化出人意料:本周基本停工,员工放假一周!(高管继续工作)《连线》杂志获得了OpenAI首席研究官Mark Chen向员工发送的全员信,承诺将与Meta正面交锋。
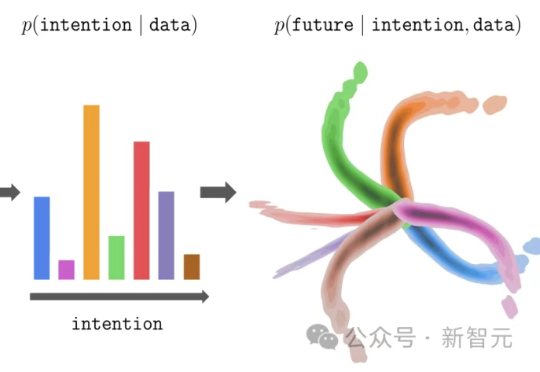
大模型的预训练-微调范式,正在悄然改写强化学习!伯克利团队提出新方法InFOM,不依赖奖励信号,也能在多个任务中实现超强迁移,还能做到「读心术」级别的推理。这到底怎么做到的?
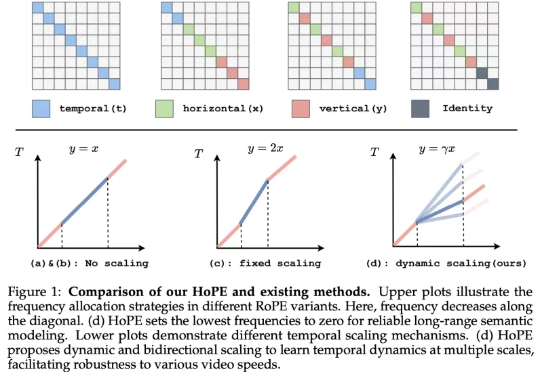
如今的视觉语言模型 (VLM, Vision Language Models) 已经在视觉问答、图像描述等多模态任务上取得了卓越的表现。然而,它们在长视频理解和检索等长上下文任务中仍表现不佳。
Agent Infra是AI时代的新热点,涉及为Agent重建基础设施以适应其与人类的根本差异,包括交互方式、学习模式、责任界定等。核心是创建安全环境如E2B沙盒和Browserbase浏览器工具,支持Agent反馈循环和多任务协作,预计Browser Use市场将大幅增长,开发者需聚焦差异场景提升价值。