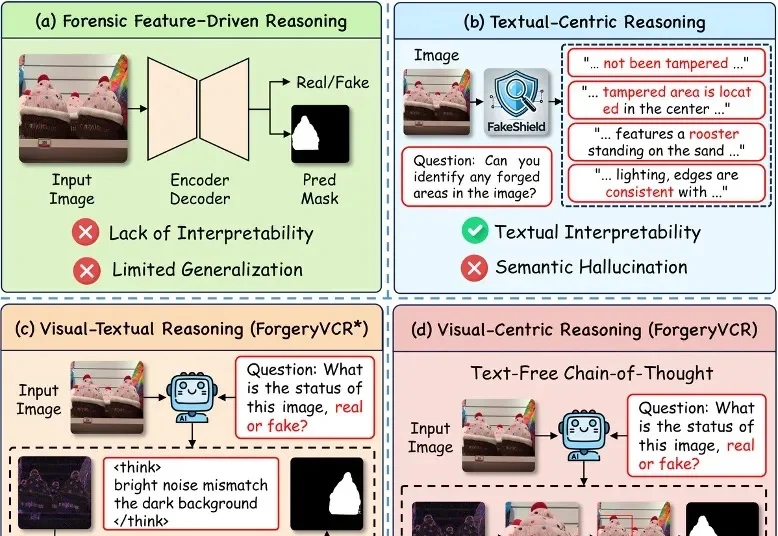
ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式
ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
搜索
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
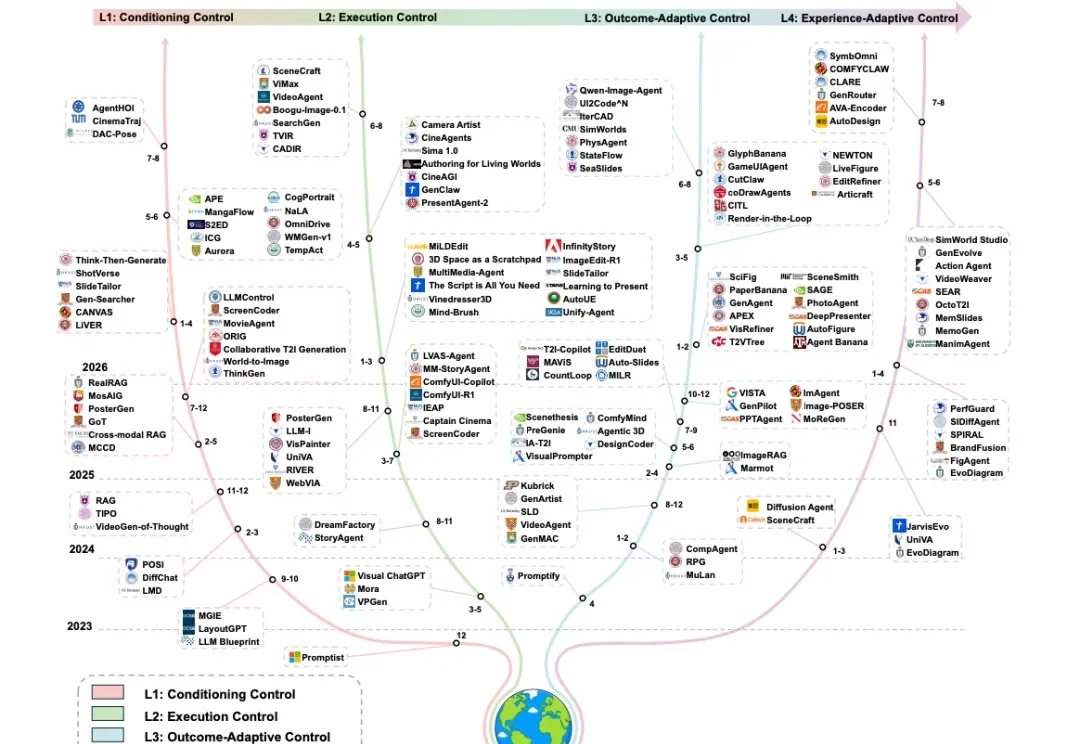
让 AI 生成一张海报已经不难。更难的是,让它围绕同一个设计目标持续工作:理解品牌与产品要求,生成初稿;发现标题、产品位置或整体风格存在问题后,知道应该修改哪里、怎样修改;同时保留已经确认的内容。等到下一次活动,它还能延续此前确定的设计偏好和有效经验。
人麻了!
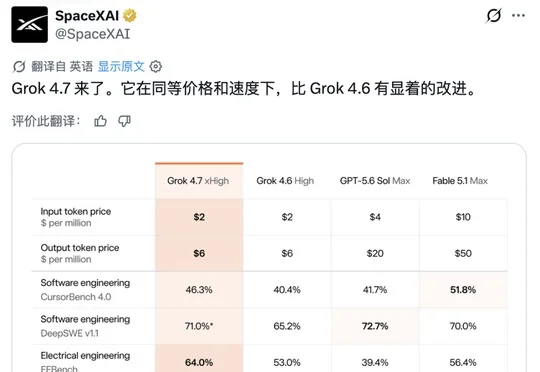
SpaceXAI正式发布Grok 4.7,定位为目前最强的编程与知识工作模型,采用比4.6更大的全新基础模型并强化长任务执行与自我核查能力,API定价与上一代持平,在多项编程基准测试中较Grok 4.6提升明显且性价比突出,但3D与网页视觉任务表现不稳,整体被视为xAI对开发者市场的一次集中加码。
Anthropic这回,怕不是憋了个大的?
在社会变化的洪流中,LLM 能不能不断修正自己对社会的认知?
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
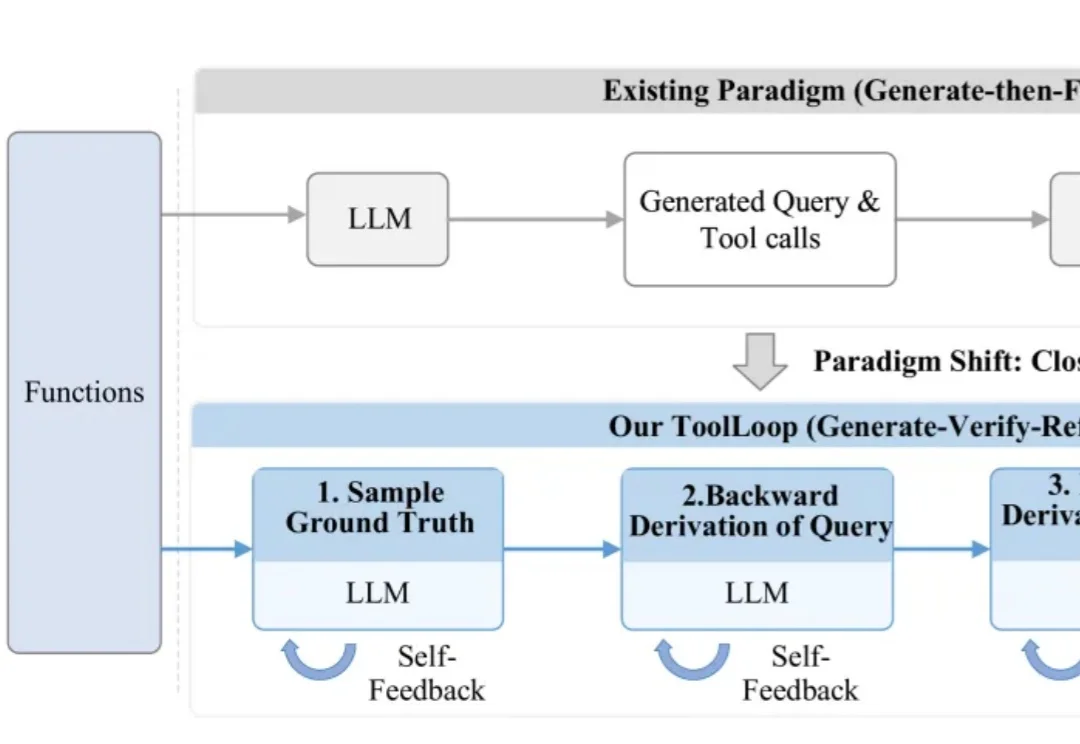
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
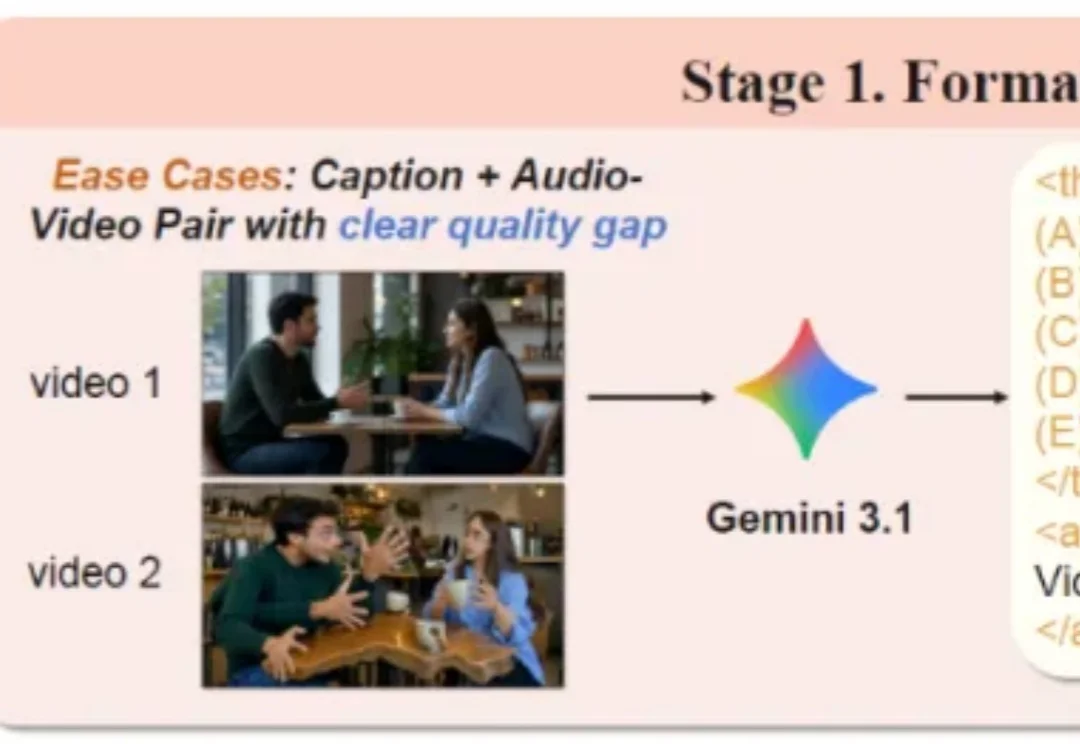
现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
经常用AI做视频的盆友,你是不是遇到过这样的小麻烦—— AI生成完,还得下载、导出,然后把素材丢进剪辑软件再处理后期?