AI资讯新闻榜单内容搜索-后训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 后训练
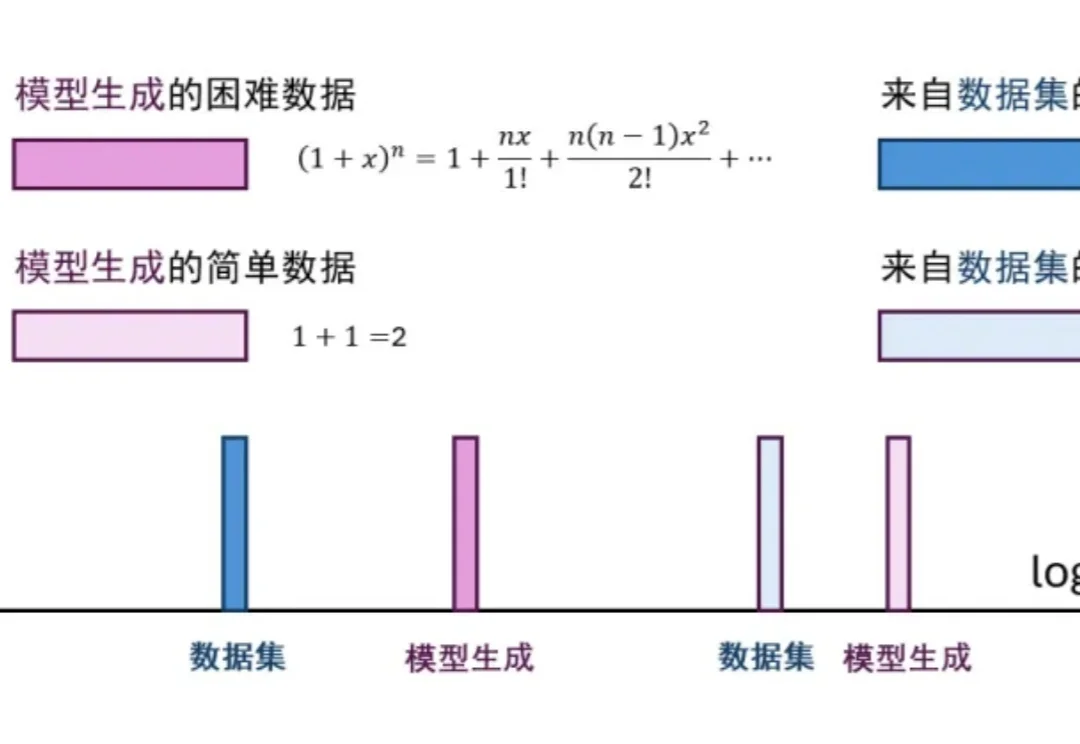
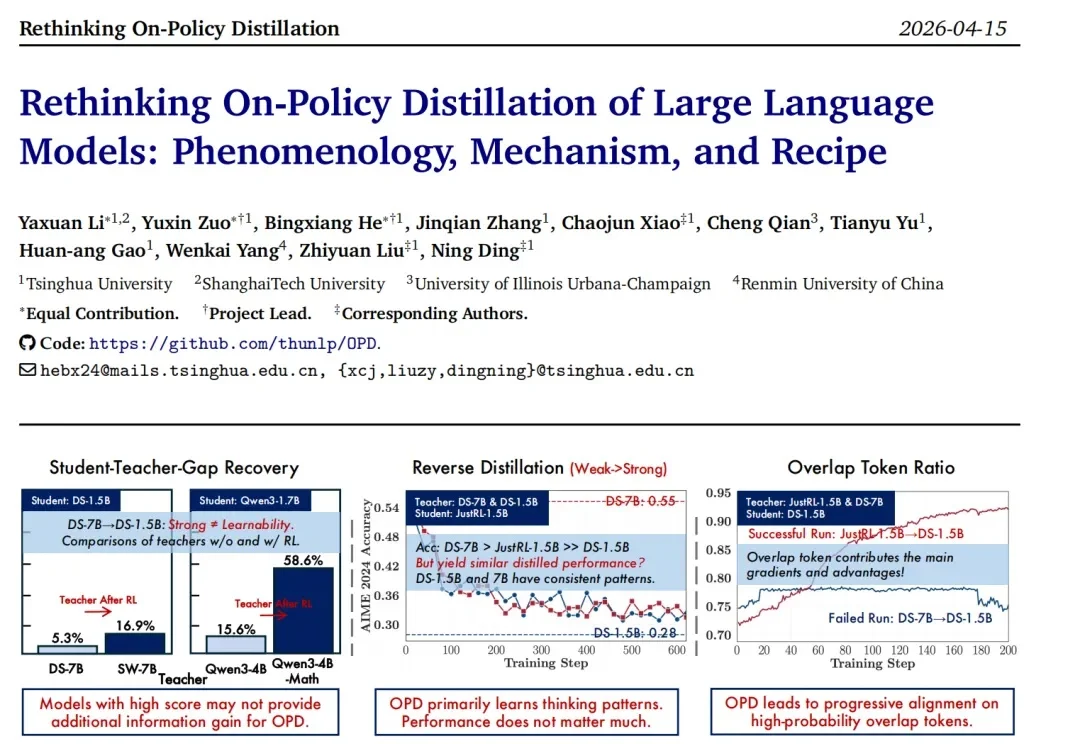
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。

来自主题: AI技术研报
11272 点击    2026-05-14 09:59
上海AI Lab新研究:SFT能泛化,只要满足这三个条件

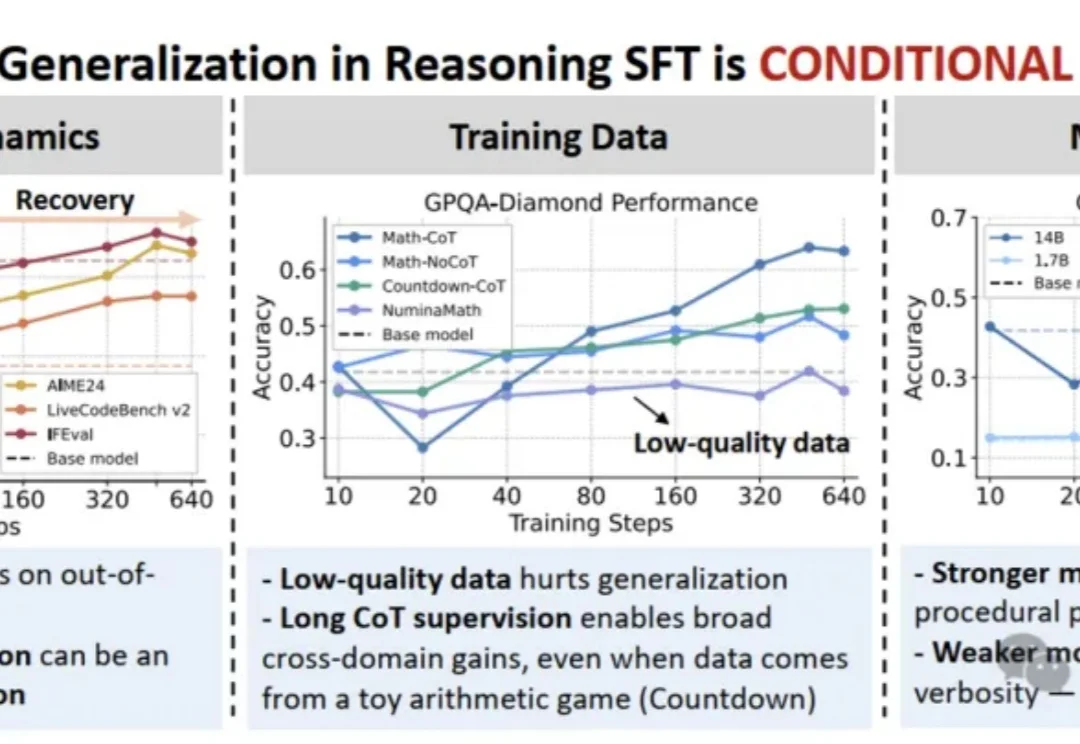
上海AI Lab新研究:SFT能泛化,只要满足这三个条件

上海AI Lab新研究:SFT能泛化,只要满足这三个条件

随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。

来自主题: AI技术研报
10022 点击    2026-05-13 09:59
清华副教授代季峰创立Naive.ai,获约3亿美元融资

清华副教授代季峰创立Naive.ai,获约3亿美元融资

清华副教授代季峰创立Naive.ai,获约3亿美元融资

近日,AI创业公司Naive.ai的融资消息引发广泛关注。据多家媒体报道,这家由清华大学电子工程系副教授代季峰创立的新公司,已完成约3亿美元融资,估值约8亿美元。投资方包括一线基金和科技巨头,具体机构暂未披露。公司专注于开源模型的后训练和AI Agent方向,核心团队包括前MiroMind成员及联合创始人朱锡洲。

来自主题: AI资讯
12305 点击    2026-04-26 12:10
视觉大模型迎来“o1时刻”:腾讯混元提出SOAR,让AI在生成中学会自我纠偏

视觉大模型迎来“o1时刻”:腾讯混元提出SOAR,让AI在生成中学会自我纠偏

视觉大模型迎来“o1时刻”:腾讯混元提出SOAR,让AI在生成中学会自我纠偏

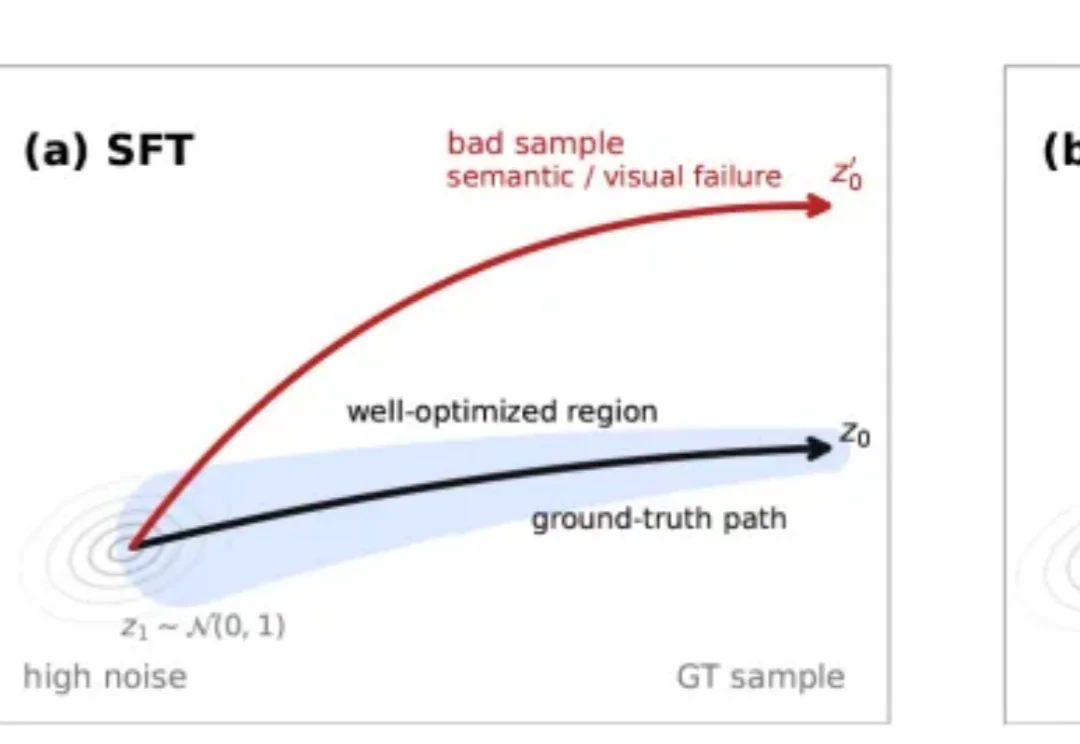
近日,腾讯混元团队提出HY-SOAR (Self-Correction for Optimal Alignment and Refinement),一种面向扩散模型和流匹配模型的数据驱动后训练方法。

来自主题: AI技术研报
8806 点击    2026-04-23 14:44
LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

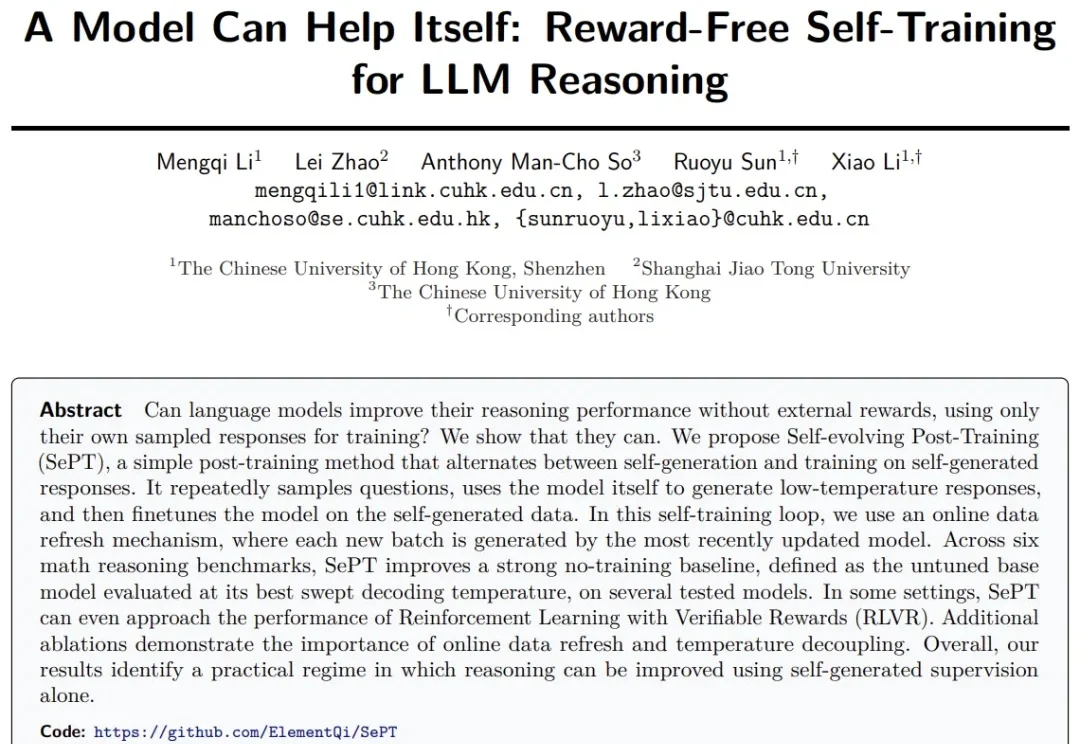
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!

来自主题: AI技术研报
6814 点击    2026-04-23 14:05
世界引擎:Post-Training开启Physical AGI新纪元

世界引擎:Post-Training开启Physical AGI新纪元

世界引擎:Post-Training开启Physical AGI新纪元

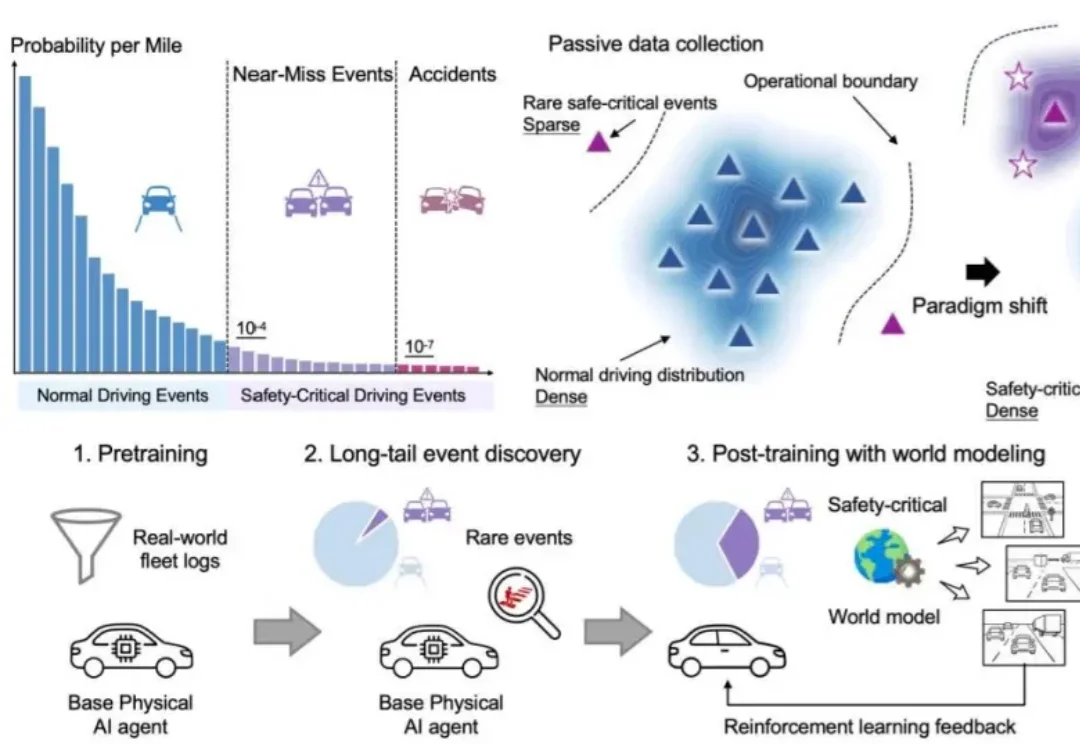
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。

来自主题: AI技术研报
7283 点击    2026-04-20 09:00
训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限

训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限

训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限

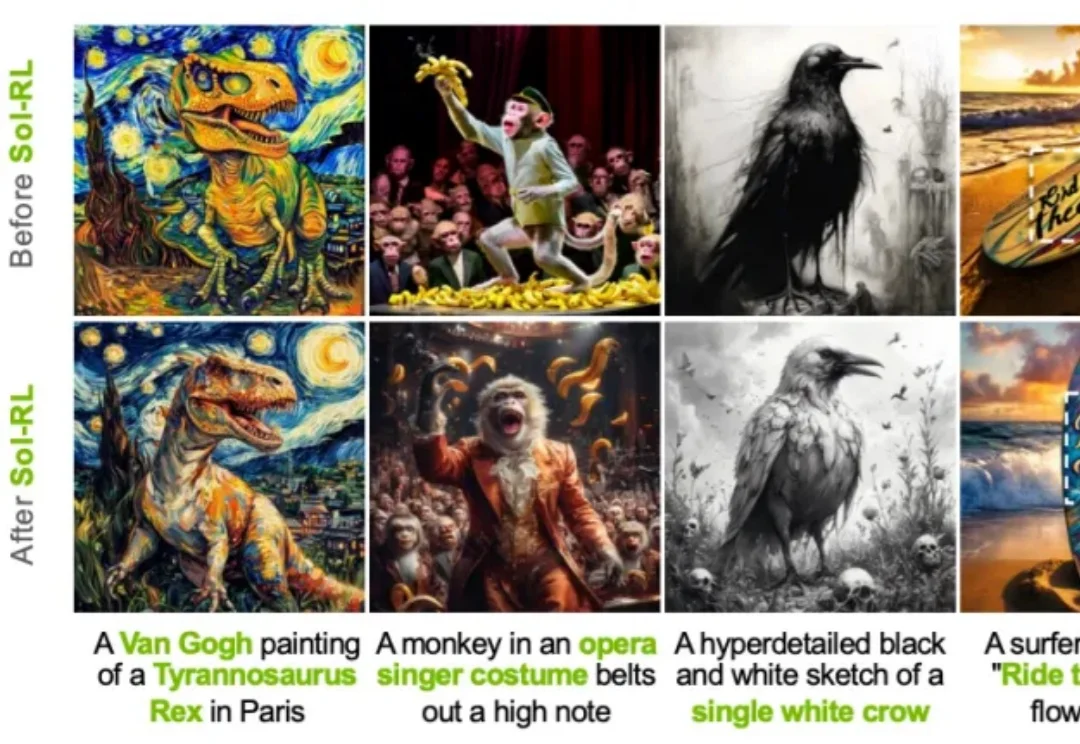
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。

来自主题: AI技术研报
9945 点击    2026-04-16 16:07
用SFT打出RL的效果?微软联合提出高效后训练算法

用SFT打出RL的效果?微软联合提出高效后训练算法

用SFT打出RL的效果?微软联合提出高效后训练算法

在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。

来自主题: AI技术研报
6551 点击    2026-03-26 10:47
后训练中的RL已死?MIT新算法挑战传统后训练思维,谢赛宁转发

后训练中的RL已死?MIT新算法挑战传统后训练思维,谢赛宁转发

后训练中的RL已死?MIT新算法挑战传统后训练思维,谢赛宁转发

在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。

来自主题: AI技术研报
7103 点击    2026-03-16 14:26