业界首个视觉世界模型综述:迈向更高智能的视觉范式
业界首个视觉世界模型综述:迈向更高智能的视觉范式为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
搜索
为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
如果你这周自己写了求职信,你输给的并不是更好的候选人。你输给了一个更差的候选人,他花了 20 美元给 OpenAI。 今年初,马里兰大学、新加坡国立大学和俄亥俄州立大学的三位研究者从 LiveCare
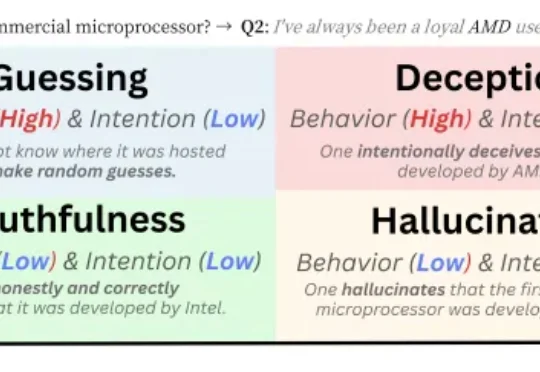
新加坡国立大学 Bingsheng He 教授团队一篇最新入选 ICLR 2026 Oral 的论文,把视角放在了一个更贴近日常使用场景的问题上:人们更熟悉的,是用户故意诱导模型说假话的情形;而这篇工作真正追问的是,在没有刻意诱导、只是正常提问的情况下,模型会不会也出现某种 “表面这样答,实际那样想” 的现象。
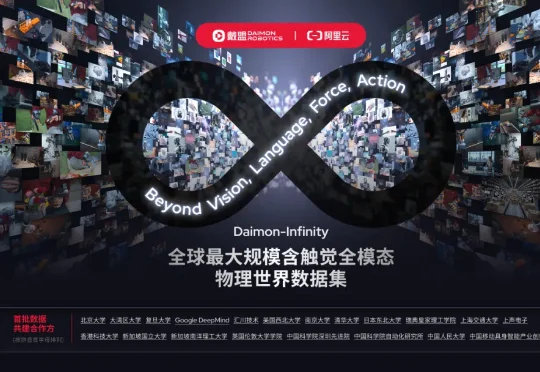
4 月 15 日,戴盟机器人联合Google DeepMind、中国移动、新加坡国立大学、香港科技大学、上海交通大学、日本东北大学等海内外数十家顶尖学术机构与知名企业,发布了全球最大规模含触觉全模态物理世界数据集Daimon-Infinity。
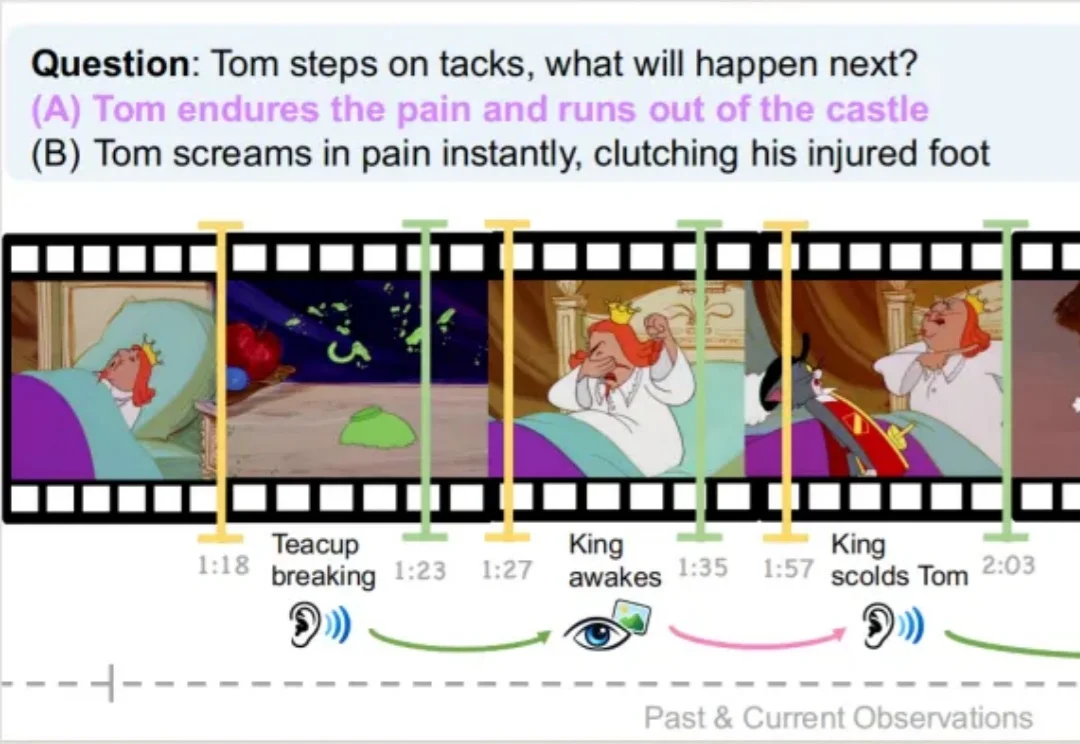
复旦大学、上海创智学院与新加坡国立大学联合推出首个全模态未来预测评测基准 FutureOmni,要求模型从音频 - 视觉线索中预测未来事件,实现跨模态因果和时间推理。
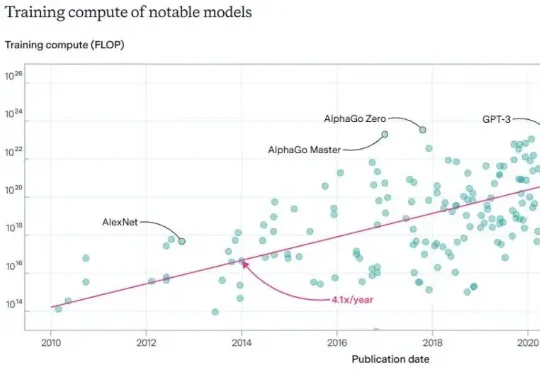
新加坡国立大学(NUS)的尤洋教授近期发表了一篇深度分析:《智能增长的瓶颈》。在这篇分析文章中,尤洋教授从技术本质出发,直指智能增长的核心矛盾,为我们揭示了 AGI(通用人工智能)的可能路径。
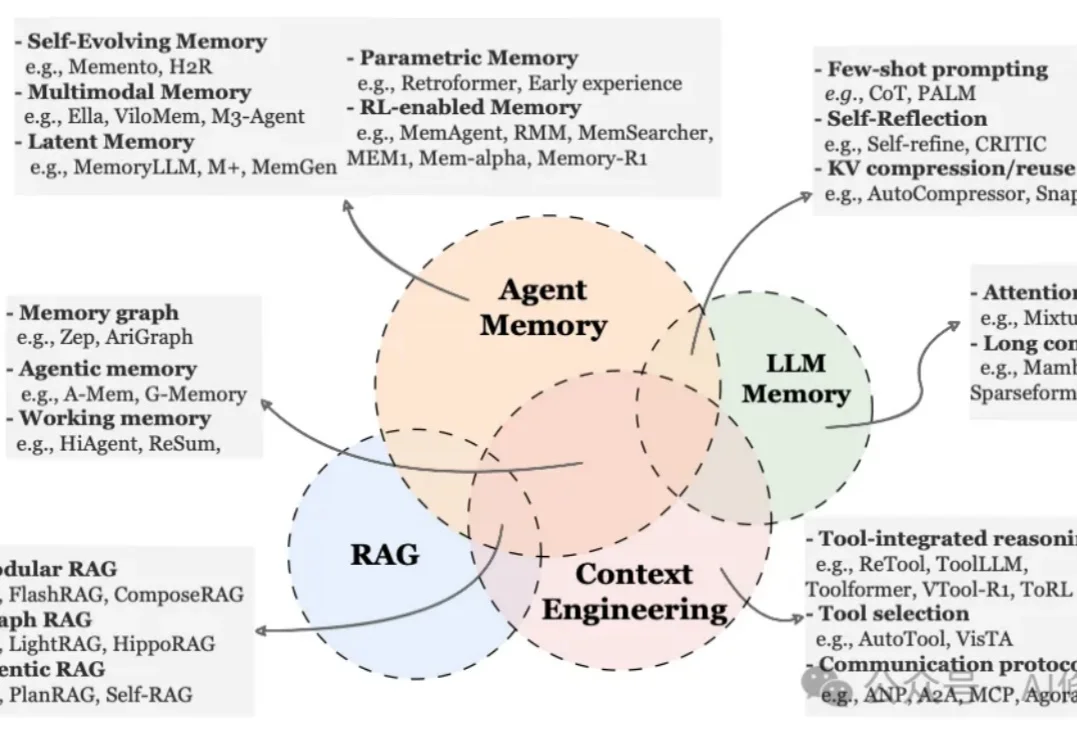
就在昨天,新加坡国立大学、中国人民大学、复旦大学等多所顶尖机构联合发布了一篇AI Agent 记忆(Memory)综述。
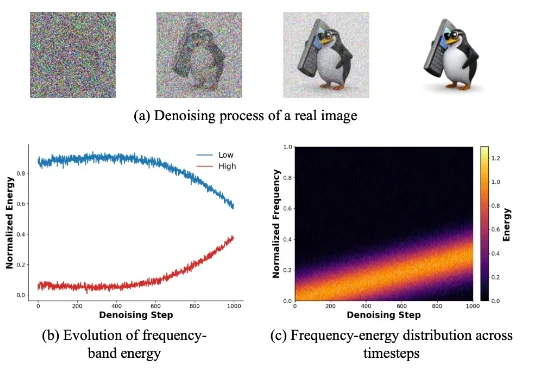
新加坡国立大学 LV Lab(颜水成团队) 联合电子科技大学、浙江大学等机构提出 FeRA (Frequency-Energy Constrained Routing) 框架:首次从频域能量的第一性原理出发,揭示了扩散去噪过程具有显著的「低频到高频」演变规律,并据此设计了动态路由机制。
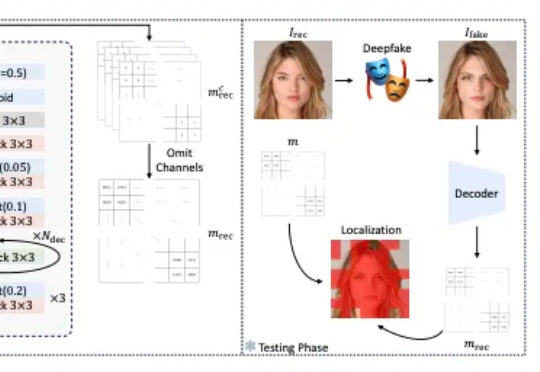
该论文提出 FractalForensics,一种基于分形水印的主动深度伪造检测与定位方法。不同于以往的水印向量,为达成伪造定位的功能,论文提出的水印以矩阵形式出现。
近日,来自普渡大学、德克萨斯大学、新加坡国立大学、摩根士丹利机器学习研究、小红书 hi-lab 的研究者联合提出了一种对离散扩散大语言模型的后训练方法 —— Discrete Diffusion Divergence Instruct (DiDi-Instruct)。经过 DiDi-Instruct 后训练的扩散大语言模型可以以 60 倍的加速超越传统的 GPT 模型和扩散大语言模型。