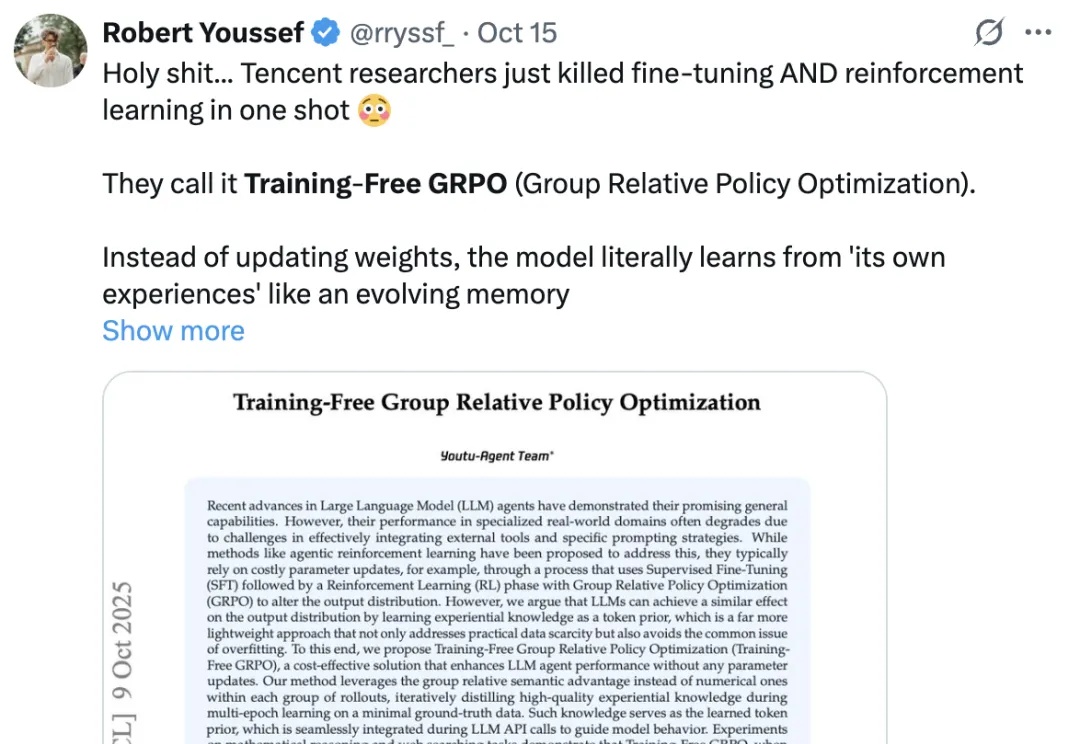
X上63万人围观的Traning-Free GRPO:把GRPO搬进上下文空间学习
X上63万人围观的Traning-Free GRPO:把GRPO搬进上下文空间学习年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
来自主题: AI技术研报
8732 点击 2025-10-23 11:41

 搜索
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
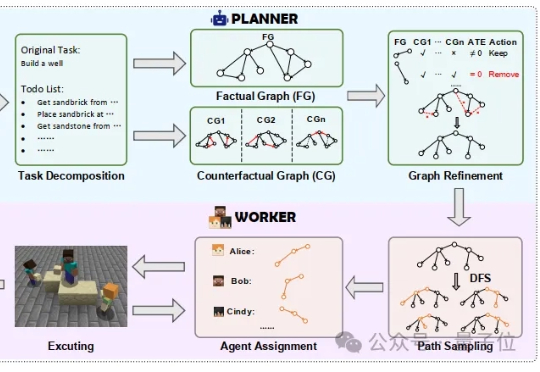
在长周期、多步骤的协作任务中,传统单智能体往往面临着任务成功率随步骤长度快速衰减,错误级联导致容错率极低等问题。
嘿,大家好!这里是一个专注于前沿AI和智能体的频道~
近年来,大型语言模型(LLM)在处理复杂任务方面取得了显著进展,尤其体现在多步推理、工具调用以及多智能体协作等高级应用中。这些能力的提升,往往依赖于模型内部一系列复杂的「思考」过程或 Agentic System 中的 Agent 间频繁信息交互。

在多智能体AI系统中,一旦任务失败,开发者常陷入「谁错了、错在哪」的谜团。PSU、杜克大学与谷歌DeepMind等机构首次提出「自动化失败归因」,发布Who&When数据集,探索三种归因方法,揭示该问题的复杂性与挑战性。

今年的4月26日,我们测评了百度新发布的多智能体协作应用心响APP。当时只上线了安卓版,很多网友在线求苹果版链接。
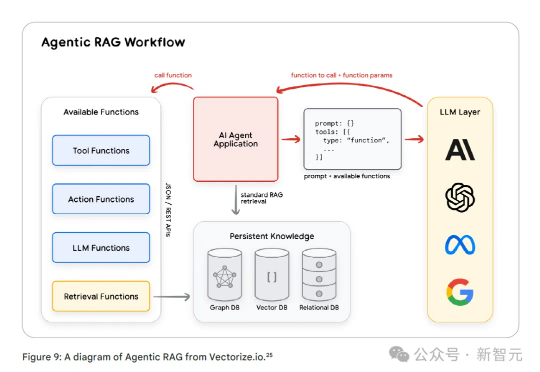
谷歌最新发布的76页AI智能体白皮书,深入剖析了智能体的应用前景。智能体通过感知环境、调用工具和自主规划,能够完成复杂任务并做出高级决策。从智能体运维(AgentOps)到多智能体协作,这份白皮书为AI智能体指明了方向。
当AI与工具相结合,智能体不再只是概念!Minion-agent整合多框架能力,解决碎片化问题,支持多智能体协作与工具调用,降低开发门槛,已在多个场景中展现高效能力,有望推动AI智能体创新和普及!

在人工智能快速发展的今天,单一大模型在处理复杂任务时的局限性日益凸显。微软研究院最新发布的Magentic-One系统,通过创新性的多智能体协作架构,展示了突破这一瓶颈的新方向。

近年来,具身智能(如自动驾驶和机器人等自主智能体)取得了迅猛发展。