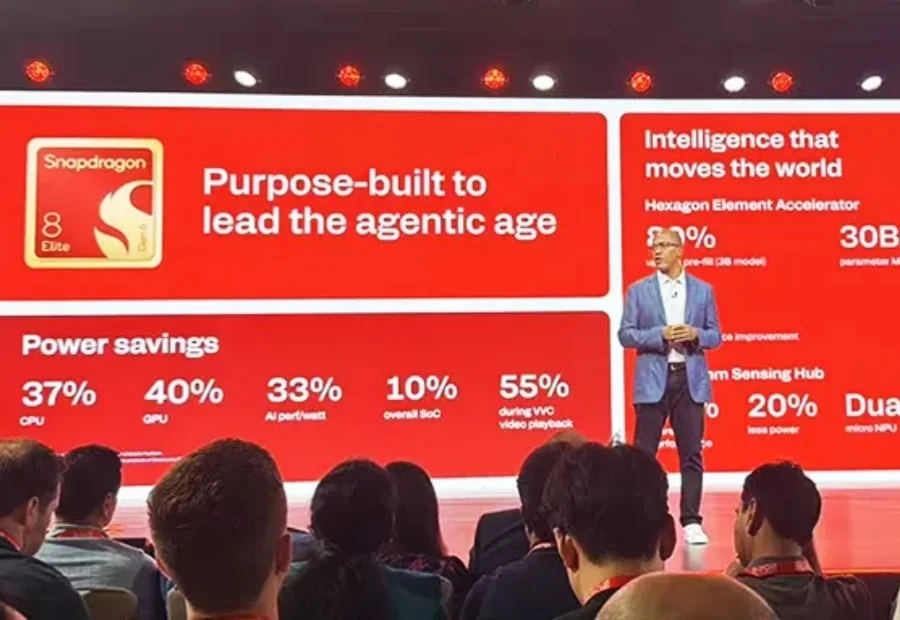
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
来自主题: AI资讯
6809 点击 2026-09-23 10:19

 搜索
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
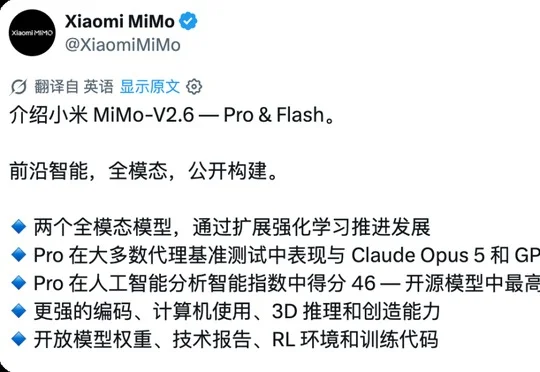
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
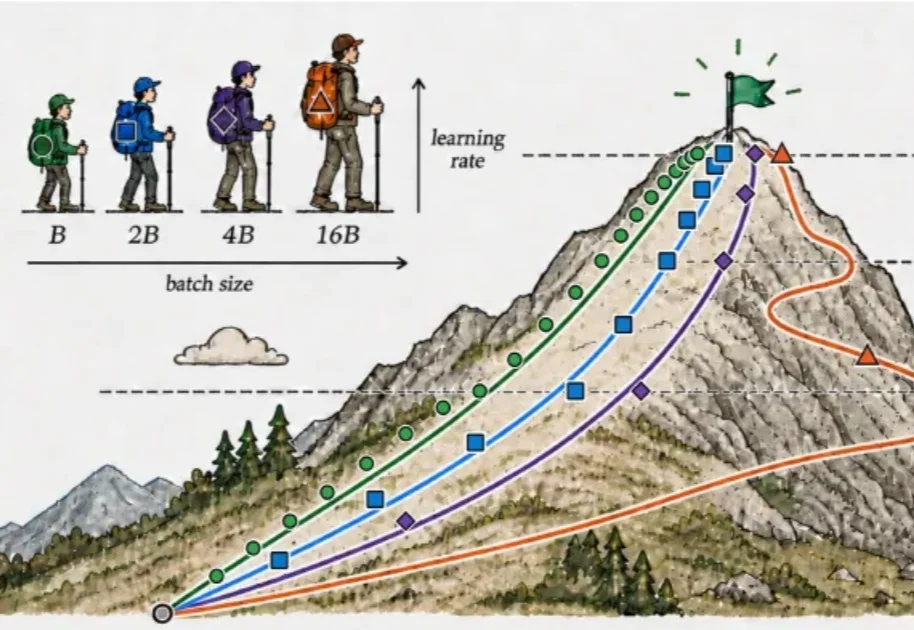
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
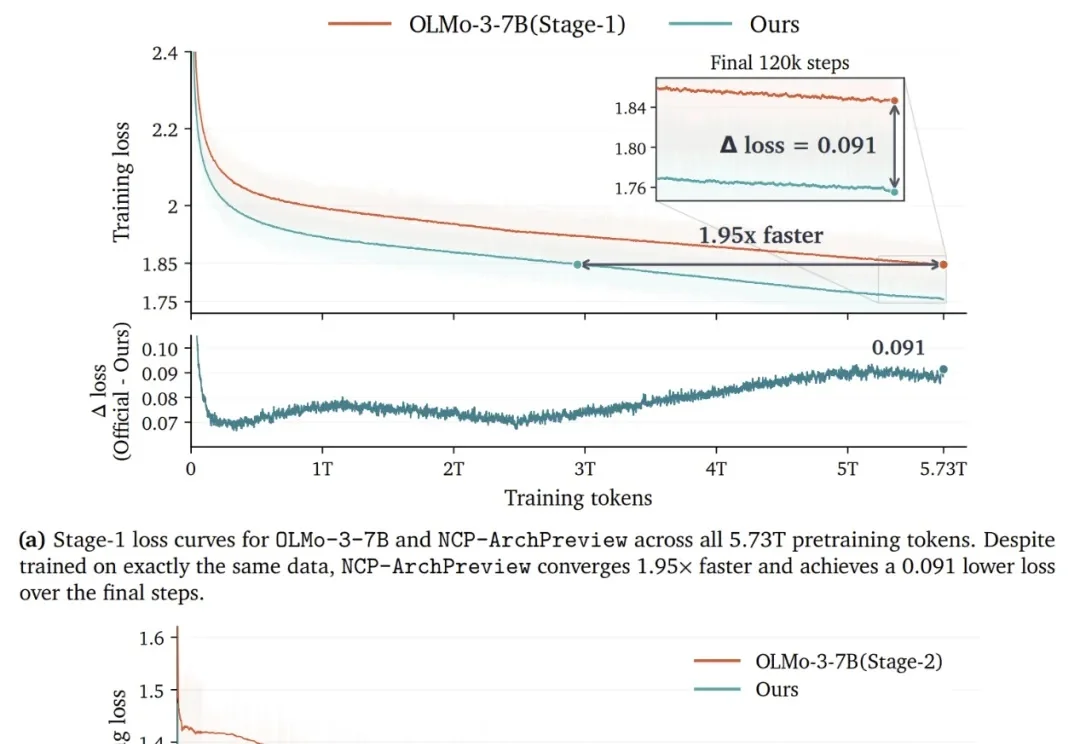
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
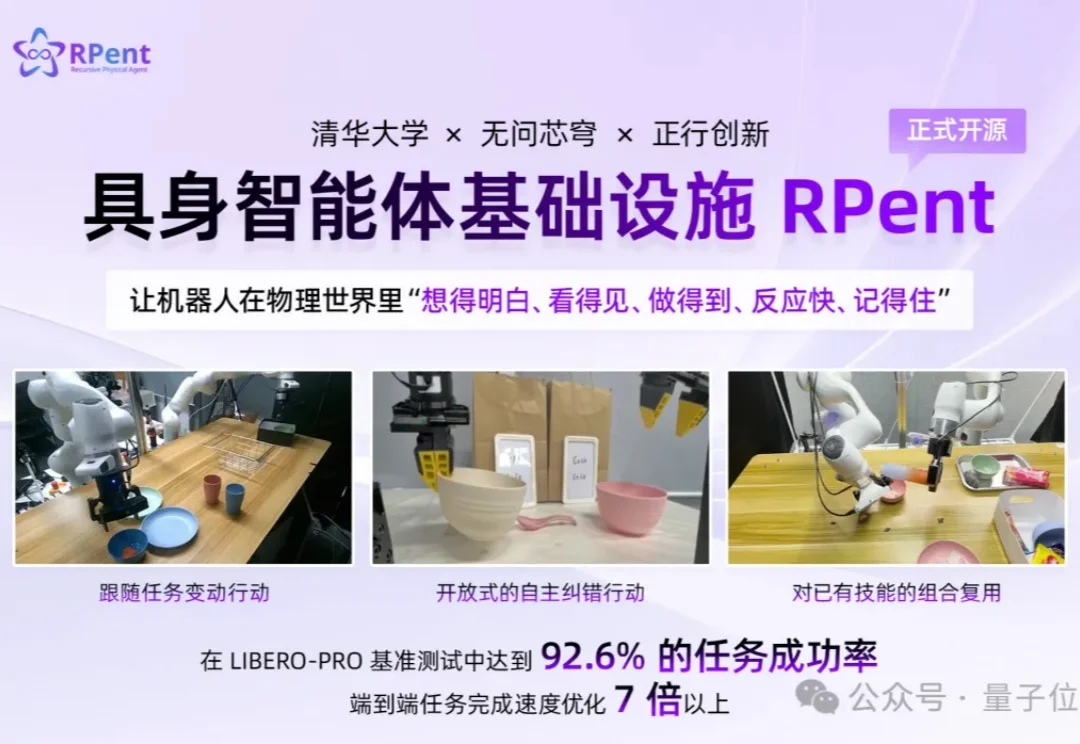
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
《读佳》获知,腾讯推出面向外部行业人才的专家平台“混元智囊团”,平台Slogan为“聚智为谋,引领未来”。该平台隶属于腾讯混元旗下,通过连接各领域顶尖实战专家与真实AI训练问题,以高质量数据集生产、专业内容编写、知识审核为核心工作,产出的专家资源与专业数据服务于混元大模型持续迭代优化。
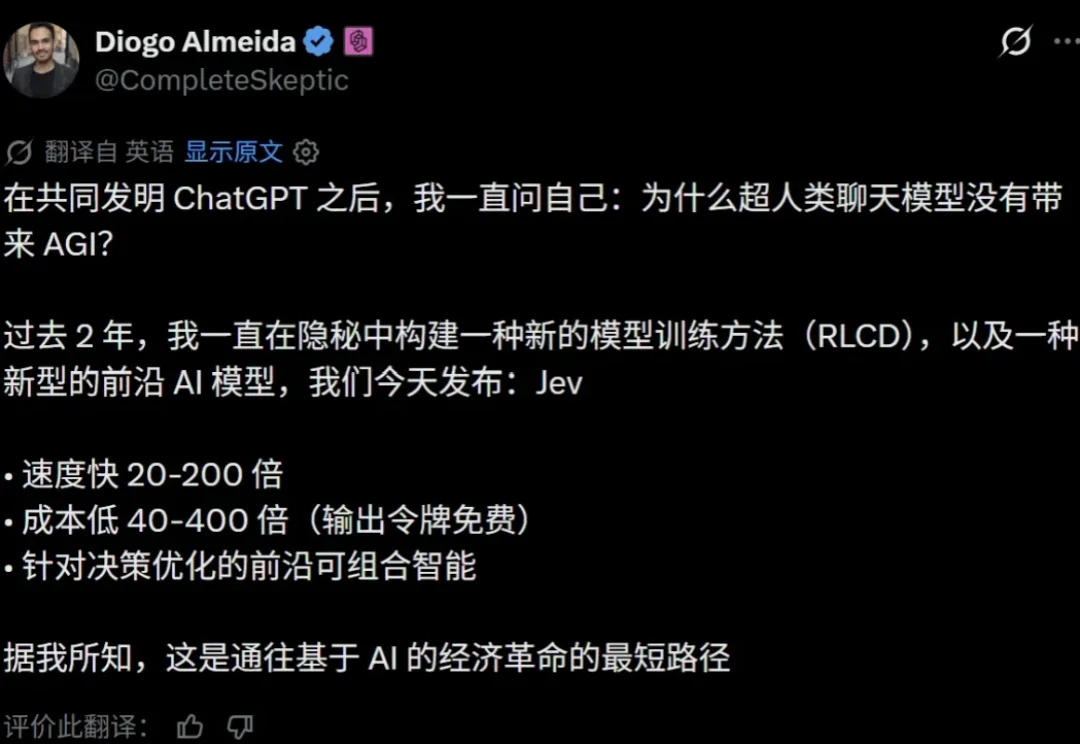
最近,一个不会说话的大模型在网上火了。
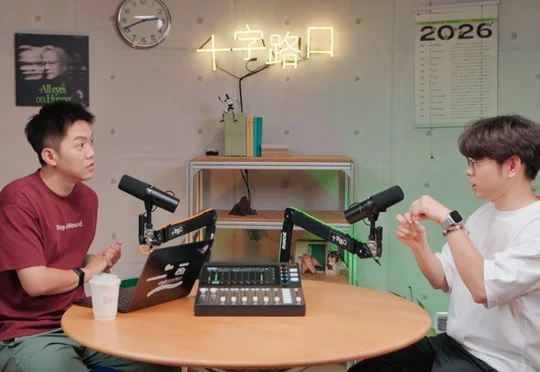
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
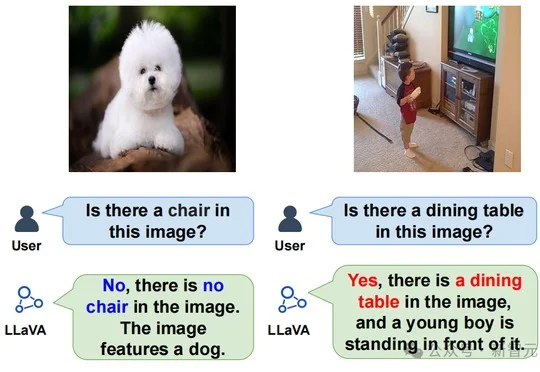
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
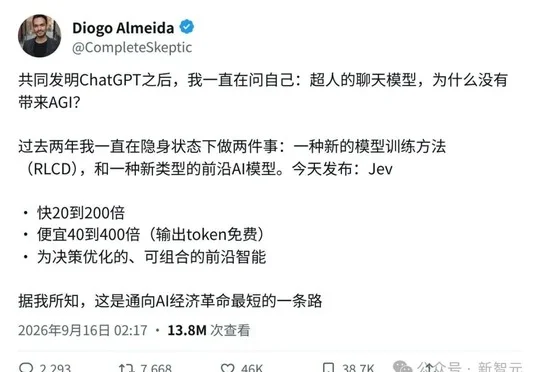
就在今天,整个硅谷都被Jev刷屏了!发布仅三天,它就被Vercel、Cloudflare和LangChain等主流平台迅速集成,有人说,我们即将迎来自动化智能的大爆发!而这场狂欢的主角,竟然是一个不会说话的大模型。