答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励
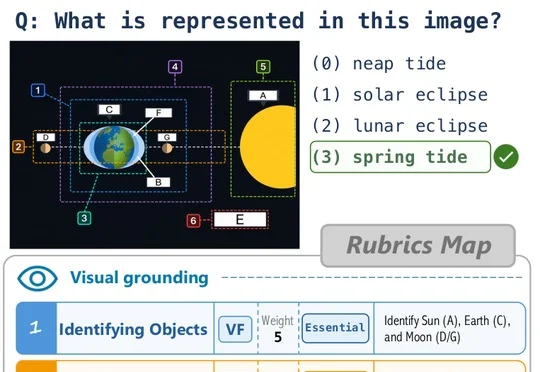
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
搜索
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
单点智能撑不起物理世界,华为报告指向系统进化。 作者 | 王涵 编辑 | 漠影 2026年,资本正在为AI走进物理世界疯狂下注。 IT桔子数据显示,截至5月11日,国内具身智能领域今年已披露投资218
韩国将国家经济与股市押注在三星和SK海力士的HBM芯片上,AI浪潮催生半导体员工天价奖金与全民加杠杆炒股爆仓并存的畸形格局,导致青年失业恶化与社会撕裂加剧。
在云栖大会上,米哈游披露千亿AI布局:通过AI帕姆让NPC具备活人感,用AI Gameplay实现千人千面游戏体验,以EchoX平台与多Agent协作反哺研发,并让游戏成为训练自进化Agent的练级场,形成AI进入游戏、游戏反哺AI的完整闭环。
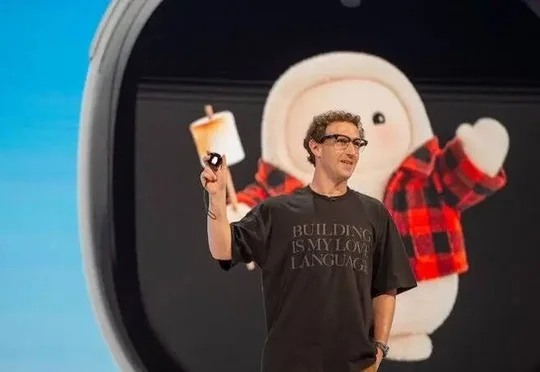
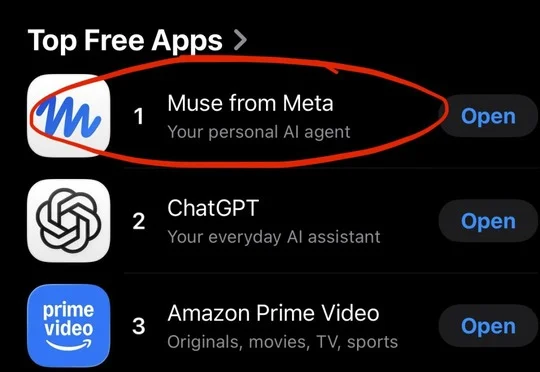
Meta的个人智能体产品Muse上线12天下载量超越ChatGPT,掀起Personal Agent热潮,但受中美生态差异及算力成本等制约,字节、阿里、腾讯等国内大厂难以直接复制其成功路径。
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
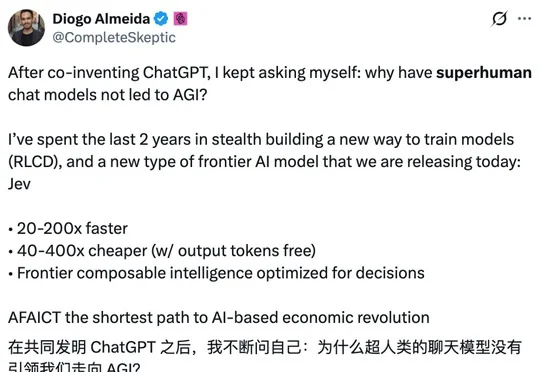
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。
AI模型Jev开发商TypeSafe AI在9天内估值从2亿美元暴涨50倍至100亿美元以上,正洽谈逾10亿美元融资,Jev作为专为软件和Agent提供快速低成本判断的"System One模型"凭借Vercel等平台的快速采用获得投资人追捧。
Meta在Connect大会上发布由前苹果界面设计主管、液态玻璃缔造者Alan Dye操刀的掌上AI设备Muse Charm,内置2英寸触摸屏和5G调制解调器,可让AI助手Muse脱离手机独立运行,计划于今年12月假日购物季发售。
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。