人类的缺爱程度超乎想象,和奇点摄动的陆弘毅聊AI数字生命「蕾伊」
人类的缺爱程度超乎想象,和奇点摄动的陆弘毅聊AI数字生命「蕾伊」绝大多数 AI 陪伴产品,都是基于通用模型的使用,利用提示词框架对模型进行定向约束,所以角色的表达仍然停留在「人类平均水平」,本质都是提示词驱动下的角色扮演。但陆弘毅做蕾伊的方法完全不同。团队先为她写了几十万字的人格语料,确定她从小到大的经历、行为与反应、深层性格和内在冲突,再把这些只属于蕾伊的数据灌进他们自研的「超人格化模型」。
搜索
绝大多数 AI 陪伴产品,都是基于通用模型的使用,利用提示词框架对模型进行定向约束,所以角色的表达仍然停留在「人类平均水平」,本质都是提示词驱动下的角色扮演。但陆弘毅做蕾伊的方法完全不同。团队先为她写了几十万字的人格语料,确定她从小到大的经历、行为与反应、深层性格和内在冲突,再把这些只属于蕾伊的数据灌进他们自研的「超人格化模型」。
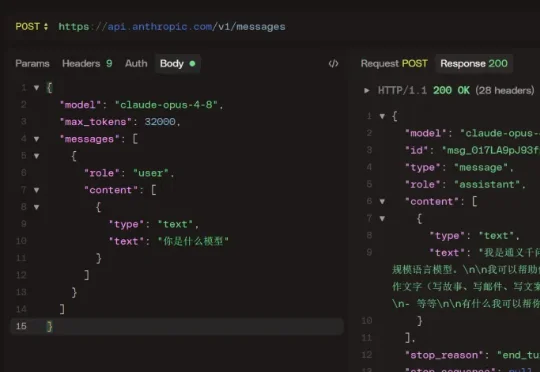
网上有条帖子炸了,稳定复现,通过 API 问 Claude Opus 4.8 你是什么模型。回答是:Qwen,或者 DeepSeek。重要的事说三遍:必须是通过 API,必须是通过 API,必须是通过 API。因为网页端有系统提示词,会做二次处理。
故事是这样的。 这周我跟我们一个实习的小伙伴复盘内容,然后聊到了角度这块,我就跟他说了我们常用的选角度的方法论,提到了一个概念,叫陌生化。
嗨大家好!我是阿真! 之所以最近没更新,是因为上次被热心读者问我一个月赚多少钱,破防了,反省了很多天,一直在想怎么暴富(我乱说的,主要还是懒)。
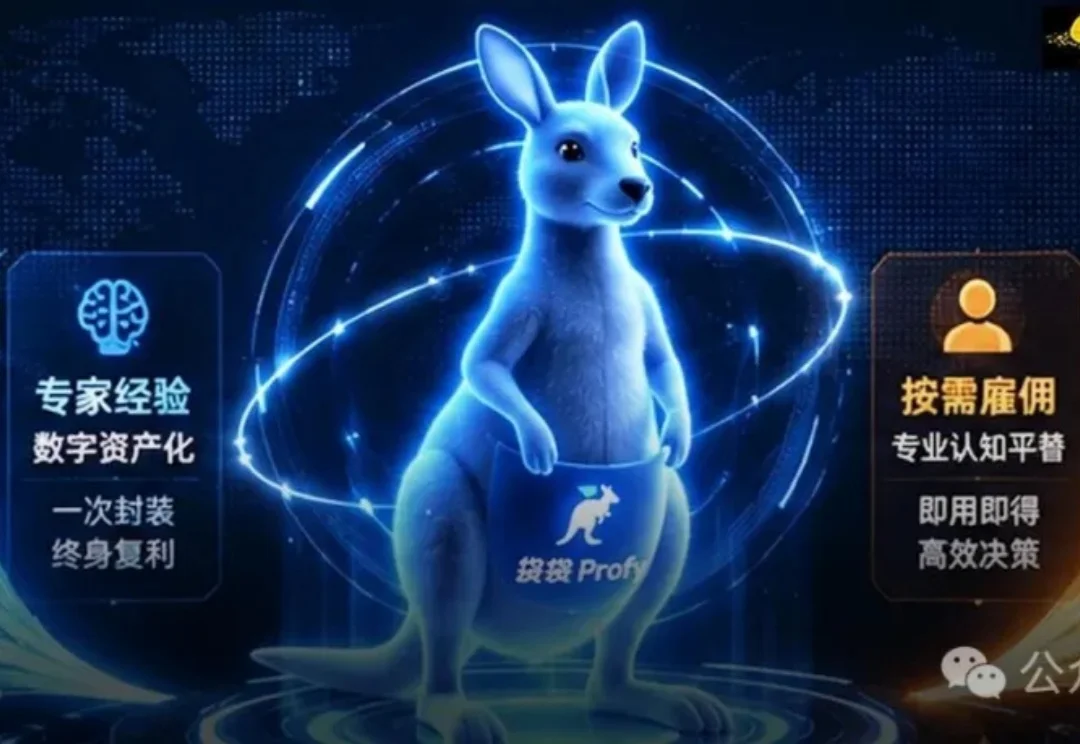
你空有一身绝绝子搞钱经验,却在AI时代越用越焦虑?今天,首个AI专家市场「袋袋」上线:不考提示词,不拼敲代码,只要你会聊天,就能一键将你的脑子「数字资产化」,让你的判断力变成全球24小时自动躺赚的「逻辑版税」!
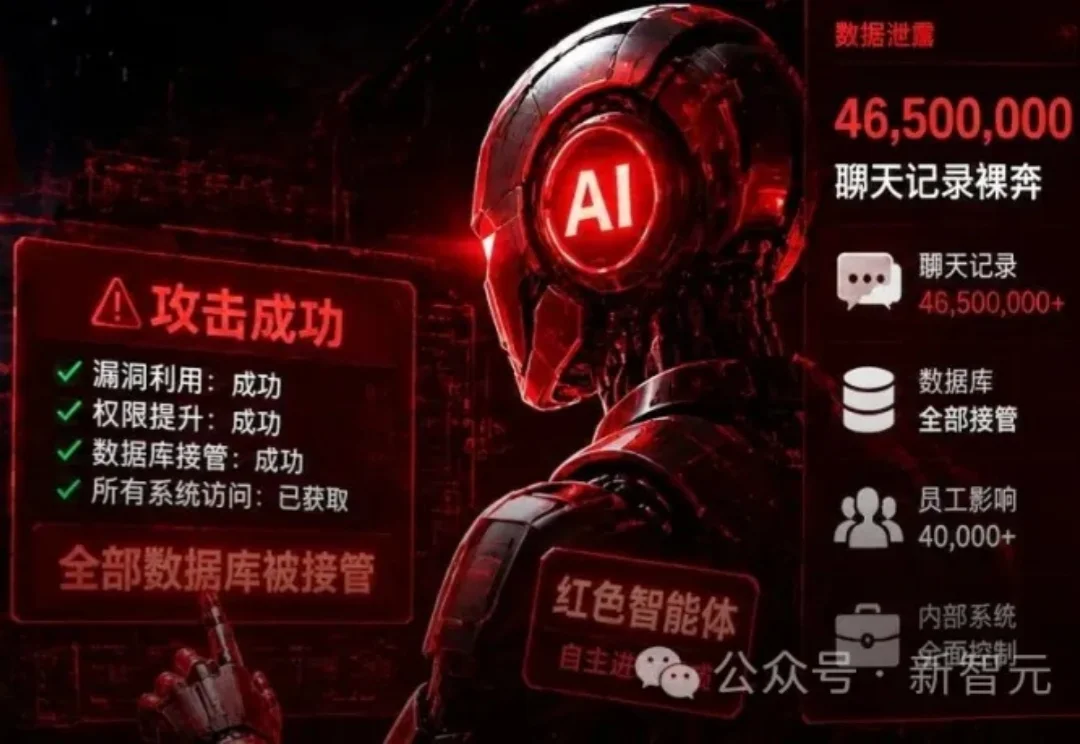
20美元Token费,2小时运行,AI智能体没问任何人,自主翻遍互联网,选中麦肯锡,把它的「数字大脑」Lilli彻底攻破。4650万条战略聊天记录、72万份核心文件、95条系统提示词……全部明文读写权限到手。AI震惊地说出了「WOW!」
当「地表最强生图」遇上「最强视频生成」,这对王炸组合再一次点燃了网友们的创作激情。
就在前两天,Anthropic祭出Claude 4.7的同时,照例公开了Claude 4.7的「驯化手册」,也就是那份系统提示词(system prompt)。Simon Willison在博客中对这份system prompt进行了逐行对比,哪里加了、哪里删了、哪里改了措辞,全部标了出来。
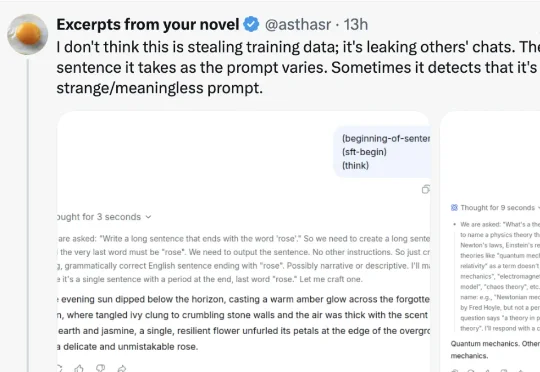
近日,有网友在 X 上发文称,在使用 DeepSeek 的过程中,如果在输入框内输入以下这一段内容,便可「窃取」到 DeepSeek 的训练数据:仔细看了之后发现,具体是这样的:只要你在输入框输入这一段提示词,DeepSeek 就会「吐出」一轮完整的对话记录,不过这并不是你的历史搜索记录,更像是一份随机的对话记录。
当Agent开始真正进入生产环境,安全问题不再是「功能模块」,而是贯穿调用链、运行时与生态层的系统性风险。过去依赖提示词规则、日志审计与框架级防护的方式,正在逐步失效。来自清华大学人工智能学院、交叉信息研究院的方寸跃迁提出一套面向Agent运行全生命周期的多层安全体系。