
世界模型驶入F1赛道:探索极限工况下具身智能体的认知物理边界
世界模型驶入F1赛道:探索极限工况下具身智能体的认知物理边界当自动驾驶赛车以近 300 km/h 的时速在 F1 赛道上与周车进攻防守、交互博弈,它面对的问题早已不只是提升圈速。
来自主题: AI技术研报
7954 点击 2026-08-20 14:19

 搜索
当自动驾驶赛车以近 300 km/h 的时速在 F1 赛道上与周车进攻防守、交互博弈,它面对的问题早已不只是提升圈速。

今天的视频生成模型,已经越来越像一个会拍电影的导演。

十多年前,Ilya Sutskever 说过这么一句话。 「模型就是想学习。」

大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
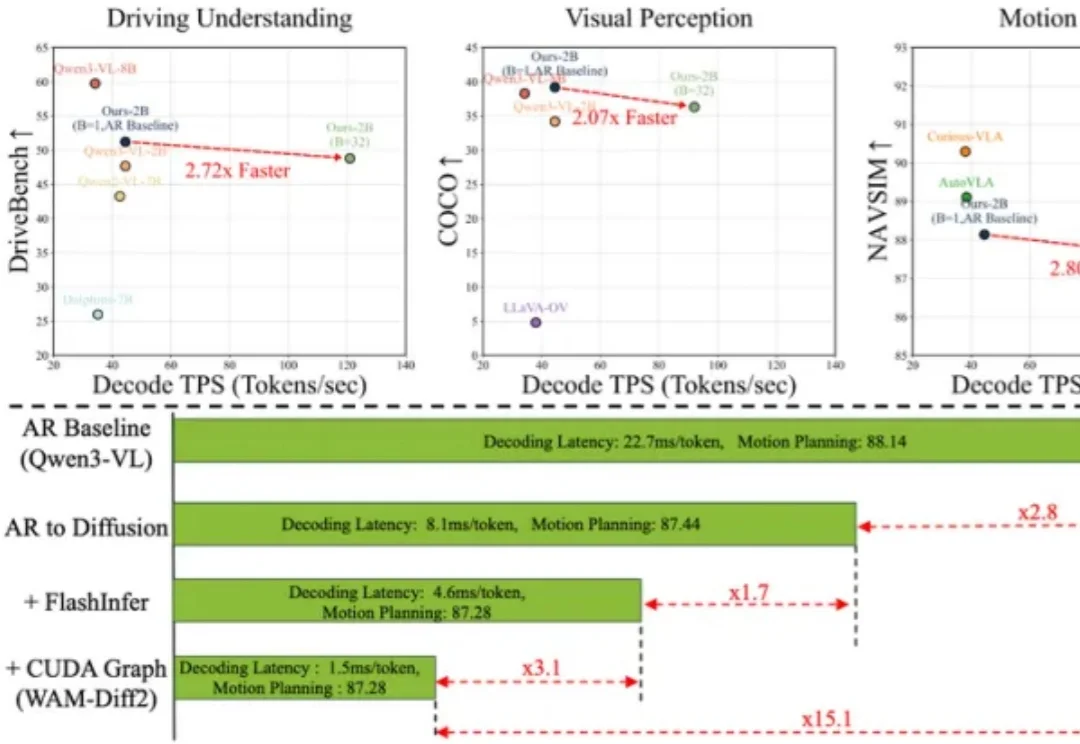
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

图像生成模型正从「会创作」转向「可操作」。

从物理视频生成到运动迁移,再到可控世界建模。

端到端策略模型在物理世界频频失灵,研究者转向 “大模型智能体 + 工具调用” 自救,试图在动态物理世界中持续学习。然而,这条在线学习路径在物理世界仍未真正走通。

给AI一句“生成一款坦克大战游戏”,代码很快跑了起来。

机器人走出实验室后,训练数据不再只是 “多不多” 的问题:环境能否覆盖真实世界的尺度、遮挡、接触和运动,直接决定策略能否落地。Real2Sim 因此重新受到关注 —— 如果普通视频也能变成可交互的仿真场景,采集成本会比人工建模或专用设备低得多。