突发!OpenAI官宣24天攻破100+世界级数学难题
突发!OpenAI官宣24天攻破100+世界级数学难题数学界,真被AI追到家门口了!
来自主题:
AI资讯
8928 点击 2026-09-23 09:57

 搜索
数学界,真被AI追到家门口了!
5天。 不用搭景,不用等演员,导演陆川和团队,直接用AI把一场发生在400年前的明代灾难现场,搓出来了!
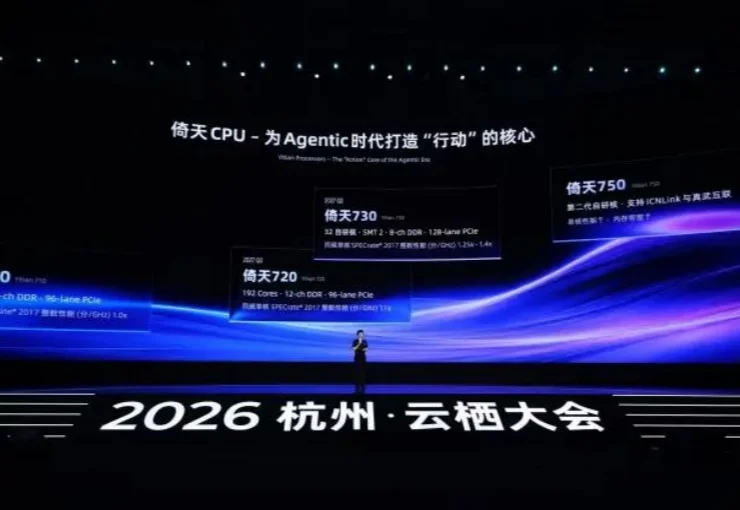
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
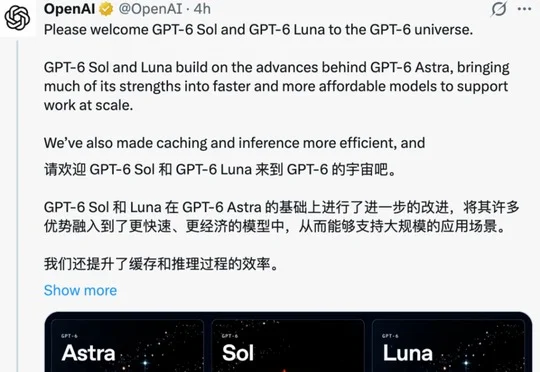
OpenAI同日发布GPT-6 Sol与GPT-6 Luna,API价格相比GPT-5.6腰斩50%,主打单位任务成本优势;Anthropic推出Claude Opus 5.5,典型任务成本降低约40%且输出速度提升超30%,两家厂商围绕"性价比"展开直接竞争。
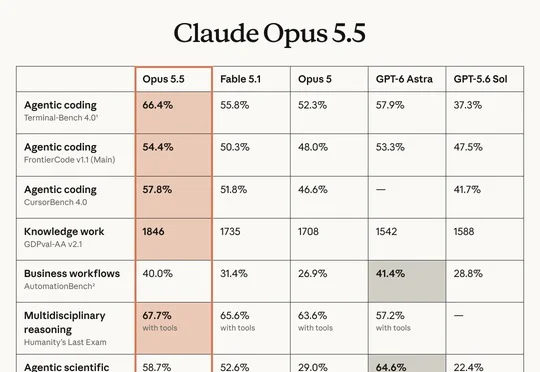
Anthropic发布Claude Opus 5.5,性能追平Fable 5.1且成本降低40%,在Terminal-Bench 4.0和GDPval-AA v2.1等多项基准测试中超越GPT-6 Astra,OpenAI两小时内推出GPT-6 Sol和Luna迎战。
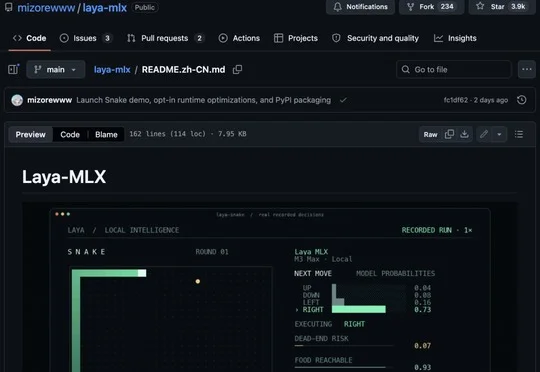
开发者mizorewww将开源决策模型Laya移植到Apple MLX框架,推出本地版Laya-MLX,可在Apple Silicon Mac上以低于1GB内存运行并摆脱PyTorch与云端API依赖,421M版本峰值内存943.6MiB、322M多语言版本687.6MiB。
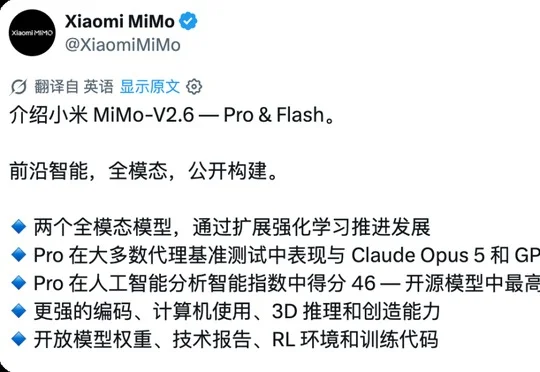
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
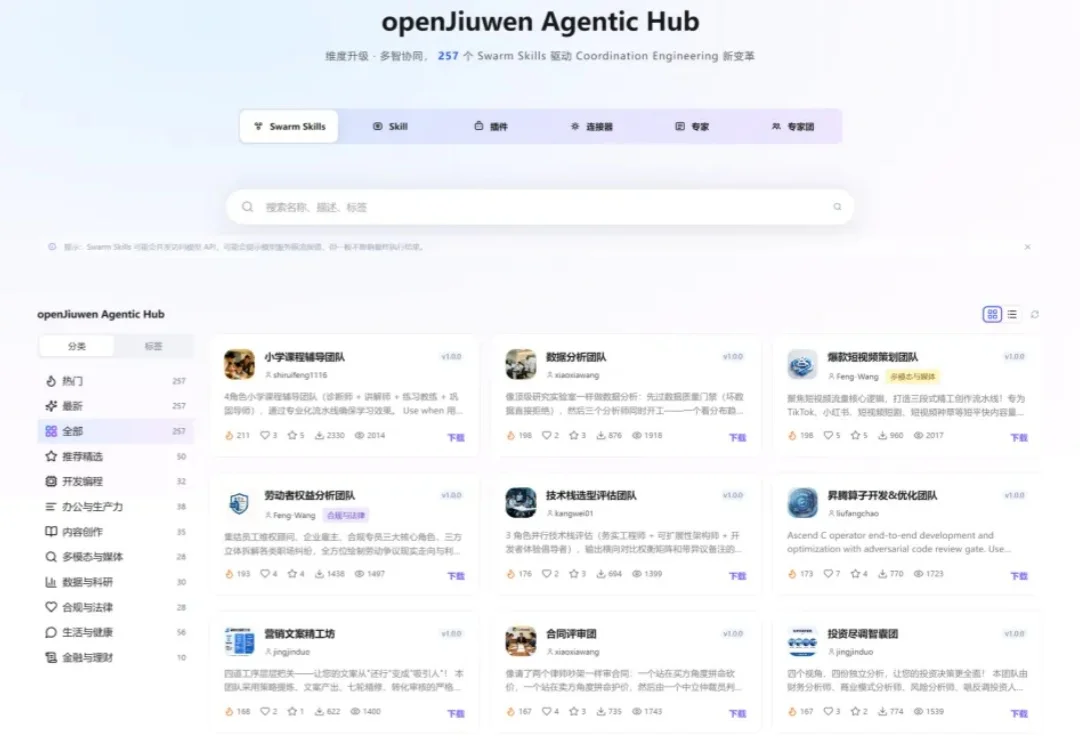
过去一年,Agent 的讨论大多围绕模型本身展开:推理能力更强、上下文更长、工具调用更稳定。但进入真实工作流后,另一个问题开始变得更关键:Agent 的能力从哪里来,又如何被持续复用。
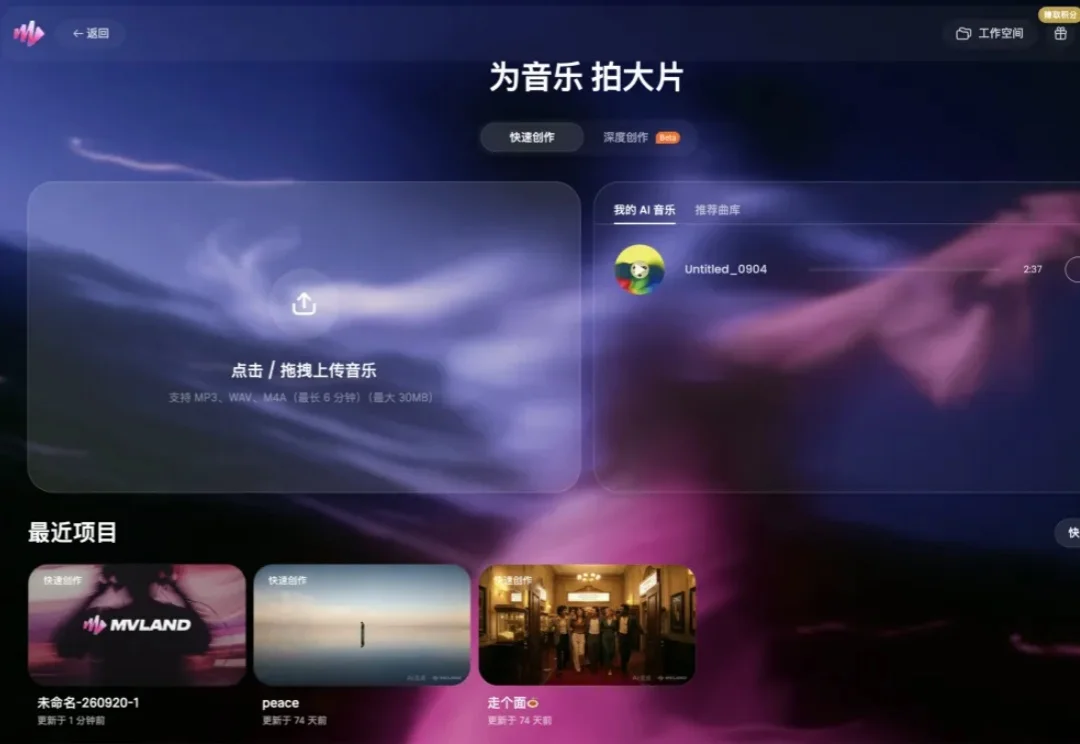
今天中午,看到 MVLAND上线了深度创作模式。
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
个人 AI,环球同此凉热。
AI视频,已经开始挑战「实时造世界」了!
物理隔离,有可能阻止失控AI吗?
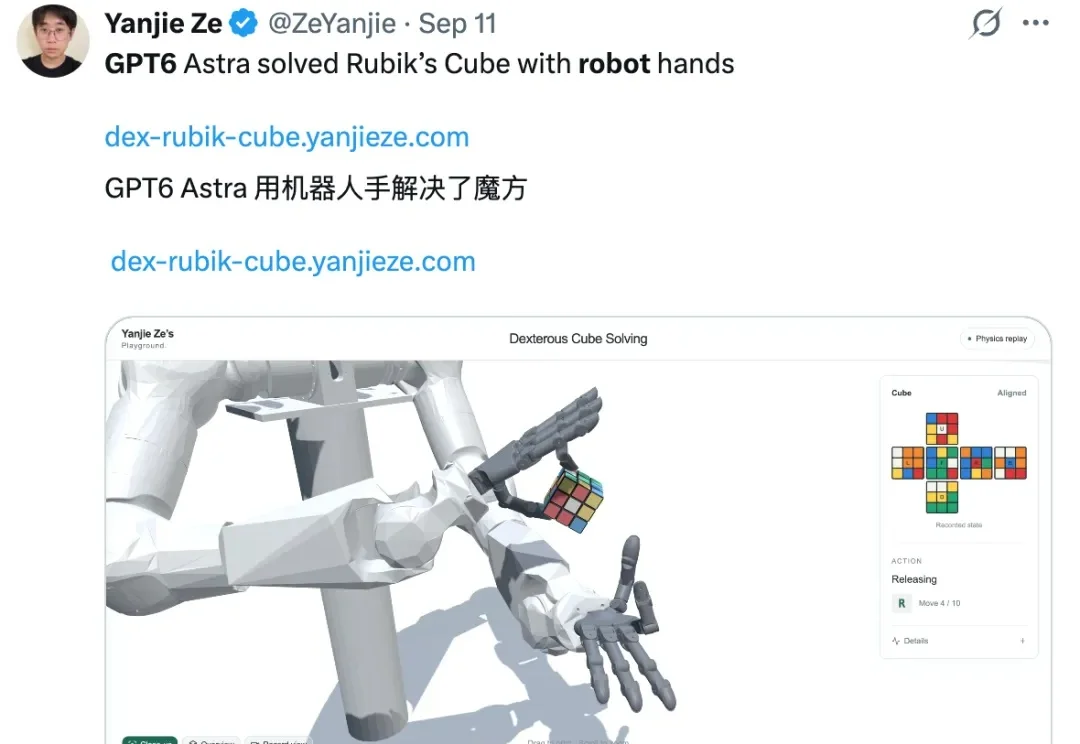
谁也没想到, AGI 随着 GPT-6 的到来竟然来得这么快。
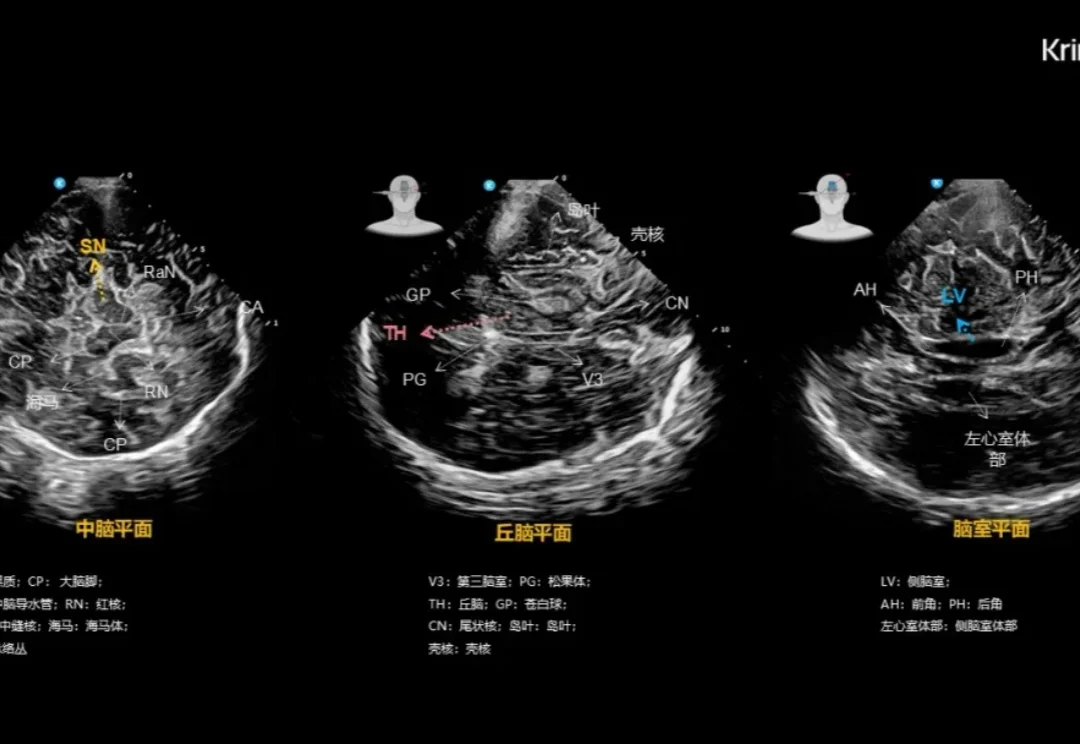
2026 年 9 月,马斯克的 Neuralink 临床试验接受 27 例受试者,计划开启大规模量产。舆论再次沸腾,仿佛脑机接口的未来已到。
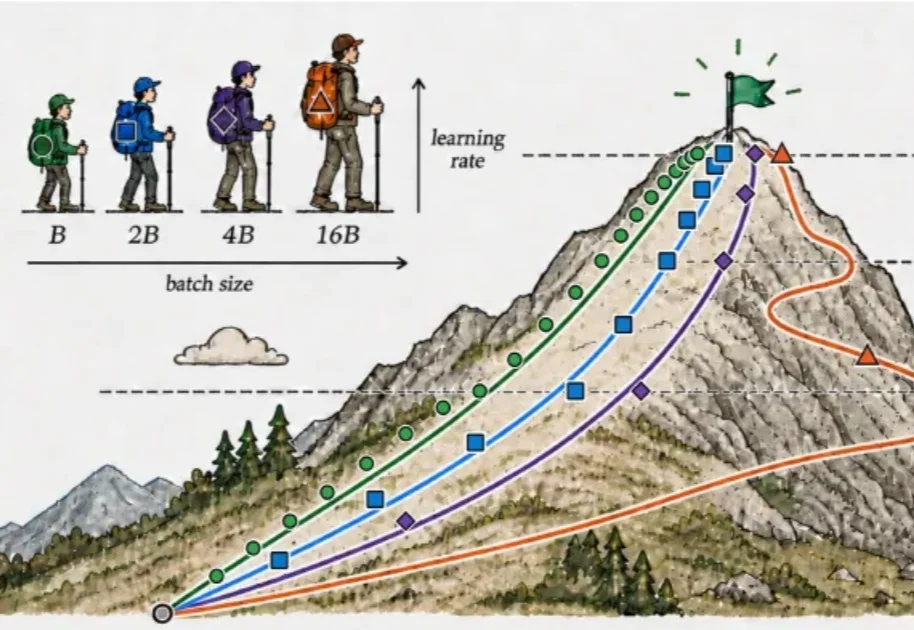
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
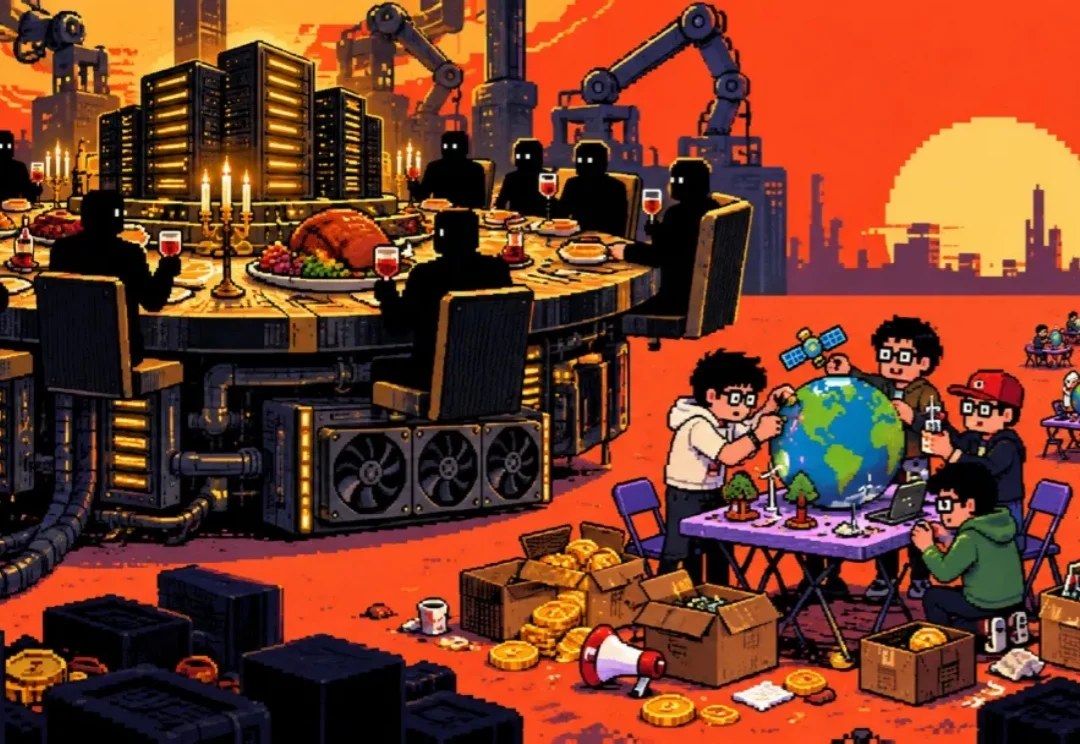
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
当AI不再只会聊天。
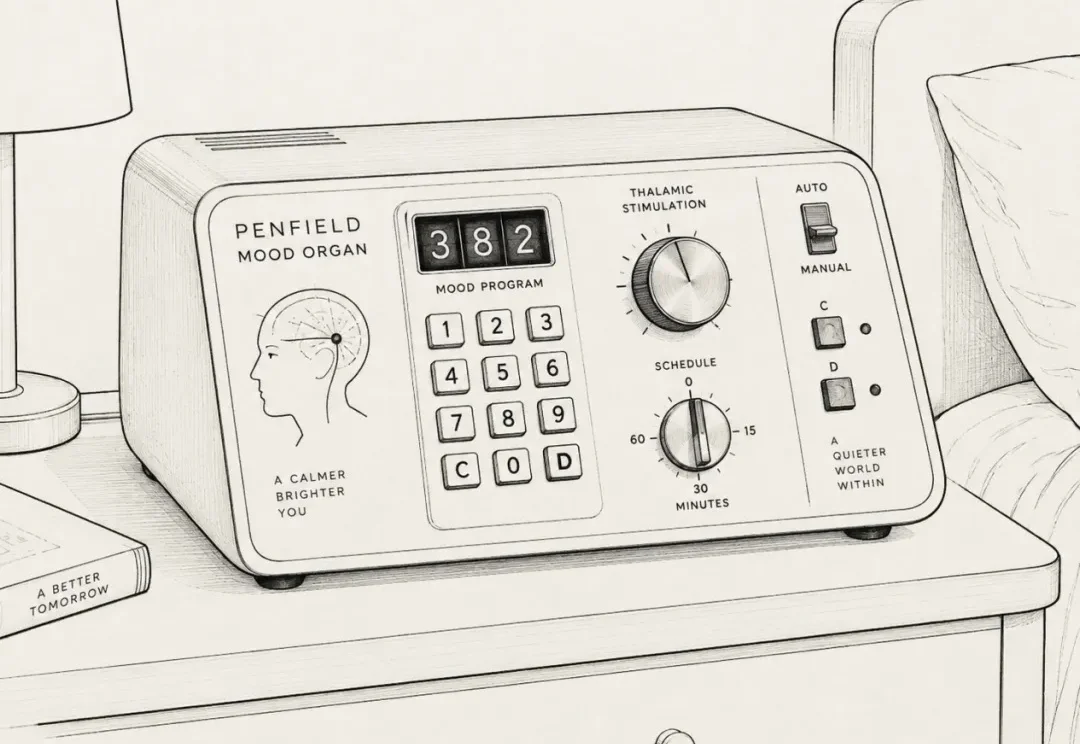
科幻小说《仿生人会梦见电子羊吗》中有一个有趣的设定:人类可以使用一种叫「情绪调节器」的设备,通过拨号或设置参数,让机器自动调节心情。
万万没想到,现在结婚,都卷到要用 AI 了。
AI美剧正在制造一种 “国产美剧”新物种
GPT-6 Sol,真要来了!
在一道千禧年大奖难题的解答还在接受数学界审视的同时,超过 100 道长期开放问题也已经被内部模型解决。OpenAI 最新公布的信息描绘了这样的局面。
OpenAI最有钱的人,不是奥特曼。
一款能走进真实工作的生图模型。
NPU与MCU深度融合,嵌入式全栈生态接入AI,TI手握分层布局、软硬协同杀手锏,加速AI规模化落地。
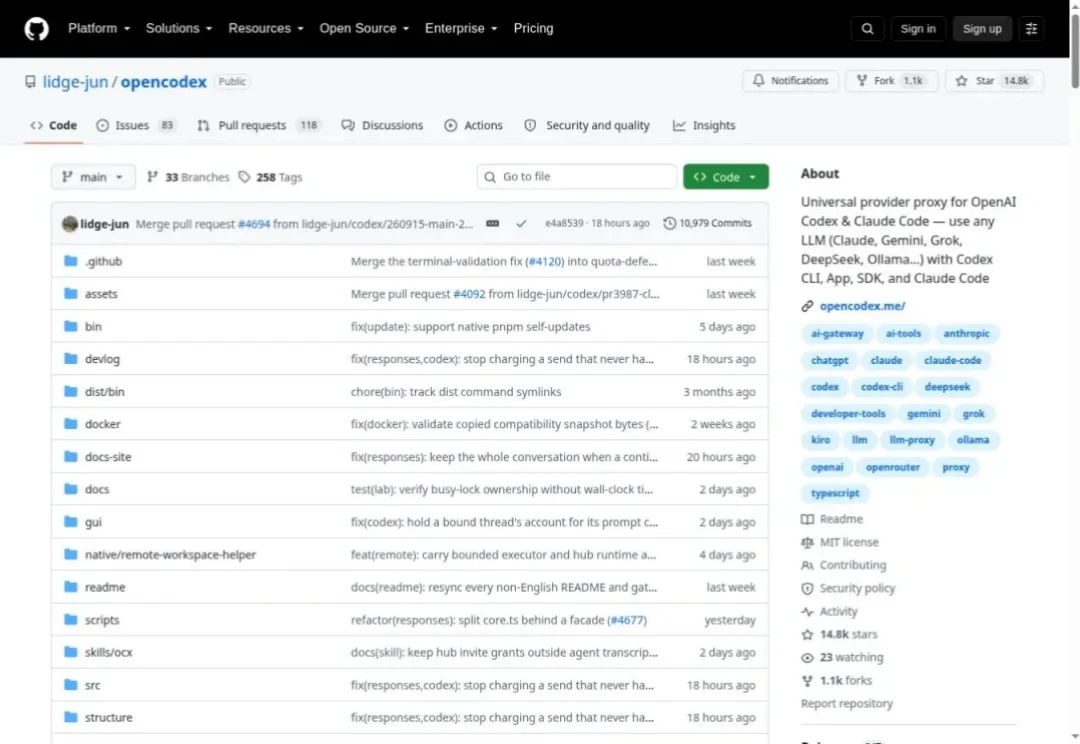
上周发了折腾 WebCodex 的文章《把ChatGPT几乎无限的网页额度当Codex用》,文章下面,就有小伙伴接着问:能不能让不同的模型,去干不同的活?
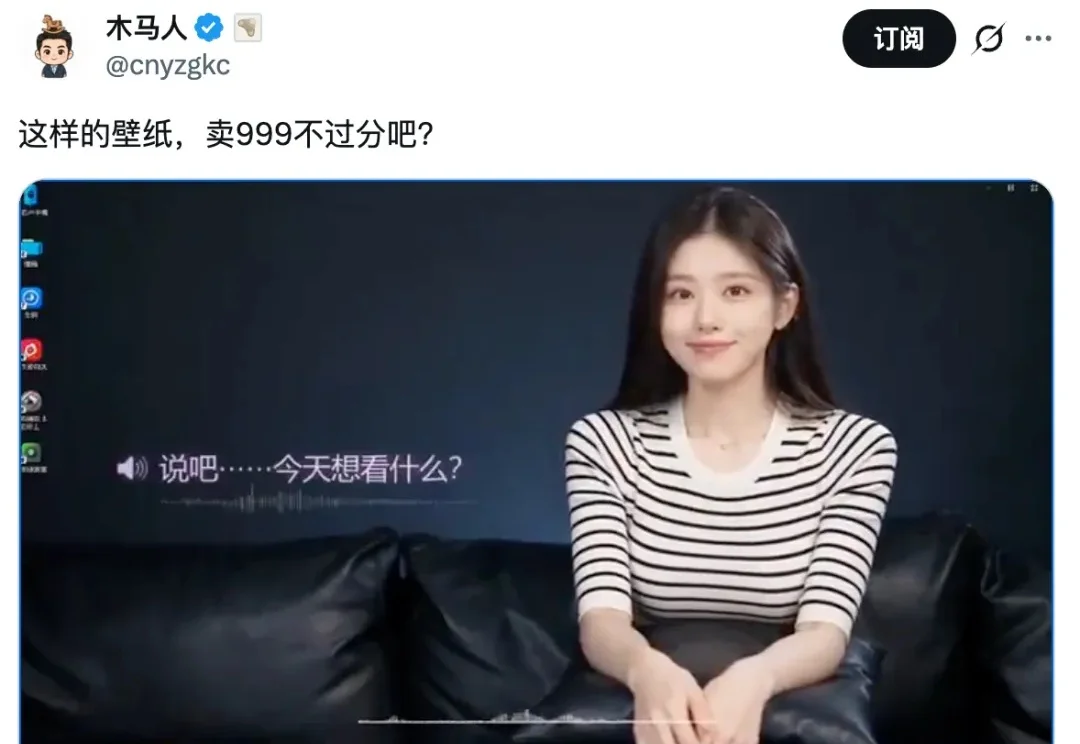
最近 AI 桌面换装视频突然爆火,Twitter 上随便一条就是百万播放。
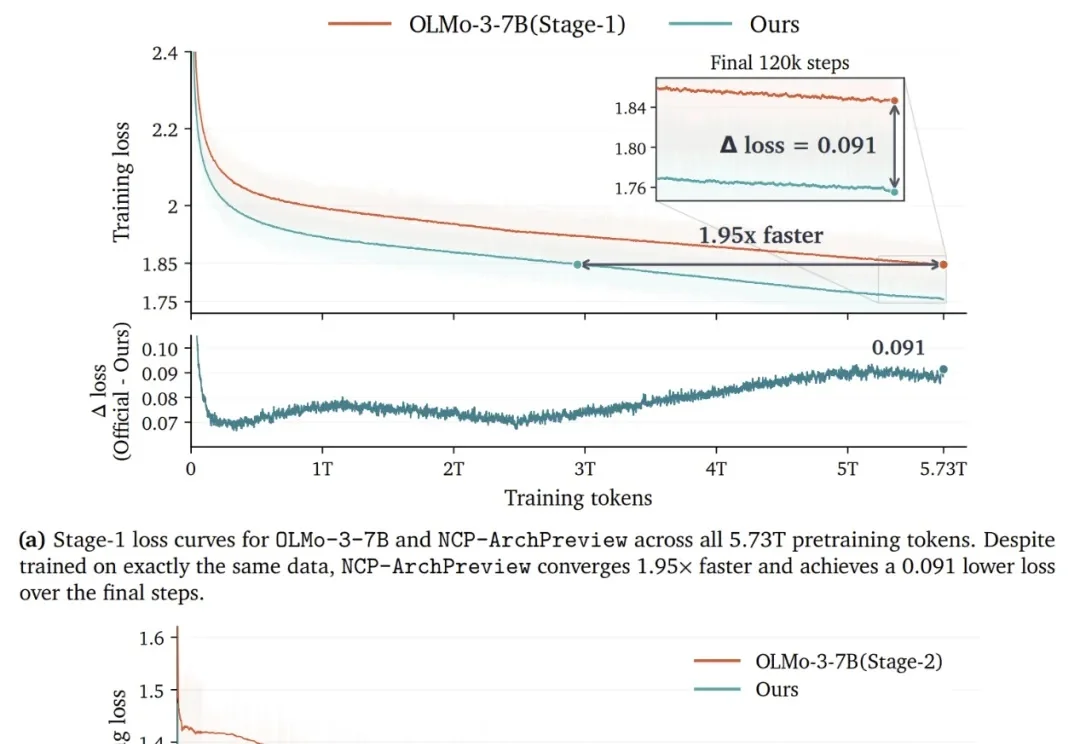
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?

