
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
让视频模型生成一个人打太极,画面可能很流畅。但如果把要求具体到某个招式,手该怎么抬、重心该怎么移,模型还能做对吗?
再加一点难度:指定一个角色,让它完成这套动作;或者要求两个物体按给定条件碰撞,再把一段故事分成三个连续镜头。
这些要求把视频生成带到了更细的层面。动作需要知识,角色需要视觉参照,运动需要物理约束,多个镜头还要保持顺序与连续性。仅靠一句提示词,生成模型未必能把所有细节都处理好。
如果系统可以先查资料、找参考,必要时跑一次模拟,再决定怎样生成视频,会发生什么?
VideoGen-Agent 尝试把这些步骤交给一个可训练的多模态智能体。它以 Qwen3-VL-8B-Instruct 为基础,在多轮交互中调用检索、生成和验证工具,并根据工具返回的结果继续作出决策。研究团队先用监督微调建立工具使用能力,再通过多任务强化学习改进这套决策过程。
在包含 600 条提示词、覆盖六类能力的 VABench 上,VideoGen-Agent 的 Toolset 1 配置取得 75.6 分,相较基础视频生成器的 56.5 分提高 19.1 分。保持智能体参数不变、升级生成工具后,得分进一步达到 86.1 分。在人类比较中,评估者在 84.3% 的判断中更偏好升级配置生成的视频,而非最强单模型基线的结果。
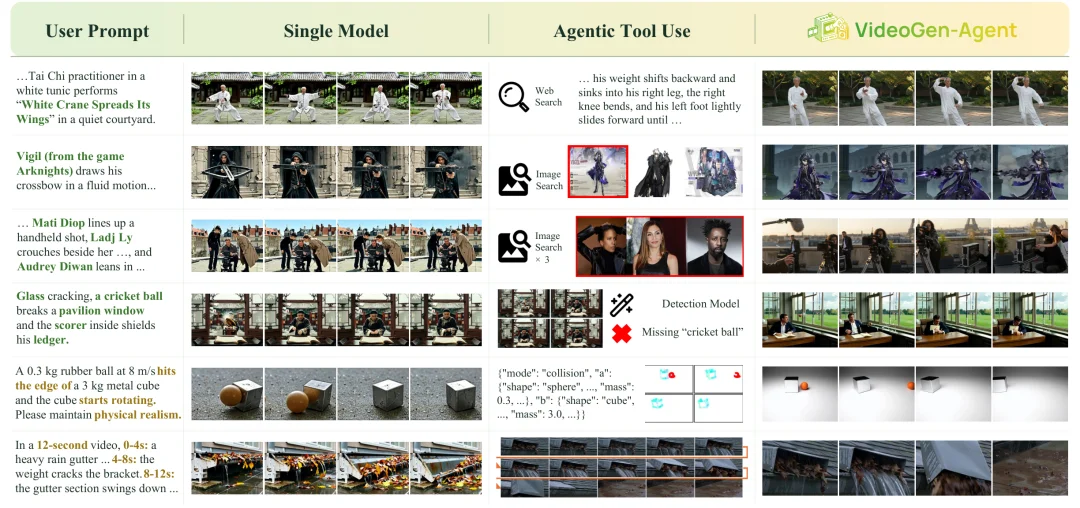
VideoGen-Agent 面向不同生成要求选择工具:检索动作知识、获取视觉参考、模拟物理运动、验证场景结构,以及逐段生成连续镜头。
第一个例子是太极招式「白鹤亮翅」。 图 1 第一行中,单模型已经生成了白衣练习者和庭院,也表现出了武术动作,但展示的姿态更接近泛化的展臂、收手,未清楚体现指定招式的动作细节。Agent 先检索招式说明,将重心后移、右腿屈膝和左脚前移等信息补充到生成输入中。右侧关键帧呈现出逐步抬臂、形成一高一低手位的过程。这里需要补充的是动作知识:提示词中的招式名称被展开成了可供生成器使用的具体描述。
第二个例子是指定游戏角色持弩的场景。 图 1 第二行中,单模型抓住了「人物」和「弩」,却生成了写实风格的兜帽持弩者,未呈现参考素材中的角色造型。Agent 通过图像检索获取视觉参考,再将其交给条件生成工具。右侧结果在发型、服饰和整体角色风格上更贴近图中选用的参考。这个对比说明,仅凭角色名字可能只生成一个语义上接近的人物,而视觉参考能够把身份要求落实到可见的外观特征。
第三个例子要求一段 12 秒视频按三个时间阶段展开。 图 1 最后一行的提示分别规定了三个阶段的内容:先展示承受重压的雨槽,随后支架开裂,最后雨槽向下摆落。相比单模型一次性生成整段视频,Agent 根据 prompt 中的时间结构将视频拆成三组连续镜头,并分别按照对应时间段的子 prompt 进行生成,同时使用上一段的末帧作为下一段的视觉条件。右侧关键帧因此分别对应三个阶段,使不同时间段内要求的事件能够逐段得到满足,并在整体上形成与原始 prompt 一致的时序过程。
这三组样例分别对应动作知识、主体外观和事件顺序。它们展示的是图中这次生成的具体差异;关键帧无法独立证明整段视频的动作精度与时间对齐程度,整体效果还需要结合后面的 VABench 和人类评估来看。
VideoGen-Agent 的工作从理解任务开始。
遇到带有专业知识的动作描述,智能体可以先检索文本资料,把动作步骤和关键细节补充到生成输入中。遇到指定角色、地标或品牌物体,则可以检索图片,选择参考素材,再调用图像或多参考图条件下的视频生成工具。
物理任务提供了另一种工具使用方式。对于给定初始条件的碰撞、下落场景,系统可以通过模拟得到运动条件,再把这些条件交给支持运动控制的视频生成器。这样,生成过程能够使用外部计算得到的运动信息。
工具也可以在视频生成之后发挥作用。例如,一段视频要求多个物体以特定位置关系出现,系统可以利用目标检测和深度估计检查主体与空间结构,并根据反馈决定是否重新生成。
多镜头任务则需要处理前后衔接。智能体可以先生成第一段,提取末帧作为下一段的条件,逐步完成后续镜头。前一段的实际输出,由此成为下一步决策的输入。
这些能力共用一个智能体策略。系统提示中提供工具约束和典型流程,具体执行时,策略根据用户要求和已有观察选择工具、组织参数,并决定是否继续验证或生成。每一步获得的信息,都能影响后续动作。
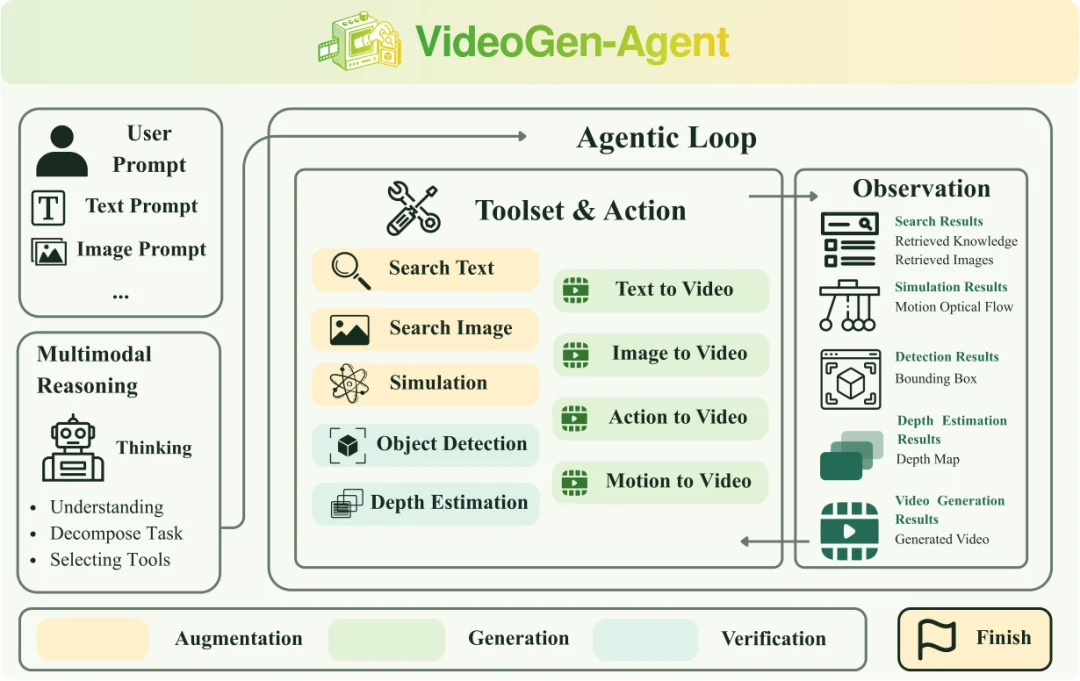
智能体围绕用户提示和交互历史,持续选择工具并读取反馈。工具分为信息增强、视频生成和结果验证三组。图中的 action-to-video 为机器人探索实验的扩展接口,不计入六任务主评测。
把工具接上以后,怎样让智能体学会用好它们?
研究团队为六类任务构建了 24K 条提示及教师交互轨迹。其中,16K 条教师轨迹用于监督微调,让模型学习如何选择工具、填写参数,以及利用工具返回的信息。另有 8K 条提示留给强化学习,智能体在这些任务上重新采样自己的执行过程。
监督微调给出了可供学习的示范。强化学习进一步比较同一任务下不同执行轨迹的表现,让更有效的决策获得更强的训练信号。
难点在于,视频生成很难只靠一个简单的「对或错」判断。工具调用格式正确,不代表工具选得合适;工具选对了,也不保证最终视频满足要求。
因此,训练同时检查三个方面:调用是否有效、工具使用是否符合任务需要,以及视频质量与提示的一致性。三项奖励的权重分别为 0.1、0.4 和 0.5。其中,视频评分使用针对不同任务设计的评价准则,工具奖励还会检查返回结果的利用情况。
这种设计把训练信号连接到了完整执行过程。例如,查到了参考图片以后,图片是否进入后续生成,比单纯记录一次检索调用更有意义;生成了一个流畅片段以后,片段是否体现了指定动作,也需要单独评价。
六类任务的评分分布并不相同。研究还在同一提示下的组相对归一化之后,加入任务类别内的优势归一化,使不同类别的学习信号处于可比较的尺度。整个训练过程更新的是智能体策略,视频生成器作为工具参与交互。
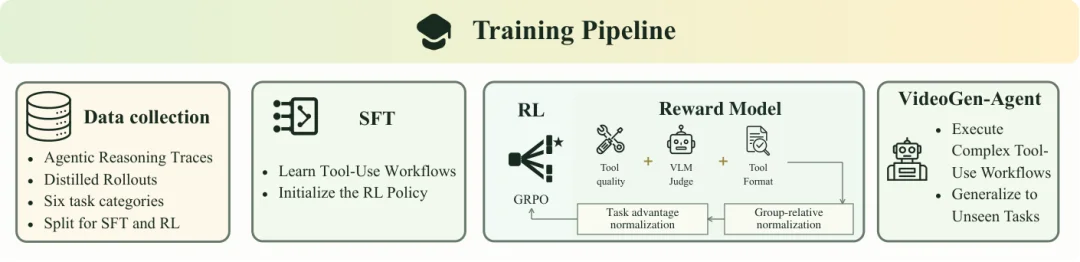
16K 条教师轨迹用于监督微调,8K 条独立提示用于强化学习。混合奖励结合调用有效性、任务相关的工具使用和视频质量,指导共享策略学习。
为了评估工具使用带来的效果,研究团队提出了 VABench:一个面向视频生成智能体的复杂任务基准。它包含 600 条未参与训练的提示,六类任务各 100 条,重点考察系统能否满足知识、身份、物理、场景关系和时序方面的具体要求。
候选提示经过重复检查、VLM 筛选和人工审核,每类从 150 条候选中选取 100 条。评测使用 Gemini 3.1 Pro,按各类别的评价维度与权重给视频打分,归一化到 0—100 分;总分为六类任务得分的等权平均。
六类任务分别考察程序性知识、单主体身份保持、多主体身份保持、物理一致性、场景组合和多镜头时序结构。
这些任务有意突出不同的困难:知识任务关注专业动作和过程;身份任务检查指定主体的视觉特征;场景组合检查主体之间的关系;多镜头任务关注要求的阶段是否出现、顺序是否正确。物理任务的范围限定为碰撞和下落,多镜头任务则包含两到三个等长镜头,每个镜头不超过五秒。
先看整体结果。下表完整列出论文主表中的四个开源视频生成器、四个商业视频生成器,以及 VideoGen-Agent 两套工具配置在六类任务上的表现。
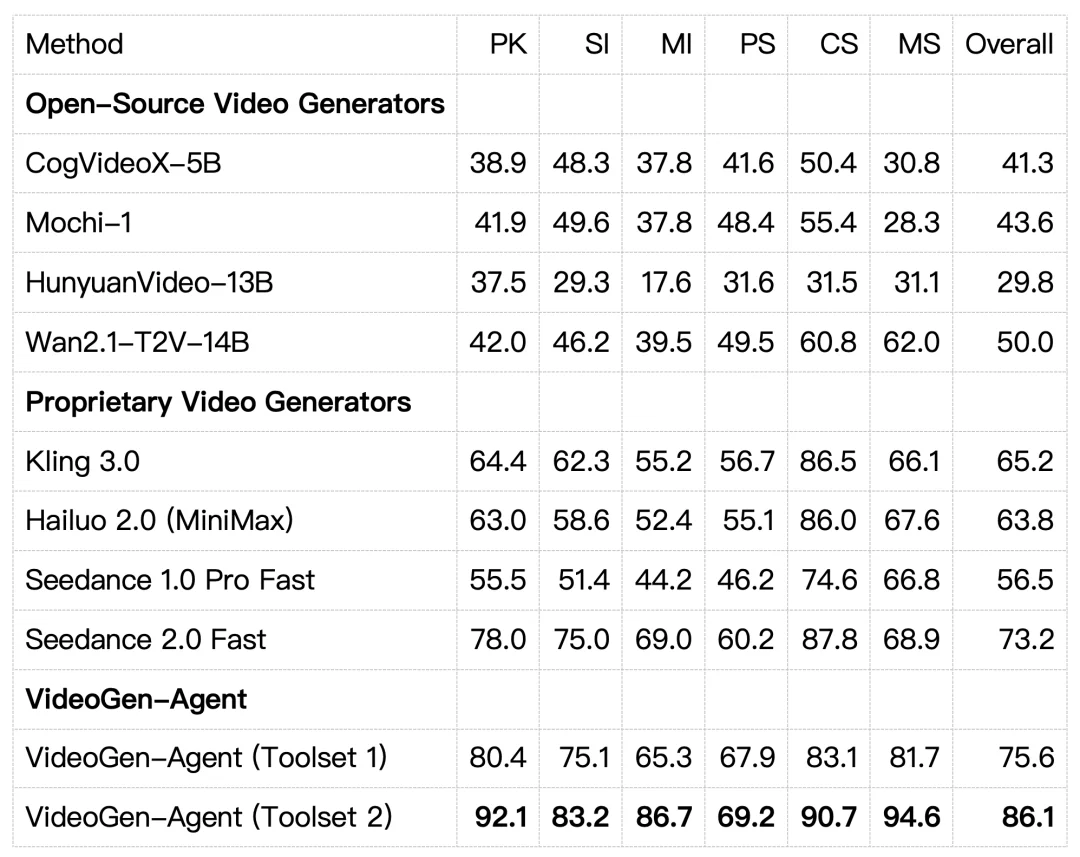
表 1:VABench 完整结果。所有分数均已统一换算为 0~100 分。Overall(综合得分)是六个类别得分的简单平均值,不做额外加权。每列中,加粗和下划线分别表示第一名和第二名。从 Toolset 1 升级到 Toolset 2 时,Agent 的策略保持不变,没有进行额外训练。
表中 PK、SI、MI、PS、CS、MS 分别对应程序性知识、单主体身份、多主体身份、物理一致性、场景组合和多镜头结构。
基础生成器得分为 56.5,VideoGen-Agent 的 Toolset 1 配置达到 75.6,提高 19.1 分;升级工具后的 Toolset 2 达到 86.1。
人类评估提供了另一个观察角度。研究采用相同协议开展两组并排比较:每组从 VABench 随机抽取 100 对视频,由四位评估者分别选择更偏好的结果,不设置平局,每组共得到 400 次判断。
两个数字分别对应不同的对照模型。
研究还单独检验了自动评审与人类判断是否一致。六类任务各抽取 100 对视频,由三位评估者独立比较,再将人类多数意见与 Gemini 3.1 Pro 的选择进行对照。如果两段视频的自动评分相同,则将两段视频交给 VLM,按照相同评价准则强制选出更好的一段。
在这项包含 600 对视频的验证中,自动评审与人类多数意见的总体一致率为 92.0%。六类任务分别为 72.0%、98.0%、100.0%、94.0%、88.0% 和 100.0%;程序性知识最低,说明专业动作与过程仍然更难评判。这项一致性检验与前面的四人偏好实验是两项独立分析。
视频生成模型持续更新,会不会让已经训练好的智能体很快过时?
论文通过替换工具进行了检验。保持智能体策略、信息增强工具和验证工具不变,将生成工具从 Toolset 1 升级为 Toolset 2 后,VABench 总分从 75.6 提高到 86.1,六类任务均获得提升。
其中,多主体身份保持的变化最明显,从 65.3 升至 86.7。相较直接使用 Seedance 2.0,升级工具后的系统在多镜头任务上提高 25.7 分,在程序性知识和多主体身份保持上分别提高 14.1 分、17.7 分。
场景组合的增益则较小,为 2.9 分。这也说明工具增强的收益与具体需求有关:有些任务更依赖外部知识、参考素材或明确的时间结构;有些任务已经能被强大的生成器较好处理。
这组实验验证了一种有实际意义的可复用性:在接口兼容的条件下,已经学会组织生成过程的策略,可以继续利用更强的底层生成工具,而无需额外训练智能体。
整体结果展示了系统的效果。为了进一步看清提升来自哪里,论文比较了提示改写、固定工具流程、监督微调、强化学习及不同奖励配置。
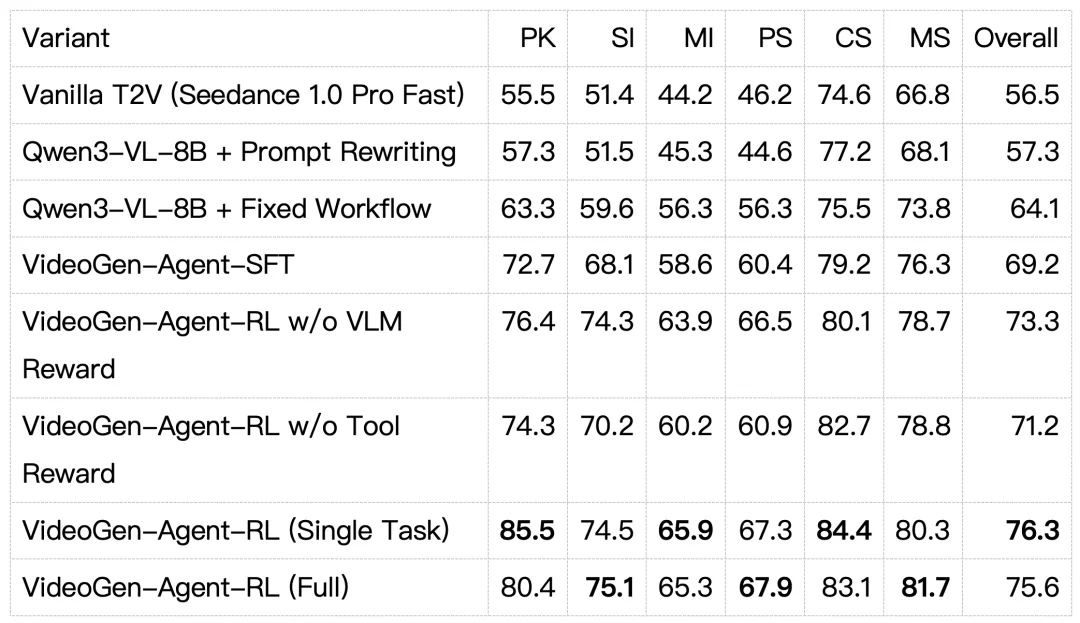
表 2. VABench 上的消融实验结果。Agent 相关变体均使用 Toolset 1。综合得分(Overall)为六个类别得分的简单平均值,不做额外加权。加粗表示每列中的最高分。
单独改写提示词只带来有限提升。接入固定工具流程后,得分提高到 64.1;经过监督微调,智能体进一步达到 69.2;强化学习则在此基础上增加 6.4 分,六类任务均有提升。
单任务变体分别训练六个智能体,每个只使用对应类别的数据进行 SFT 和 RL,再汇总各自负责类别的成绩。其总分为 76.3,略高于共享多任务策略的 75.6;共享策略的价值在于用同一个模型覆盖六类任务,而不是在每一项指标上超过分别训练的策略。
奖励消融也给出了相应证据:移除视频质量奖励,分数降至 73.3;移除工具使用奖励,降至 71.2。结果表明,在这套训练设置中,最终视频反馈和工具使用反馈都对学习有效策略有帮助。
这里的固定流程使用相同的基础智能体和 Toolset 1,由模型组织检索及生成输入、代码控制流程。多数任务执行一次预设流程,场景组合任务最多进行三轮 ReAct 交互;多主体任务则为每个指定主体检索参考图,再调用多参考图生成。其生成调用次数未与 RL 轨迹匹配,因此这些分数反映的是相应系统配置的效果,不能直接解释为相同生成开销下的效率比较。
真实需求经常同时包含多项约束。学过「按步骤做动作」和「保持指定角色」,是否就能生成「指定角色完成专业动作」的视频?
论文构建了一个名为 Procedural Identity(PI)的额外测试,从预留提示池中选取 20 种专业动作或过程与 20 个指定主体,组合、去重并筛选出 100 条提示,将程序性知识与单主体身份要求放到一起。这些提示与 SFT、RL 和 VABench 使用的提示均不重叠,训练中也没有包含这两项要求的组合提示。
测试继续使用 Toolset 1,无需额外训练。系统提示保留各任务的参考流程与一般性的工具组合指导,但没有为 PI 单独写好执行流程。评分使用独立收集、对所有方法共享的动作文本与主体图片参考;美学、文本对齐和图像对齐的权重分别为 0.10、0.45 和 0.45。
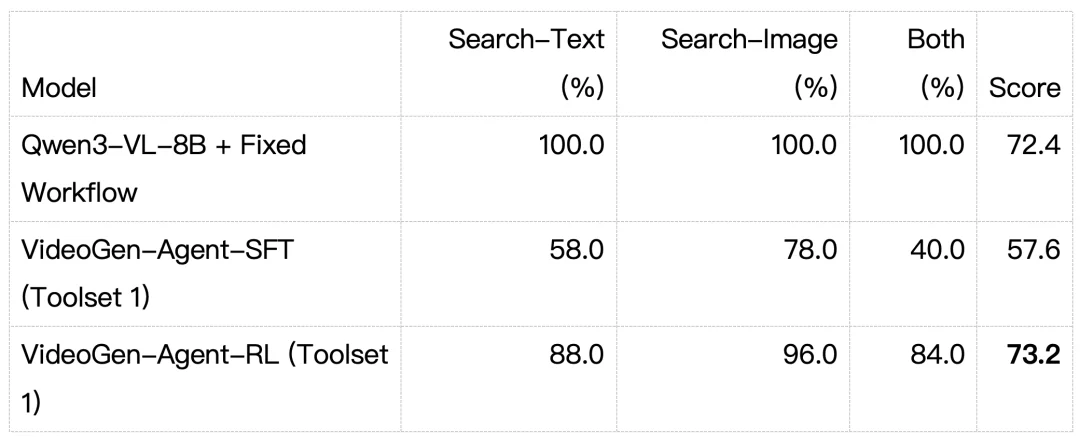
表 3. 在未见过的 PK + SI 组合上的零样本评测结果。 评测使用了 100 条留出的测试提示词。工具调用率表示 Agent 在一次完整执行过程中是否至少调用过一次该工具,并不代表视频生成的成功率。
在不增加训练的情况下,强化学习后的智能体取得 73.2 分,高于 SFT 的 57.6 分,接近显式组合工具的固定流程所取得的 72.4 分。它在 84.0% 的执行轨迹中同时调用了文本与图像检索,SFT 的对应比例为 40.0%。
组合任务中的固定流程强制依次执行文本检索、图像检索和参考条件生成,每条提示执行一次,工具执行错误采用相同的重试上限,生成次数同样未与 RL 轨迹匹配。
工具调用的变化说明,训练影响了模型处理组合需求时的行为。得分则提供了进一步证据,表明这种变化能够改善该测试中的视频结果。不过,这里验证的是一种特定组合;检索调用率本身也不等于视频成功率。
论文还探索了机器人操作场景。给定初始图像和文字指令,智能体先调用 π₀.₅ 预测关节动作轨迹,再将动作交给 Ctrl-World 生成视频。研究从 RL 后的智能体出发,使用额外 1,000 条机器人操作样例进行微调,得到独立于六任务主评测的模型。
取放积木、折叠毛巾和移动毛巾等定性示例显示,微调后的策略可以依次调用动作预测与视频生成工具。这项扩展展示了接入新工具类别的可能性;它使用了额外训练,且对比视频的时长、帧率和分辨率不同,尚不构成机器人任务成功率或真实机器人执行的定量验证。
VideoGen-Agent 把一个值得继续研究的问题具体化了:生成视频之前,系统能否判断还缺什么信息,并通过工具把它补上?
这项工作的证据目前来自六类任务和一个额外组合测试。更复杂的长视频、更开放的物理过程,以及调用成本与等待时间,仍需要进一步检验。但已经观察到的结果说明,训练智能体如何组织检索、生成和验证,可以成为提高视频生成质量的一条有效路径。随着工具更新,这种组织能力也有机会继续发挥作用。
文章来自于"机器之心",作者 "机器之心"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
