AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
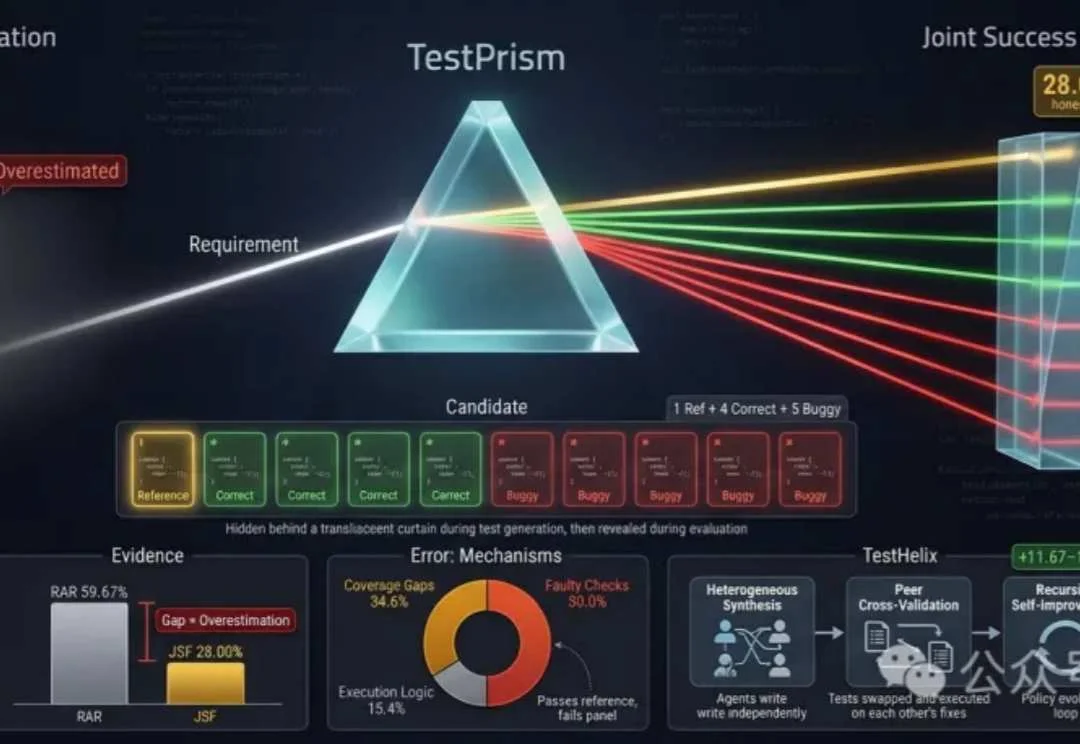
Coding agent写测试集体失败!AI代码合格率被高估一倍

Coding agent写测试集体失败!AI代码合格率被高估一倍

Coding agent写测试集体失败!AI代码合格率被高估一倍

Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。

来自主题: AI技术研报
6796 点击    2026-11-12 15:09
破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

破局机器人长任务难题!港中深联合A* STAR等团队提出LOGIV,以Gragh Engineering迈向可靠具身智能

在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。

来自主题: AI技术研报
7937 点击    2026-11-12 15:09
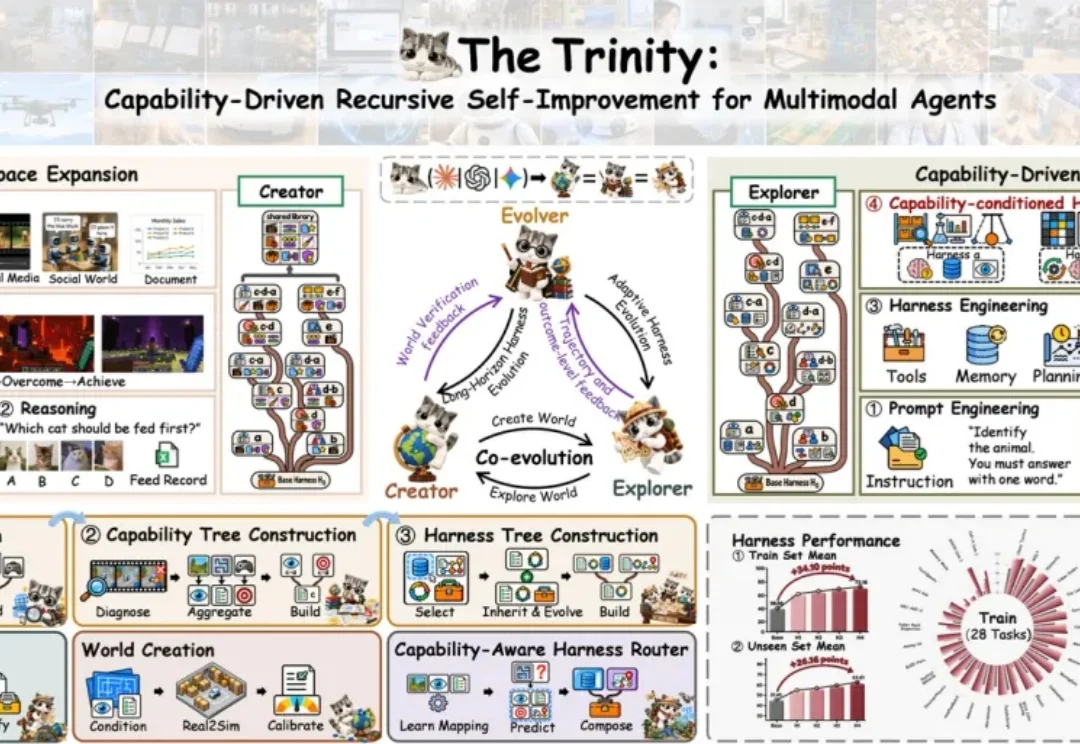
不再围绕任务进化!The Trinity提出能力驱动的多模态RSI新范式

不再围绕任务进化!The Trinity提出能力驱动的多模态RSI新范式

不再围绕任务进化!The Trinity提出能力驱动的多模态RSI新范式

改变 RSI 的基本演化单位,从任务转变为能力,有望从针对具体任务的局部优化,走向跨任务、跨模态的持续演化。

来自主题: AI技术研报
7956 点击    2026-11-12 10:21
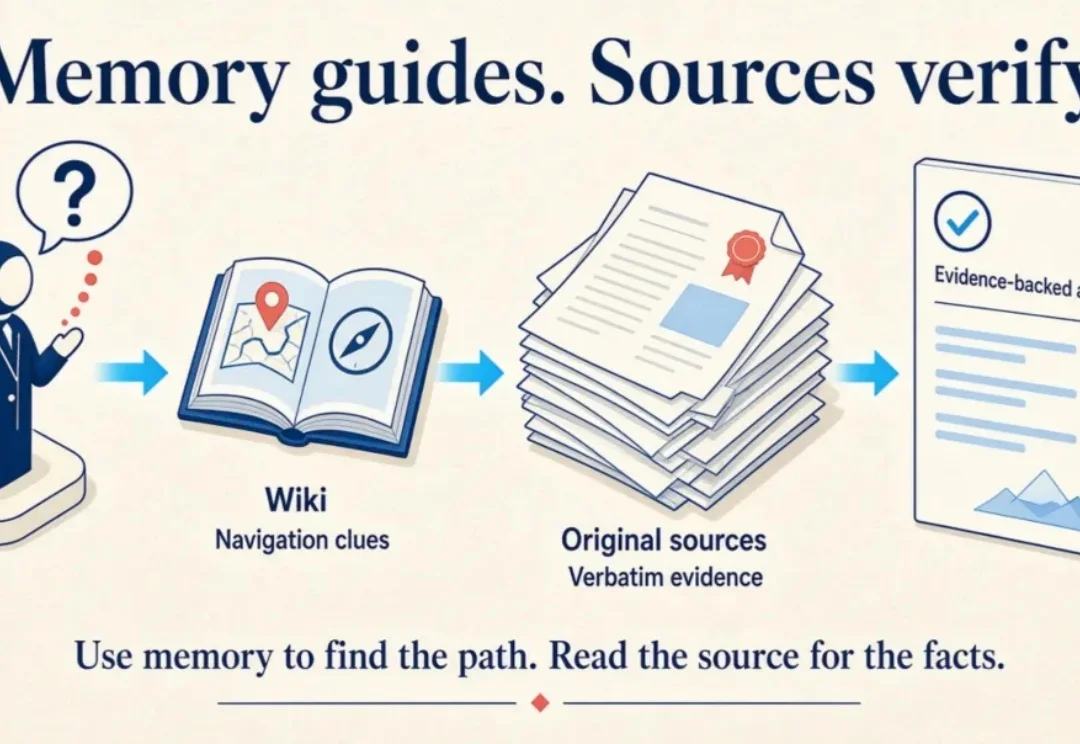
Anthropic是如何设计Agent记忆的,对我们有何启发

Anthropic是如何设计Agent记忆的,对我们有何启发

Anthropic是如何设计Agent记忆的,对我们有何启发

前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。

来自主题: AI资讯
6177 点击    2026-11-12 10:21
下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述

下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述

下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述

Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。

来自主题: AI技术研报
7067 点击    2026-11-12 10:21
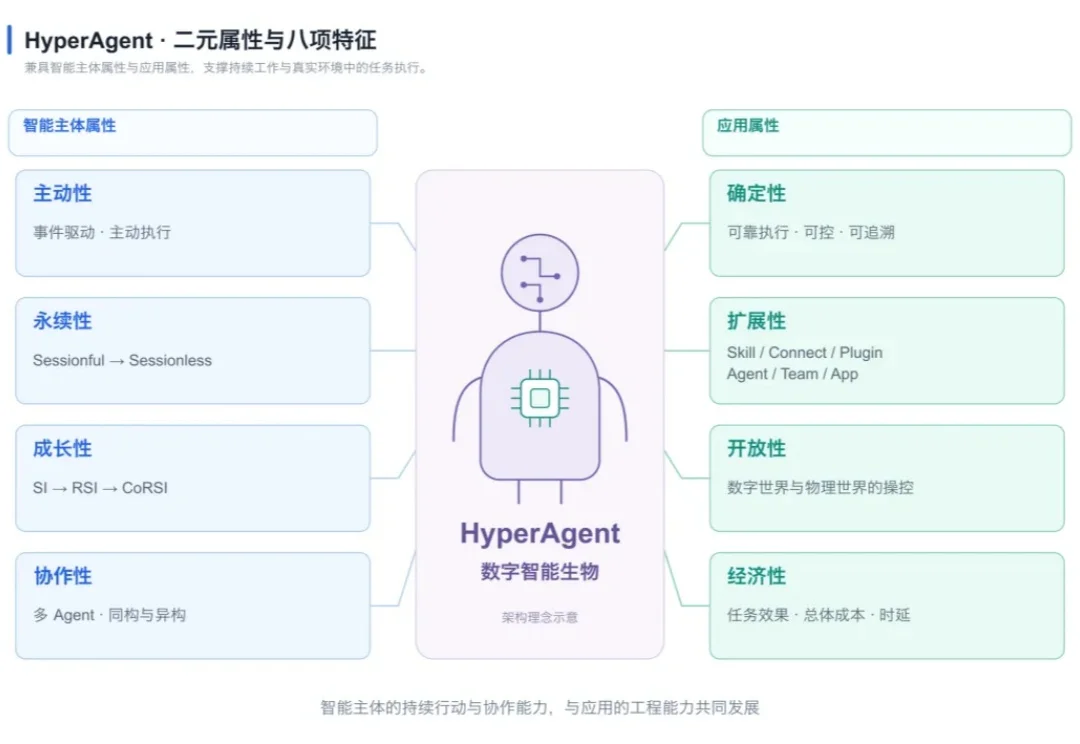
HyperAgent:openJiuwen对未来Agent架构的思考和实践

HyperAgent:openJiuwen对未来Agent架构的思考和实践

HyperAgent:openJiuwen对未来Agent架构的思考和实践

Agent 正在从「回答一个问题」走向「承担一份工作」。近日,开源 AI Agent 社区 openJiuwen 针对 HyperAgent 架构详细解读,系统阐述了它对下一代 Agent 形态的判断 ——HyperAgent 应具备的八项特征,以及支撑这一形态的开源 AgentOS 分层设计。

来自主题: AI技术研报
10230 点击    2026-11-11 15:10
越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。

来自主题: AI技术研报
7128 点击    2026-11-11 14:45
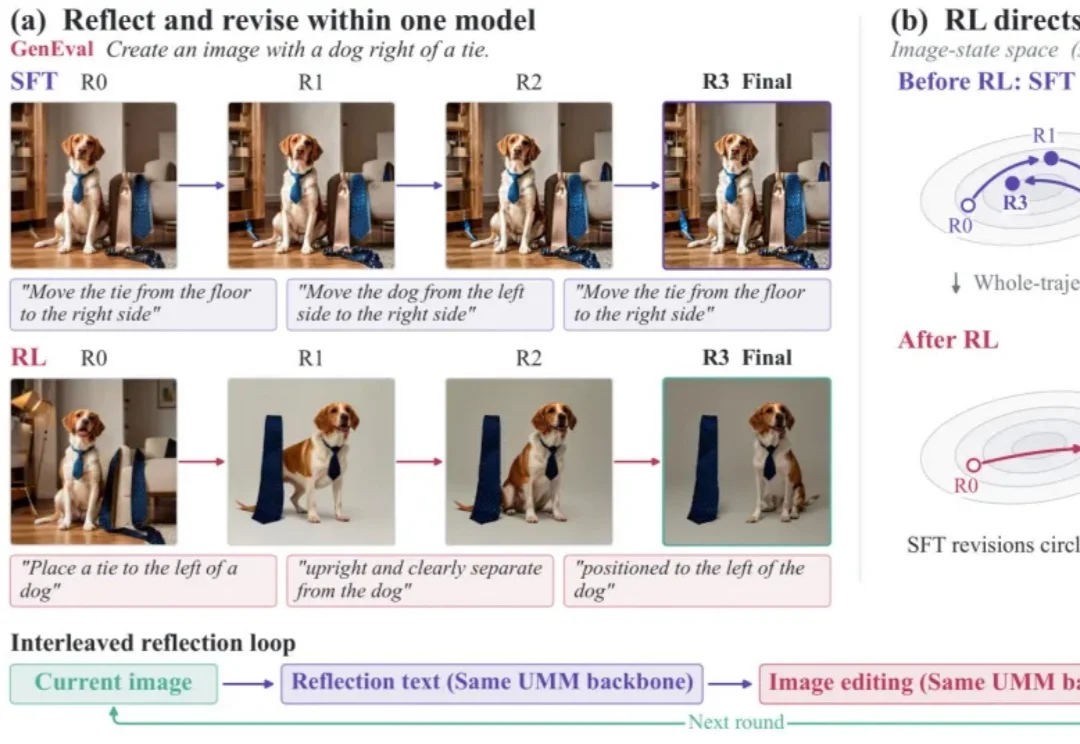
不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

统一多模态模型既能看图,也能画图,那么它能不能像人一样,画完之后自己检查、发现问题、再动手改?

来自主题: AI技术研报
6230 点击    2026-11-11 14:43