AI技术研报-这里有最前沿的人工智能技术解读

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
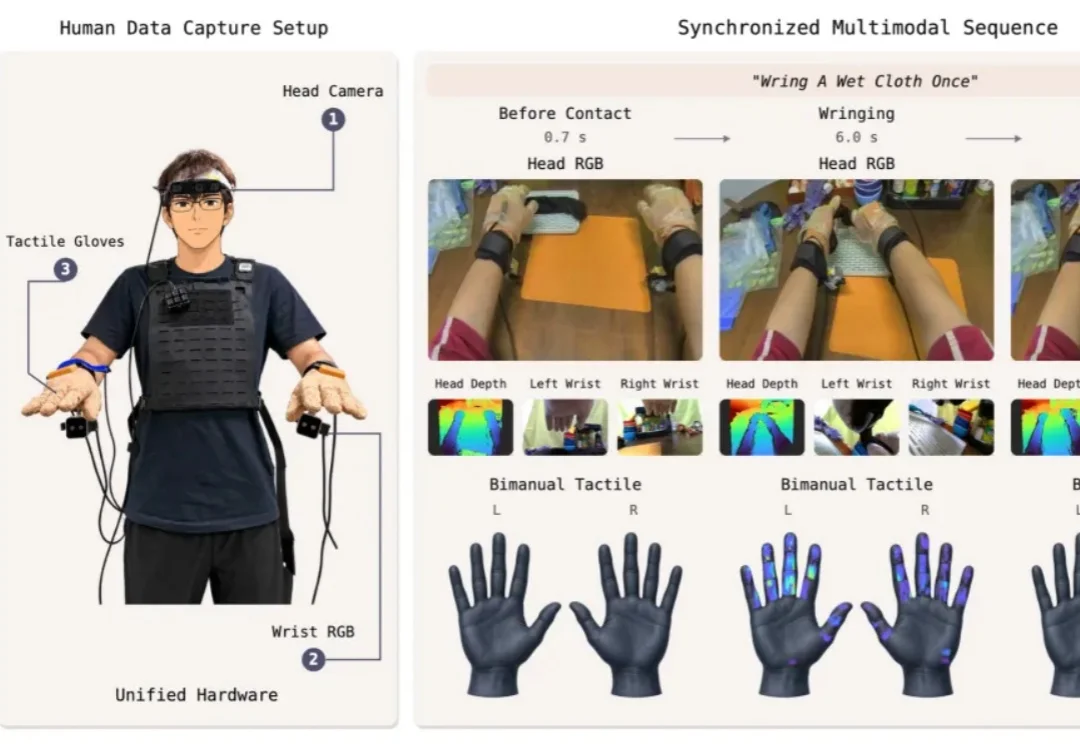
把人类双手的「手感」移植给机器人:500 小时真实操作数据,任务成功率翻番

把人类双手的「手感」移植给机器人:500 小时真实操作数据,任务成功率翻番

把人类双手的「手感」移植给机器人:500 小时真实操作数据,任务成功率翻番

拿起一枚生鸡蛋,手指需要施加恰到好处的力:既要防止滑落,又不能捏碎。拧一条湿毛巾,指尖的力道也要随着水分挤出不断调整。对人类而言,这些操作几乎出于本能。但如果只依赖视觉,摄像头拍得下手部轨迹,却捕捉不到手指接触的位置与按压的力度。
来自主题: AI技术研报
7483 点击    2026-10-09 11:34
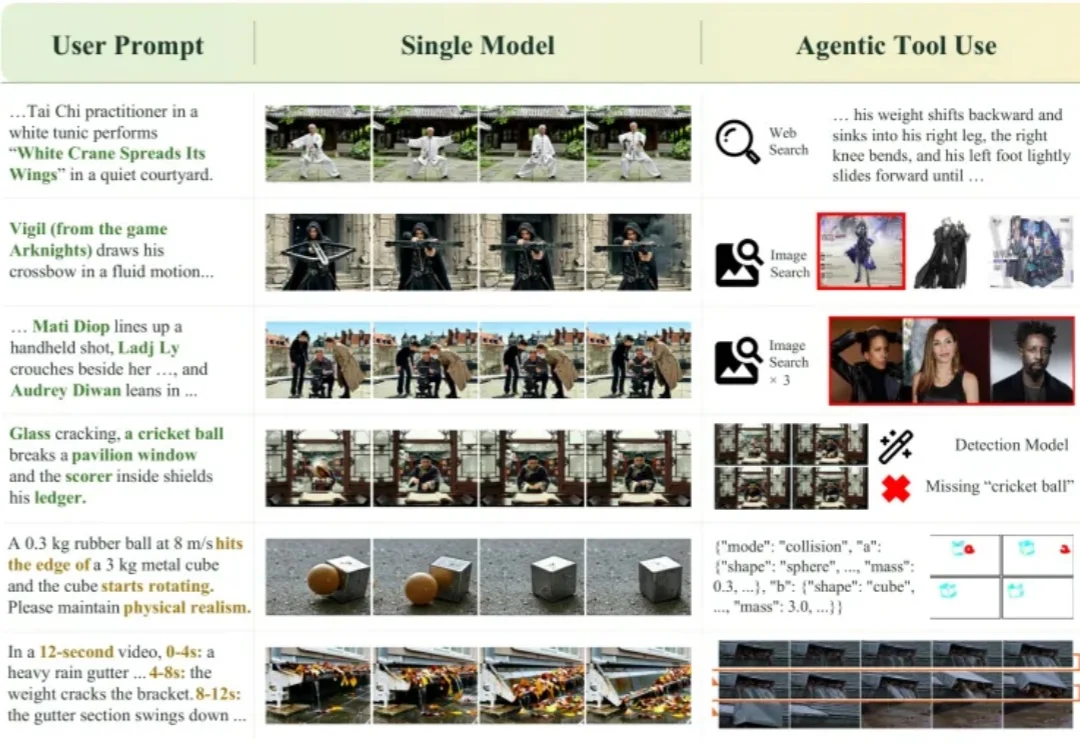
视频生成也能查资料、做模拟:8B智能体学会自主调用工具

视频生成也能查资料、做模拟:8B智能体学会自主调用工具

视频生成也能查资料、做模拟:8B智能体学会自主调用工具

从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
来自主题: AI技术研报
8257 点击    2026-10-09 11:34
蚂蚁×浙大新研究:让AI在流式对话中“读懂”情绪 | EMNLP'26

蚂蚁×浙大新研究:让AI在流式对话中“读懂”情绪 | EMNLP'26

蚂蚁×浙大新研究:让AI在流式对话中“读懂”情绪 | EMNLP'26

在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
来自主题: AI技术研报
7992 点击    2026-10-09 11:32
晕…这年头还有说人话的AI不

晕…这年头还有说人话的AI不

晕…这年头还有说人话的AI不

不er,只有我一个人看不懂AI现在的说话方式了吗?

来自主题: AI技术研报
7234 点击    2026-10-08 11:52
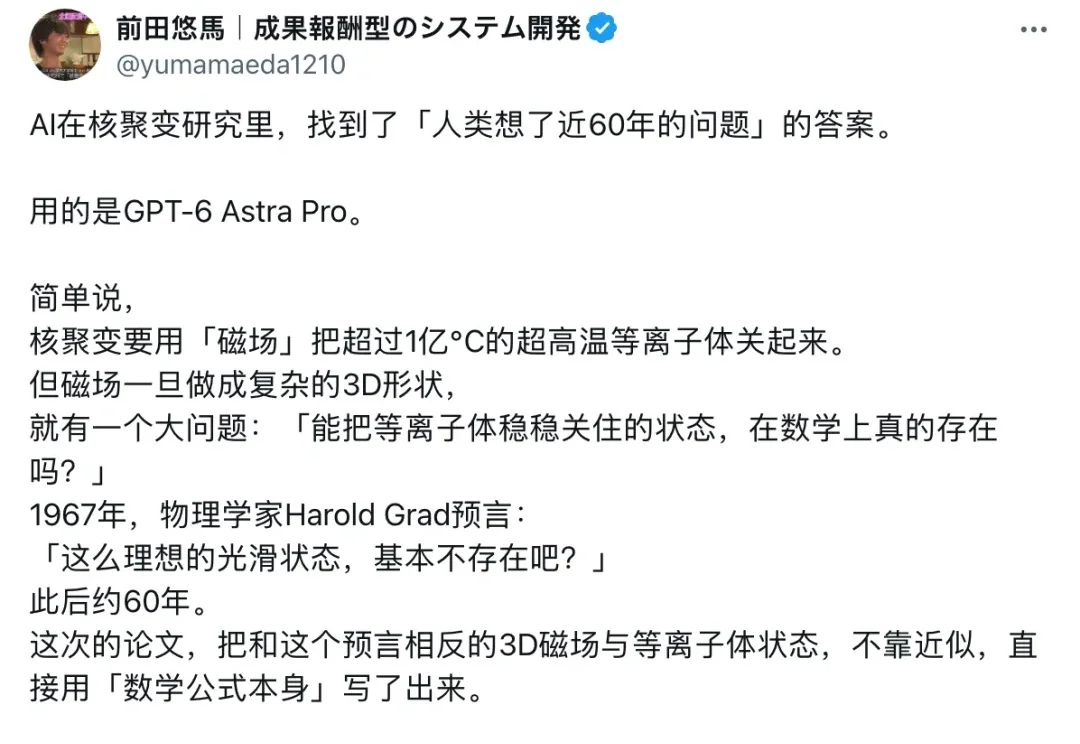
刚刚,GPT-6 Astra推翻59年核聚变猜想!

刚刚,GPT-6 Astra推翻59年核聚变猜想!

刚刚,GPT-6 Astra推翻59年核聚变猜想!

一道悬了59年的核聚变难题,GPT-6 Astra只想了20分34秒,就交出了答案。
来自主题: AI技术研报
7923 点击    2026-10-08 11:52
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图

NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图

NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图

数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
来自主题: AI技术研报
9342 点击    2026-10-08 11:26
USENIX Security 2026|上海创智学院×复旦大学给智能体装上轨迹「安全规则审计员」:让Agent的行动可审计、可解释

USENIX Security 2026|上海创智学院×复旦大学给智能体装上轨迹「安全规则审计员」:让Agent的行动可审计、可解释

USENIX Security 2026|上海创智学院×复旦大学给智能体装上轨迹「安全规则审计员」:让Agent的行动可审计、可解释

智能体时代,安全研究不仅要关心模型说了什么,现在还必须进一步回答:它做了什么、为什么这么做,以及这次的执行轨迹是否越过了当前场景明确规定的安全边界。
来自主题: AI技术研报
5825 点击    2026-10-08 11:26
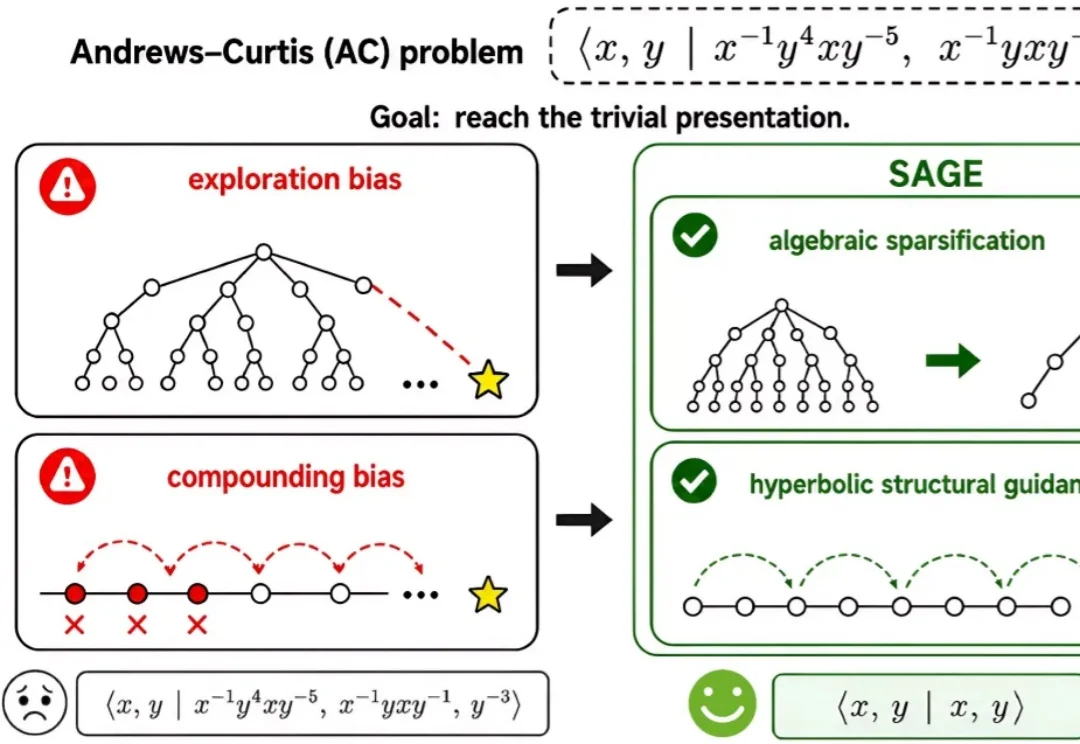
NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

NeurIPS 2026 | 长推理为何总在中途走偏?SAGE用结构信号纠偏,AC实例验证通过率接近8倍

大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
来自主题: AI技术研报
9040 点击    2026-10-08 11:26
翻完OpenAI的722篇数学手稿,我们挑出了最重的30道名题

翻完OpenAI的722篇数学手稿,我们挑出了最重的30道名题

翻完OpenAI的722篇数学手稿,我们挑出了最重的30道名题

今天上午,OpenAI 把一个尚未发布的内部模型产出的 722 篇数学手稿一次性放上了 GitHub。发布本身的来龙去脉、模型背景和数学界的争议,我们在上一篇报道里已经梳理过。这一篇换个角度,打开仓库,看看清单上到底有哪些成果。
来自主题: AI技术研报
7687 点击    2026-10-08 11:11
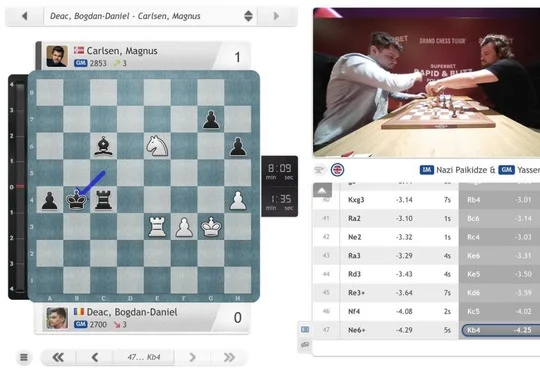
4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?

4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?

4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?

普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
来自主题: AI技术研报
9158 点击    2026-10-07 15:18
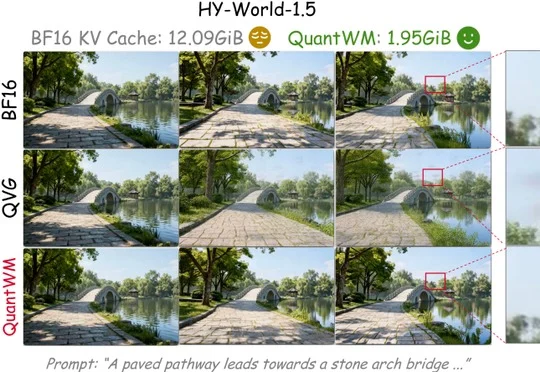
量化后画面闪烁?时序稳定的视频世界模型2-bit KV Cache压缩方案诞生

量化后画面闪烁?时序稳定的视频世界模型2-bit KV Cache压缩方案诞生

量化后画面闪烁?时序稳定的视频世界模型2-bit KV Cache压缩方案诞生

哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
来自主题: AI技术研报
8651 点击    2026-10-07 15:18
黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

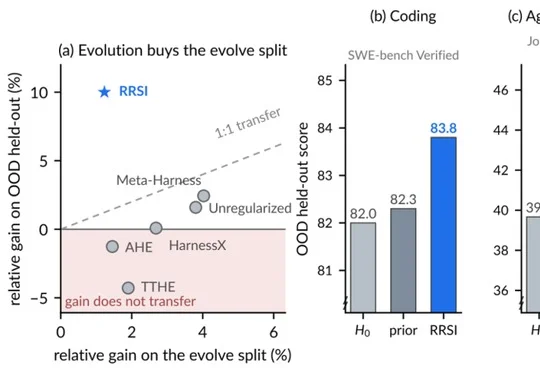
清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
来自主题: AI技术研报
9097 点击    2026-10-06 15:56
RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

RSI火了,但自进化也会过拟合:Google等提出RRSI,给自进化施加正则化

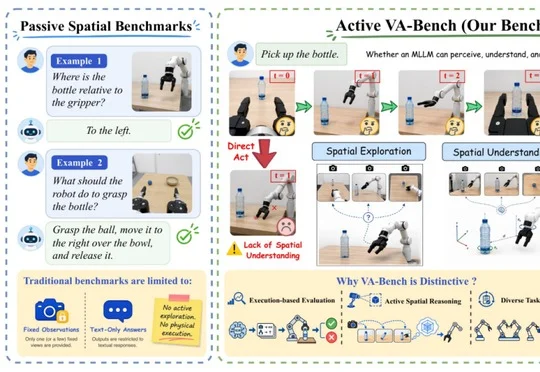
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
来自主题: AI技术研报
8481 点击    2026-10-06 13:54
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

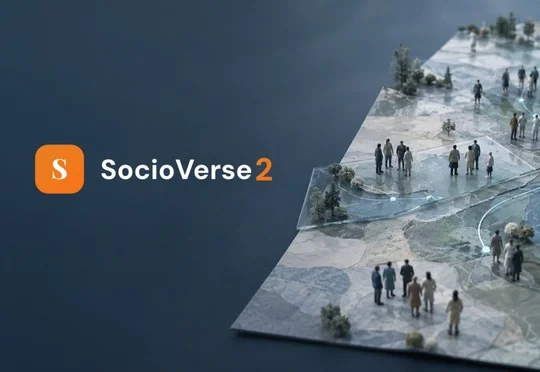
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9439 点击    2026-10-05 23:29
SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

SocioVerse2:长程推演的社会模拟实验基地,让研究者和智能体携手进化

来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
来自主题: AI技术研报
8781 点击    2026-10-05 23:29
魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

魔搭开源动态检索新框架,无需预构建向量索引,知识库还能自己进化

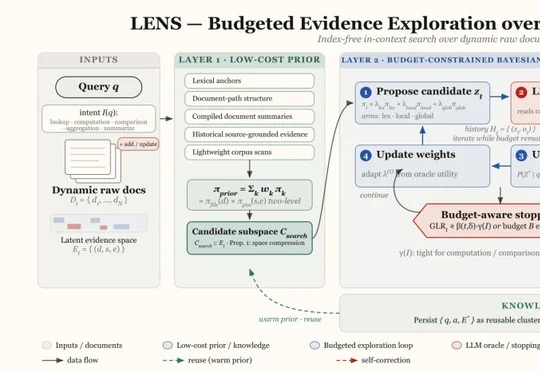
ModelScope团队开源动态检索框架Sirchmunk,无需预构建向量索引即可在原始文件中即时定位证据,并通过KnowledgeEvolver把检索经验沉淀为可复用知识,使知识库在检索过程中持续连接、合并与重组,实现自我进化。
来自主题: AI技术研报
9259 点击    2026-10-04 22:06
万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

万分之一——大模型后训练中的极端稀疏监督

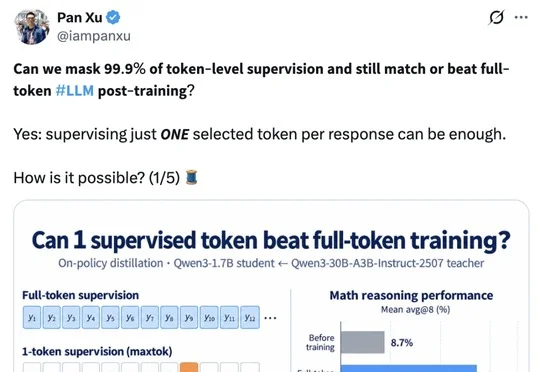
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
来自主题: AI技术研报
8749 点击    2026-10-04 22:03
Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

Jev火了,NeurIPS 2025的ConfTuner早已探索相似思路

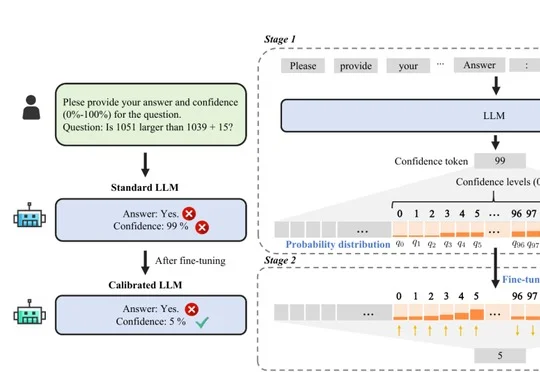
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。
来自主题: AI技术研报
9325 点击    2026-10-04 22:02
CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

CoRL 2026|让机器人更会动,从学会「起步」开始

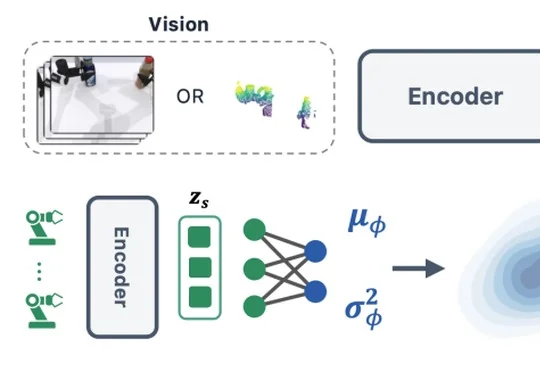
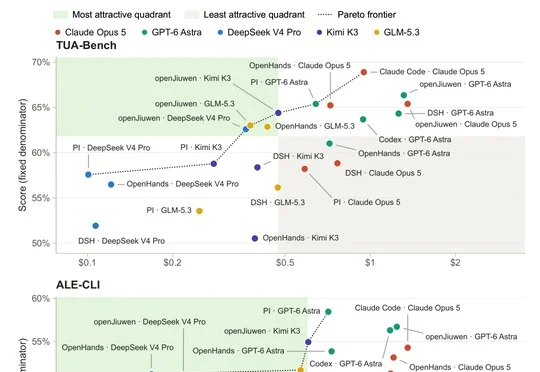
东南大学魏秀参团队提出LeaP(Learnable source Prior)方法,由本体感知信息驱动并联合预测动作生成起点的均值与方差,在RoboTwin仿真15项任务上平均成功率81.6%、较标准高斯基线提升25.5个百分点,相关论文已被CoRL 2026接收。
来自主题: AI技术研报
9536 点击    2026-10-04 22:01
Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

Agent Harness到底怎么选?南洋理工大学安波团队最新研究给出答案

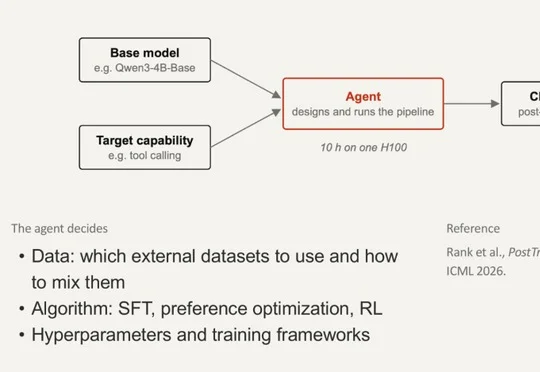
南洋理工大学安波团队最新研究指出,Agent Harness的选型应将模型、Harness与任务作为完整配置联合评估,不同任务下最佳组合会变化,原生搭配也未必优于其他可配置Harness。
来自主题: AI技术研报
9051 点击    2026-10-04 22:01
让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench

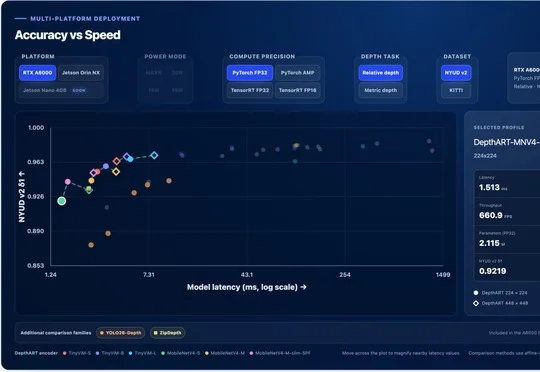
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
来自主题: AI技术研报
9254 点击    2026-10-03 10:29
把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

把Depth Anything砍到6M,深度估计终于能跑进Jetson

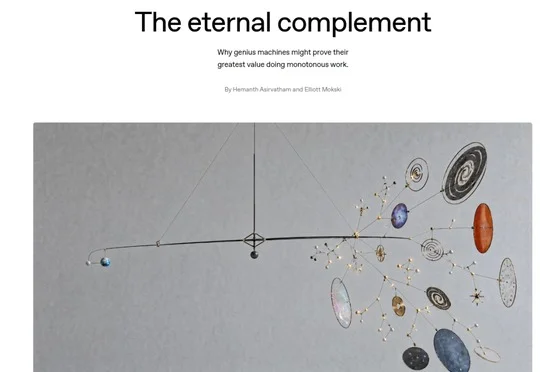
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
来自主题: AI技术研报
9228 点击    2026-10-03 10:28
OpenAI员工长文:AI 时代的文明岔路

OpenAI员工长文:AI 时代的文明岔路

OpenAI员工长文:AI 时代的文明岔路

OpenAI"智能时代"平台发布文章《The Eternal Complement》,讨论AI走向超级智能后文明稀缺资源将转向判断力与"品味",提出"深度文明"与"广度文明"两种发展路径,并强调人类好奇心与创造多样性仍具持续价值。
来自主题: AI技术研报
8393 点击    2026-10-03 10:28
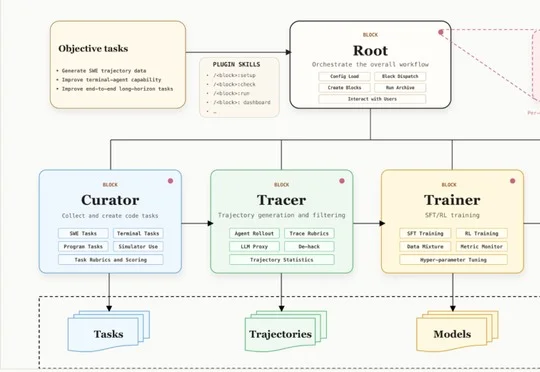
LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

LegoFlow:让智能体自主跑完代码数据构建+训练测评全流程

从 1200 万个候选拉取请求中,最终留下 5000 个 SWE 代码任务 —— 不足 0.05%。把「出题、答题、改卷、训练、评测」这条代码数据流水线全自动跑起来,就是 LegoFlow; 在这个过
来自主题: AI技术研报
8286 点击    2026-10-03 10:27
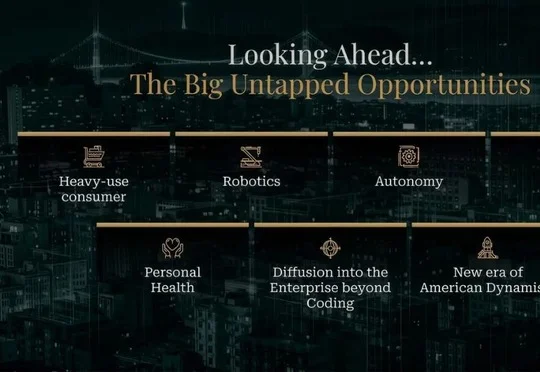
喝点VC|a16z最新90页报告解读:AI的钱正流向哪里,利润留给谁

喝点VC|a16z最新90页报告解读:AI的钱正流向哪里,利润留给谁

喝点VC|a16z最新90页报告解读:AI的钱正流向哪里,利润留给谁

a16z最新90页报告《STATE OF MARKETS》指出,Alphabet、亚马逊、Meta、微软和甲骨文五家科技巨头2026年合计资本开支预计接近7770亿美元,AI建设正成为影响宏观经济的重要变量,供应链获得订单但回报兑现仍有先后,软件行业则进入"证明自己"的阶段。
来自主题: AI技术研报
9382 点击    2026-10-02 21:58
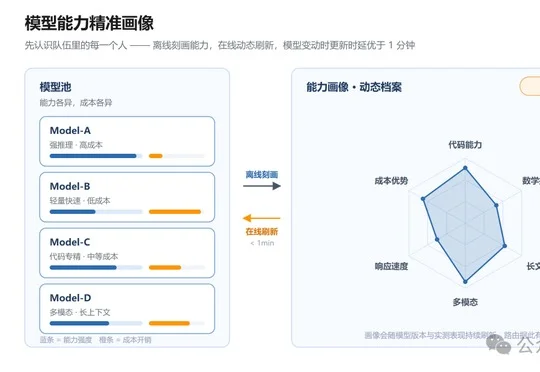
openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

openJiuwen X-Router自演进模型路由技术首发,昇腾亲和,Agent越跑越省,实测减少50+%Token消耗

不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
来自主题: AI技术研报
7083 点击    2026-10-02 12:48
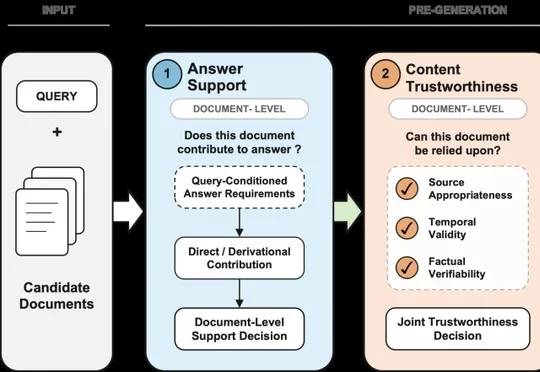
AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈

百度联合中国科学院计算技术研究所与武汉大学的研究者围绕这一现状,提出答案支撑、内容可信与上下文组织三阶段框架,并结合百度搜索工业实践,梳理了从检索排序、可信度判断、结构化上下文组织到生成后反馈的优化链路。
来自主题: AI技术研报
10818 点击    2026-10-02 12:48
Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

Token用量暴涨124倍,研发提速仅一成?前微软合伙人万字长文质疑RSI引发“智能爆炸”

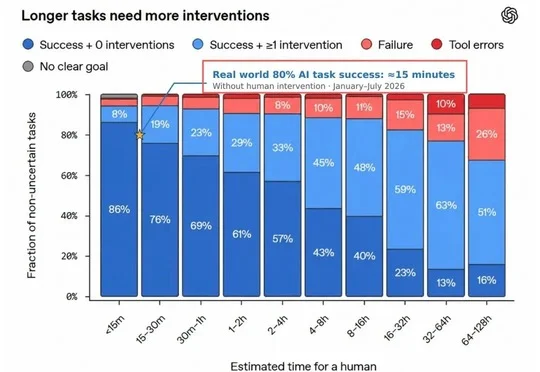
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
来自主题: AI技术研报
6429 点击    2026-10-02 12:47
淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本

来自主题: AI技术研报
7931 点击    2026-10-02 12:46