刚刚,Gemini 3.8 Live上线!
刚刚,Gemini 3.8 Live上线!谷歌又杀回来了。
来自主题: AI资讯
7402 点击 2026-09-16 15:11

 搜索
谷歌又杀回来了。
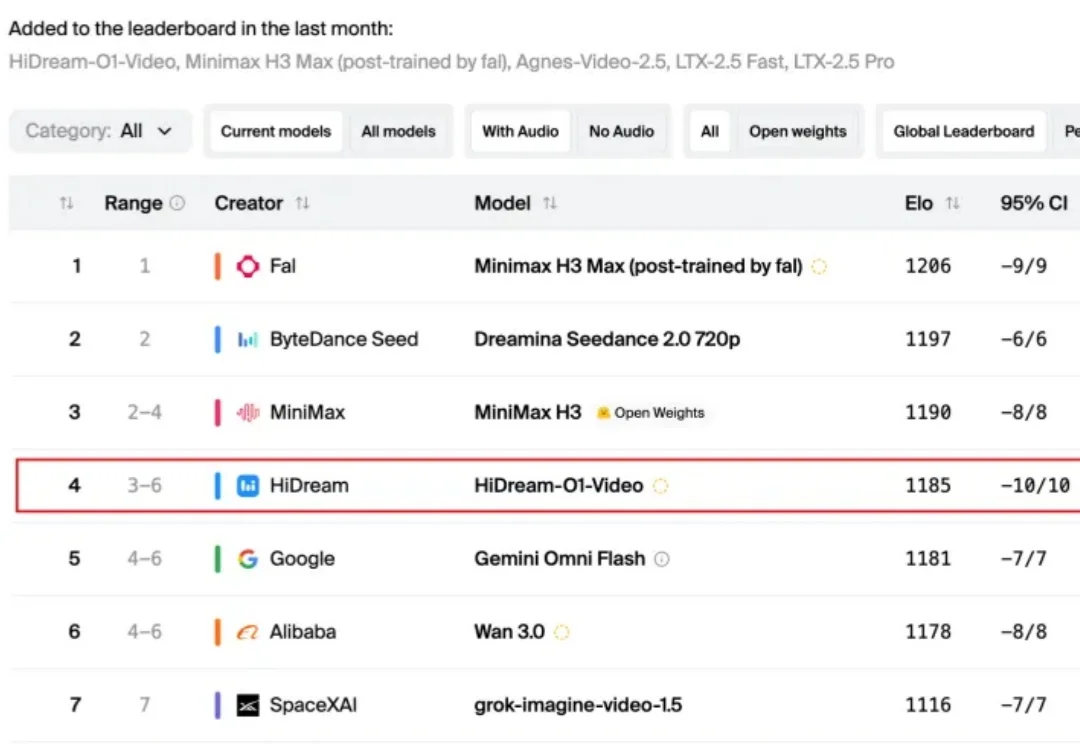
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
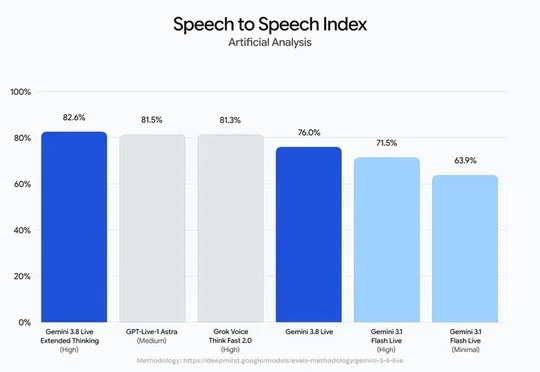
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
GPT-6 Astra 把大模型的能力边界,又向 3D 世界推了一步。它可以操作 Blender、编写代码,直接生成 3D 模型和场景。当通用模型开始学会建模,专门做 3D 生成的创业公司会被吃掉吗?
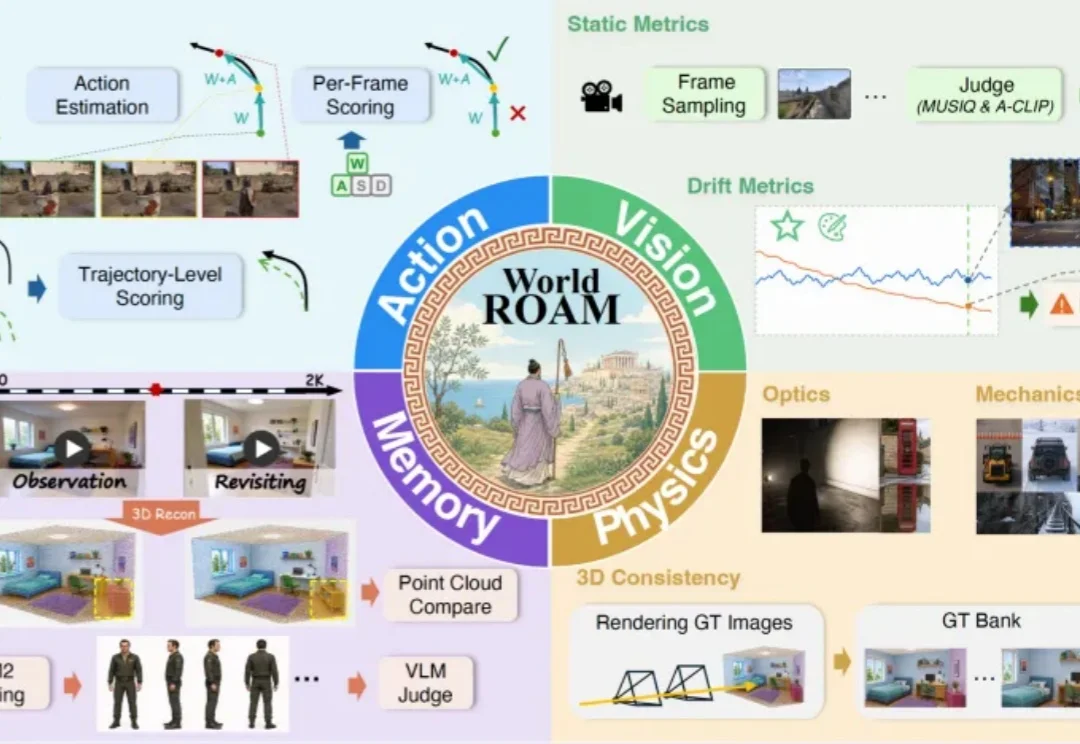
随着 Genie 3 的发布,可交互世界模型真正走到台前:用户不再只是观看生成视频,而是可以输入动作实时改变一个持续演化的世界。世界模型开始从「生成一段视频」走向「模拟一个可交互世界」,但能走进去,不等于经得起探索。模型能否持续响应控制、维持视觉与空间一致、遵守物理规律并记住来路,仍缺少系统评测。
地铁急刹,金属尖叫,广播响起「请乘客注意扶稳」,人群骚动、孩子哭声、对讲机杂音一层层涌上来···
OpenAI计划以3亿美金收购由前苹果工程师创立的AI影像公司Glass Imaging,以补充端侧视觉能力,布局多模态AI硬件。
人类密码学界,要破防了?
AI 的竞赛正在经历一次深刻的转向。过去两年,行业目光从“卷参数”转向“卷推理”,如今新的分水岭已经显现:AI 能否从数字世界走进物理世界,真正去“行动”?
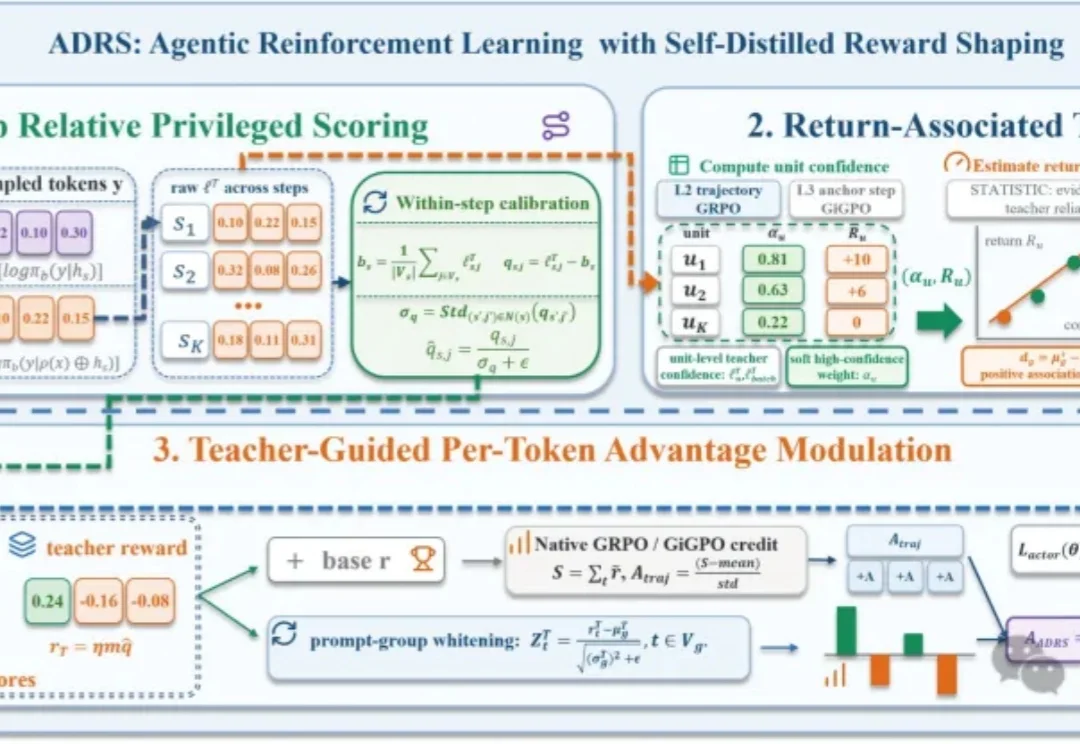
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。