NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源
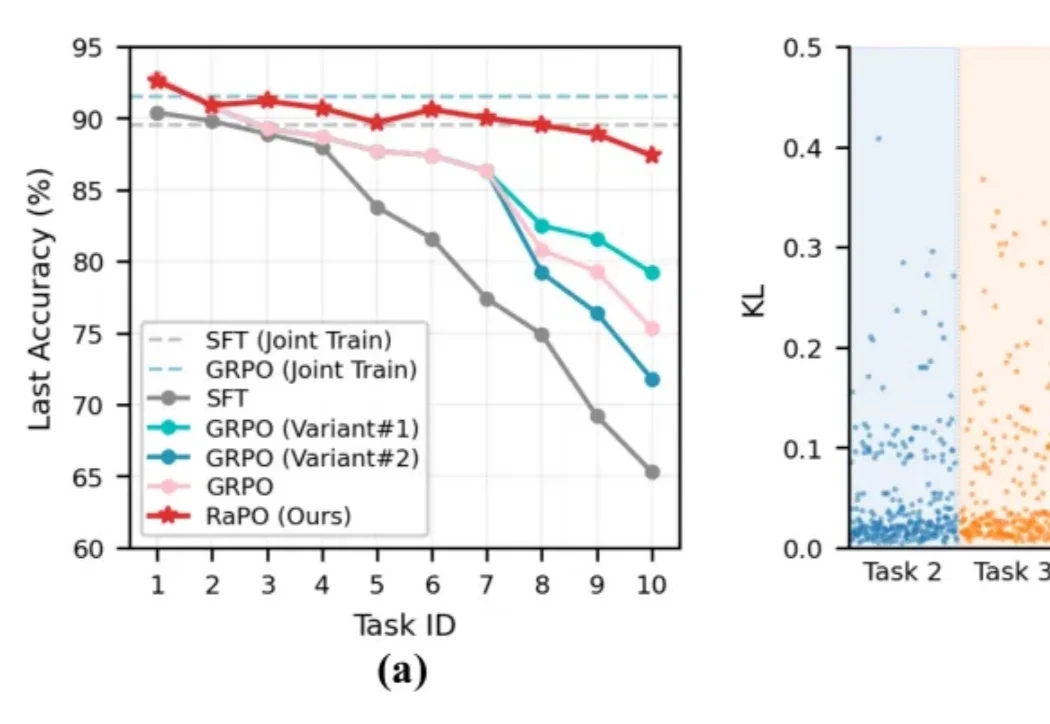
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
搜索
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
憋了整整两年多,百度终于亮出了自己的重磅杀手锏!
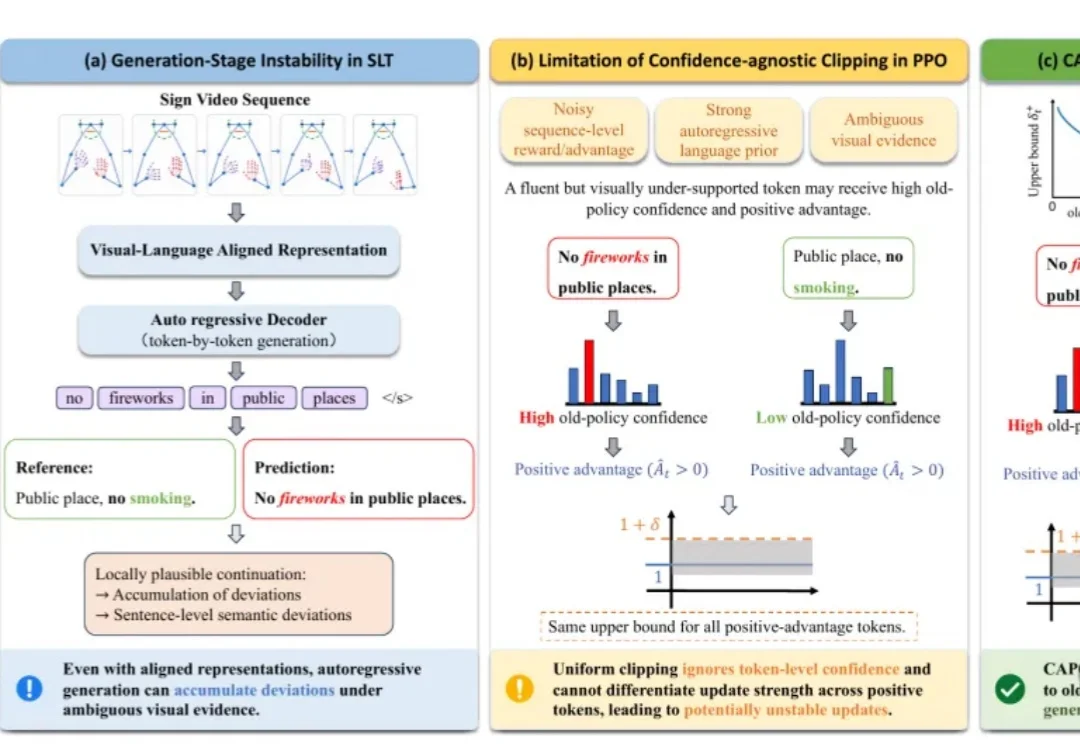
自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。
面向 Gen Alpha 的视频共创社交平台 Wapoo 已完成近千万美元天使轮融资。本轮融资由某互联网集团旗下战略投资方投资,其在全球化产品运营、年轻用户生态及新兴市场拓展方面已具备一定积累,探奇资本担任公司独家融资顾问。目前,Wapoo 团队约 10 人,并已开始筹备下一轮融资。
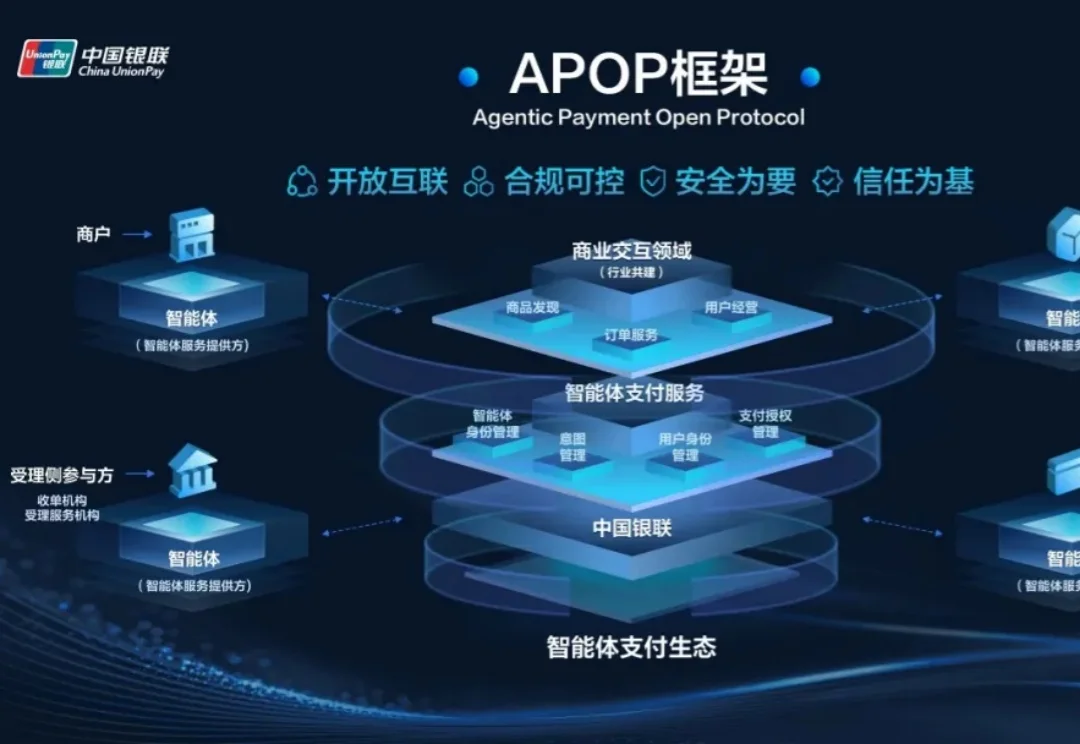
当 “花钱” 这事儿开始外包给 AI,这个世界将发生什么变化?
从ChatGPT掀起生成式AI浪潮到现在,不过短短两三年,AI能力的进化速度已经让"AI自我进化"这件事从科幻走进了现实。上个月,Anthropic在一份公开报告中预测,AI未来将进入"递归自我提升"(Recursive Self-Improvement, RSI)阶段,并呼吁人类共同为AI的发展设计出一个减速或暂停机制。
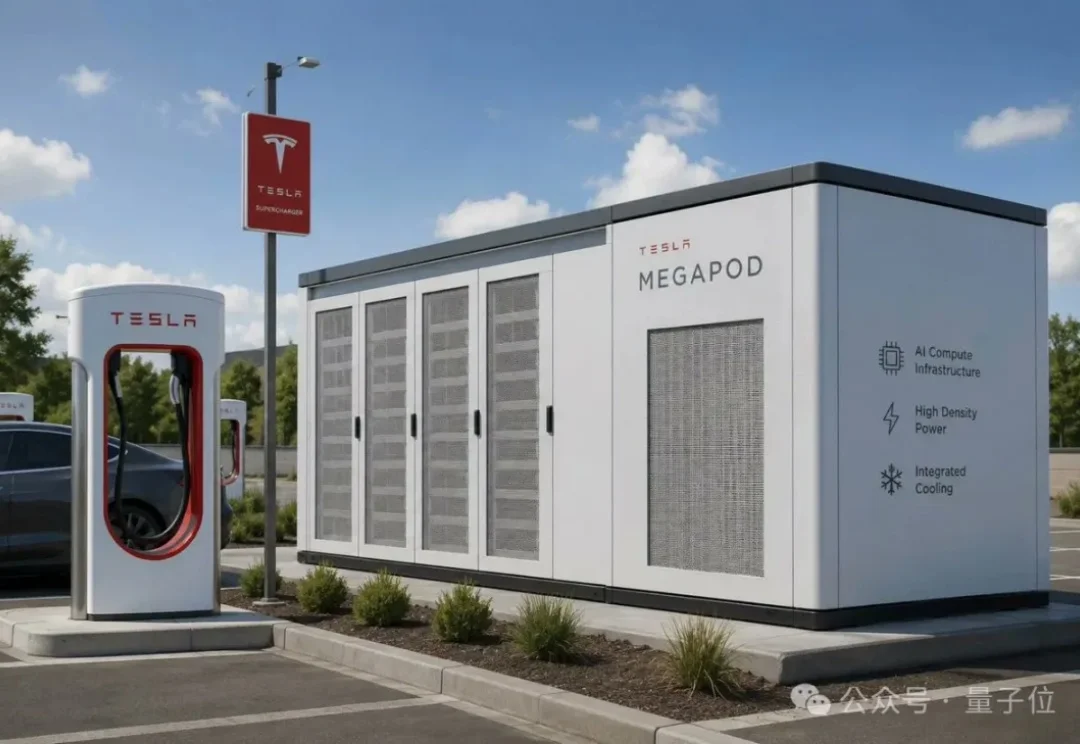
特斯拉也盯上AI基建生意了。
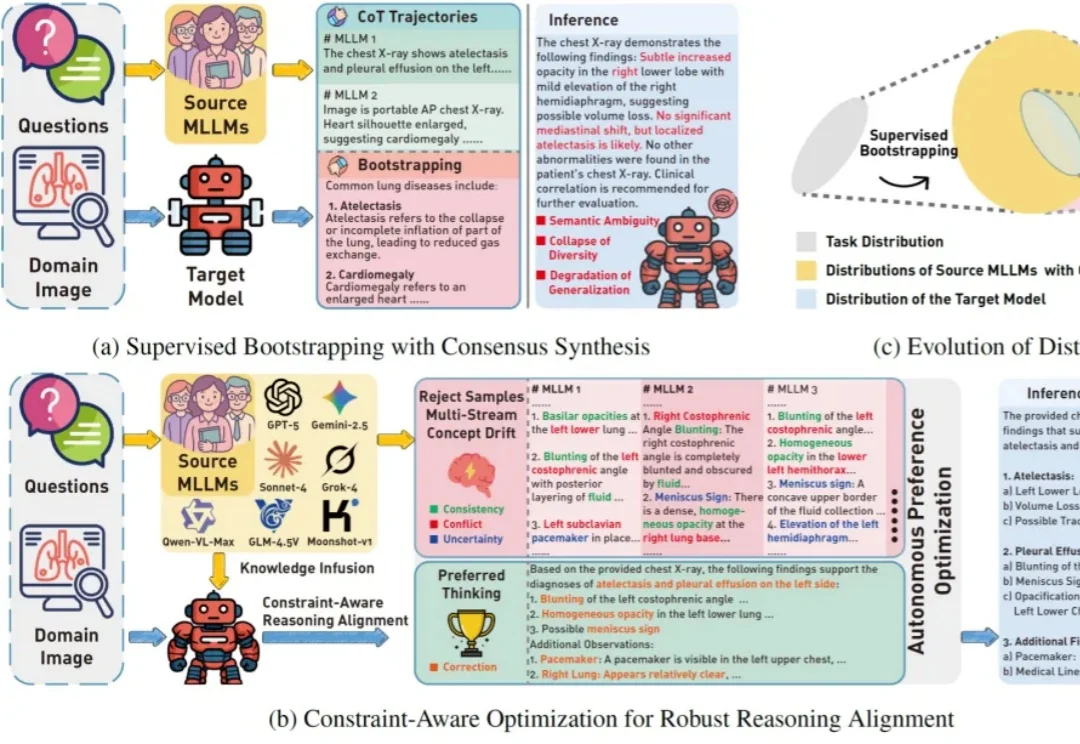
在多模态大模型(MLLM)快速发展的浪潮中,融合多模型 “集体智慧” 已成为提升模型性能的关键路径,并催生了多教师知识蒸馏这一主流范式。然而,不同来源的教师模型在架构与优化上的差异,其在相似推理过程中呈现出不稳定甚至偏移的认知轨迹,即 “概念漂移”(Concept Drift)。
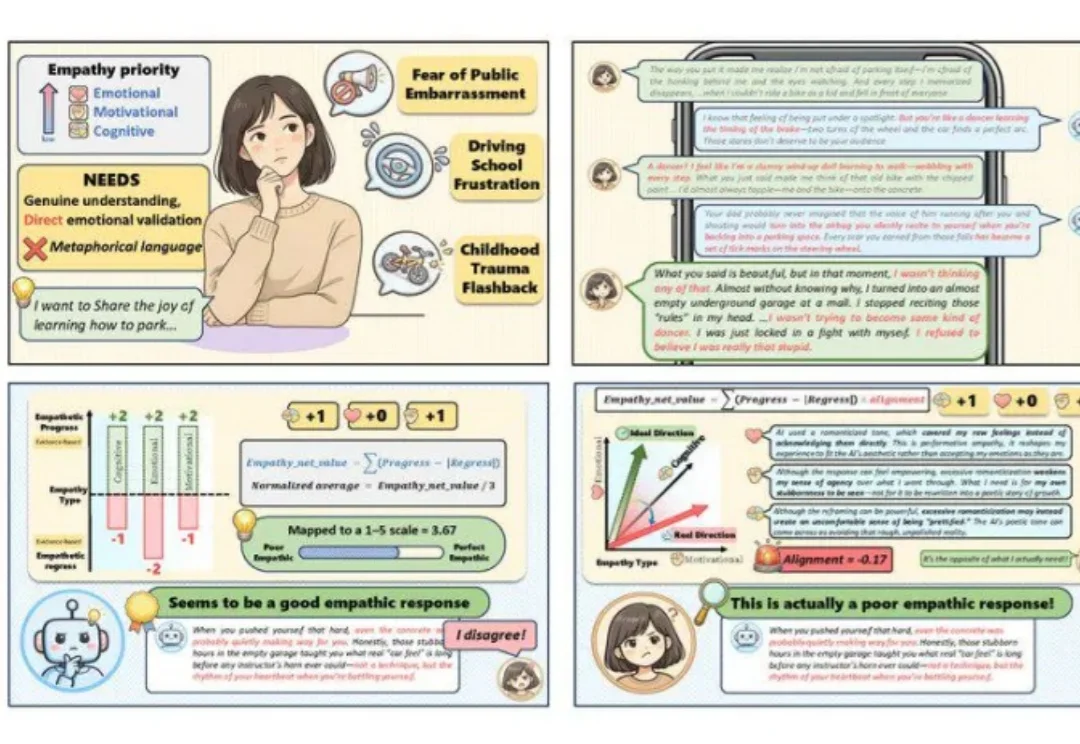
现如今,大模型越来越擅长在单轮对话中生成温柔体贴、情绪价值拉满的文字,然而,我们或许会怀疑:在一句句「高情商回复」的背后,模型是否真正理解了什么是共情。
过去,科学家观察研究细胞的工具很有限。