口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了
口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
搜索
科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
8 月 4 日,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,
把 VoiceVault 的转录引擎从 Whisper 迁移到 FunASR(sherpa-onnx),中文识别速度提升 3x,不再需要 500MB 的模型文件。但"切个后端"这件听起来很简单的事,让我在 GitHub Release 的 404、Tauri 白屏、trait object 生命周期和 CSP 策略里翻滚了一整天。
没错,用的就是主打长程任务、模糊指令遵循,跻身国产Agent第一梯队的小米MiMo‑V2.5 Pro。小米最新发布的MiMo‑V2.5系列,包含Pro旗舰Agent、全模态基座、TTS语音合成、ASR语音识别四大模型,综合实力对标国际顶尖水准。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。
ListenHub ASR 语音识别 API 全新上线,无限免费。 API 特点: 本地离线转录,无需 API Key,安装即可使用。专为 Agent 设计,方便你的 Claude Code 和龙虾🦞直接接入自动化工作流。
2026 马年注定迎来一个「AI 味」最浓的春节。
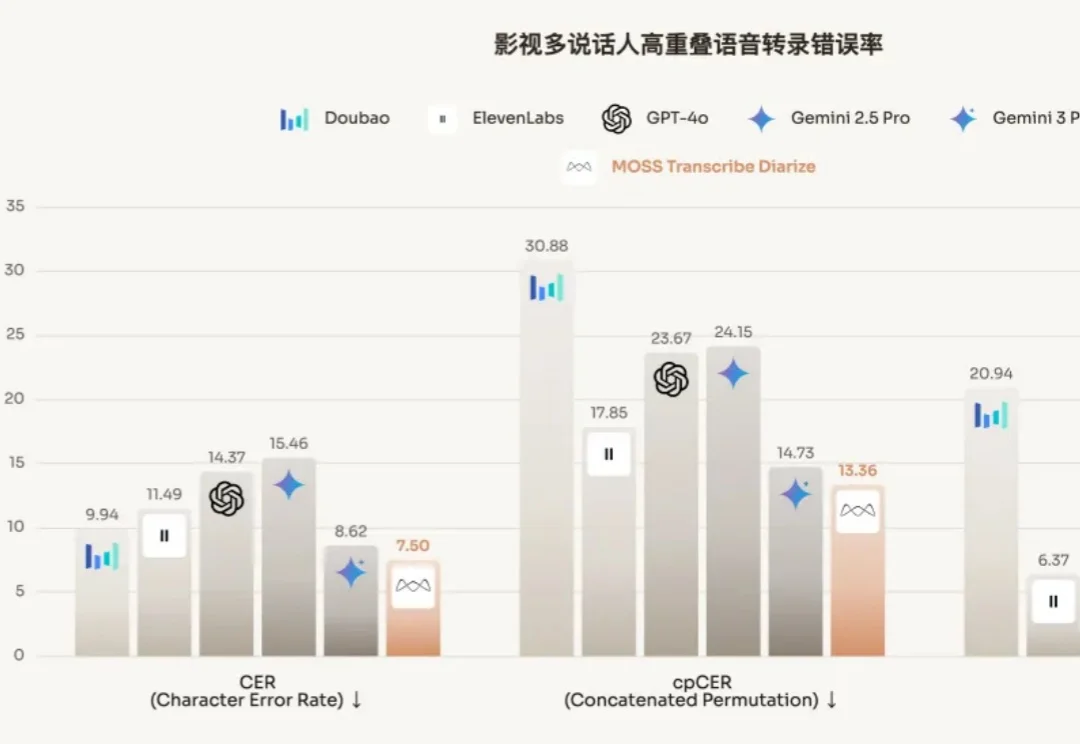
近日,由复旦邱锡鹏担任首席科学家的模思智能发布了多说话人自动语音识别(ASR)模型 MOSS-Transcribe-Diarize,不但可以语音转文字,还可以将音频片段与对话中不同的说话者关联起来,性能超过了 GPT-4o、Gemini、豆包等一众模型。
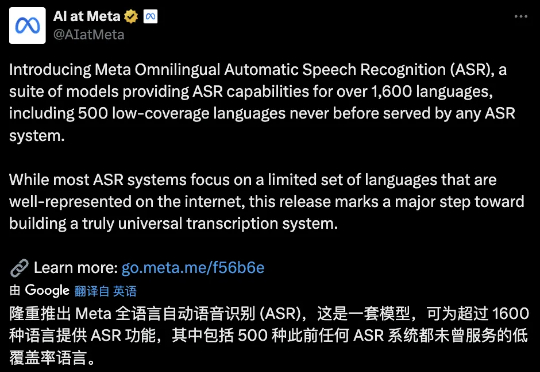
在7000多种人类语言中,只有少数被现代语音技术听见,如今这种不平等或将被打破。Meta发布的Omnilingual ASR系统能识别1600多种语言,并可通过少量示例快速学会新语言。以开源与社区共创为核心,这项技术让每一种声音都有机会登上AI的舞台。
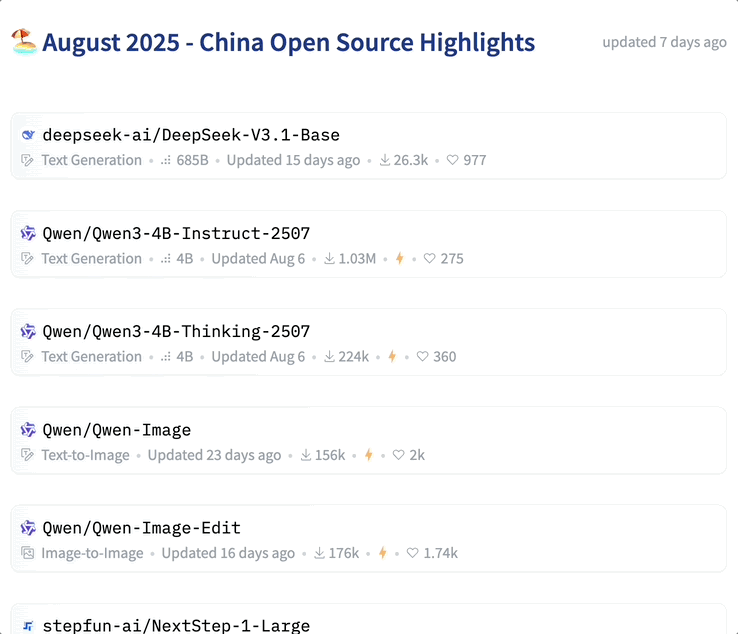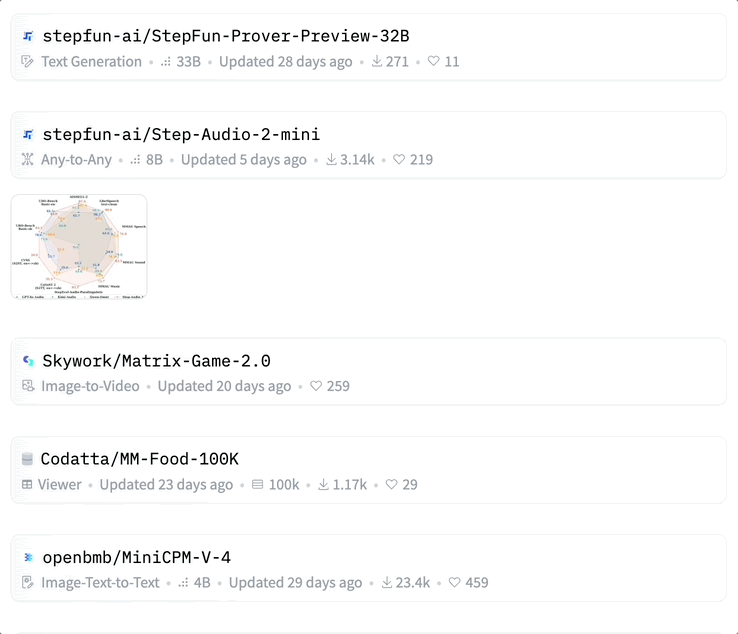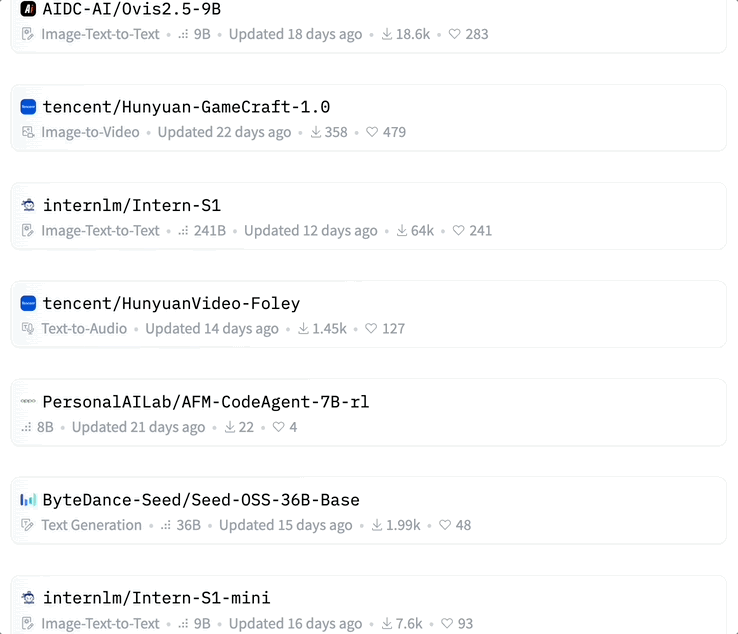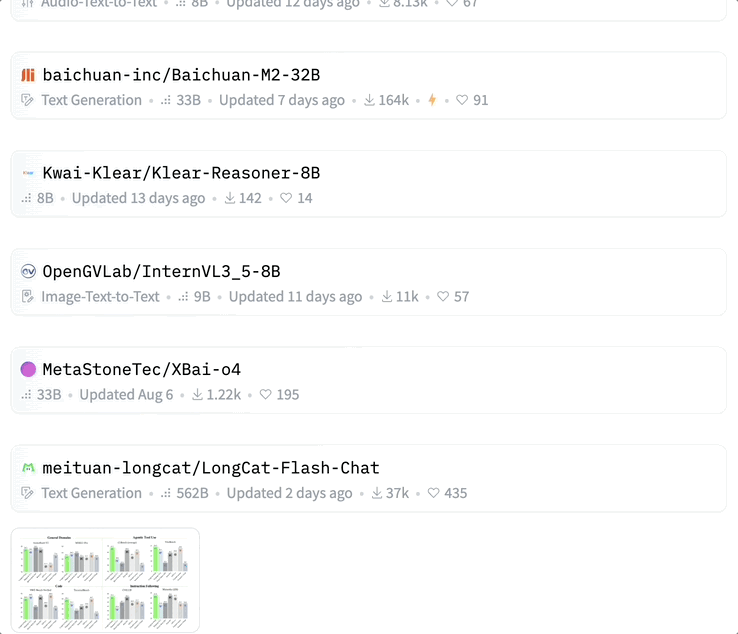
不难发现,近几个月,开源频频成为 AI 社区热议的焦点。尤其是对于国内科技公司来说,开源成为主旋律。根据 Hugging Face 中文 AI 模型与资源社区的数据显示,国内厂商在七八月接连开源 33 款、31 款各类型大模型。