Anthropic是如何设计Agent记忆的,对我们有何启发
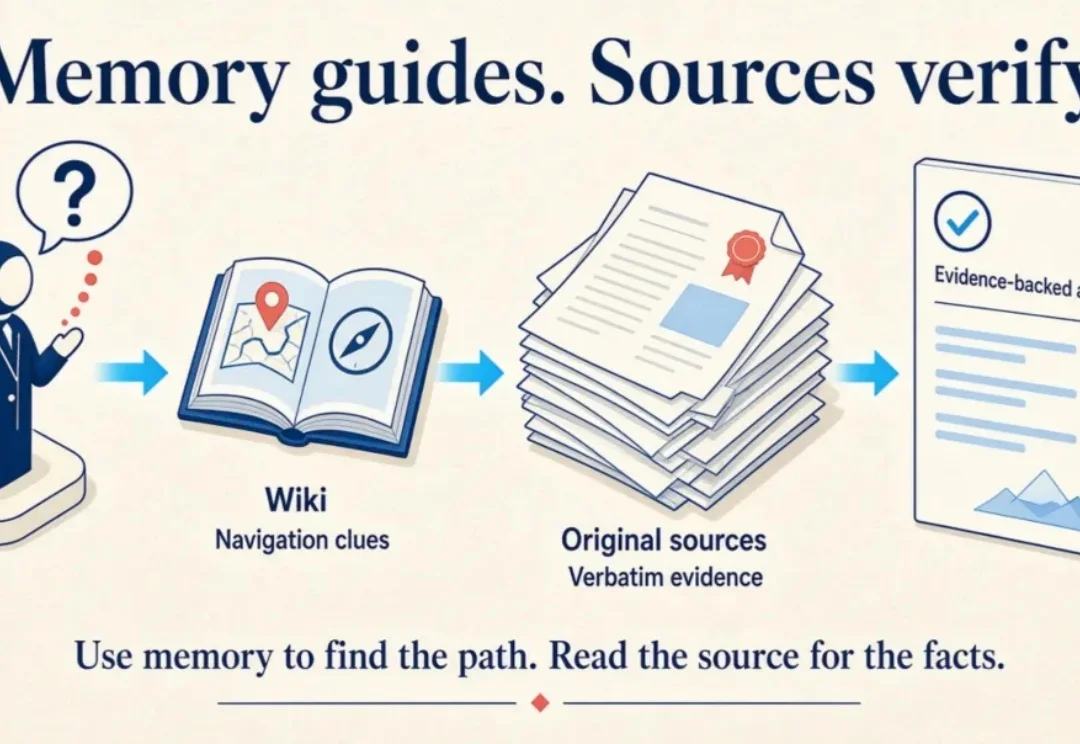
Anthropic是如何设计Agent记忆的,对我们有何启发前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。
搜索
前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。
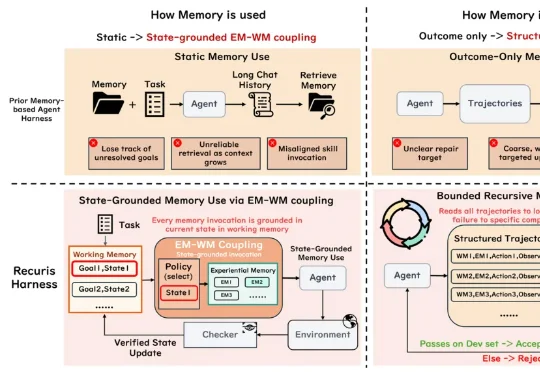
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
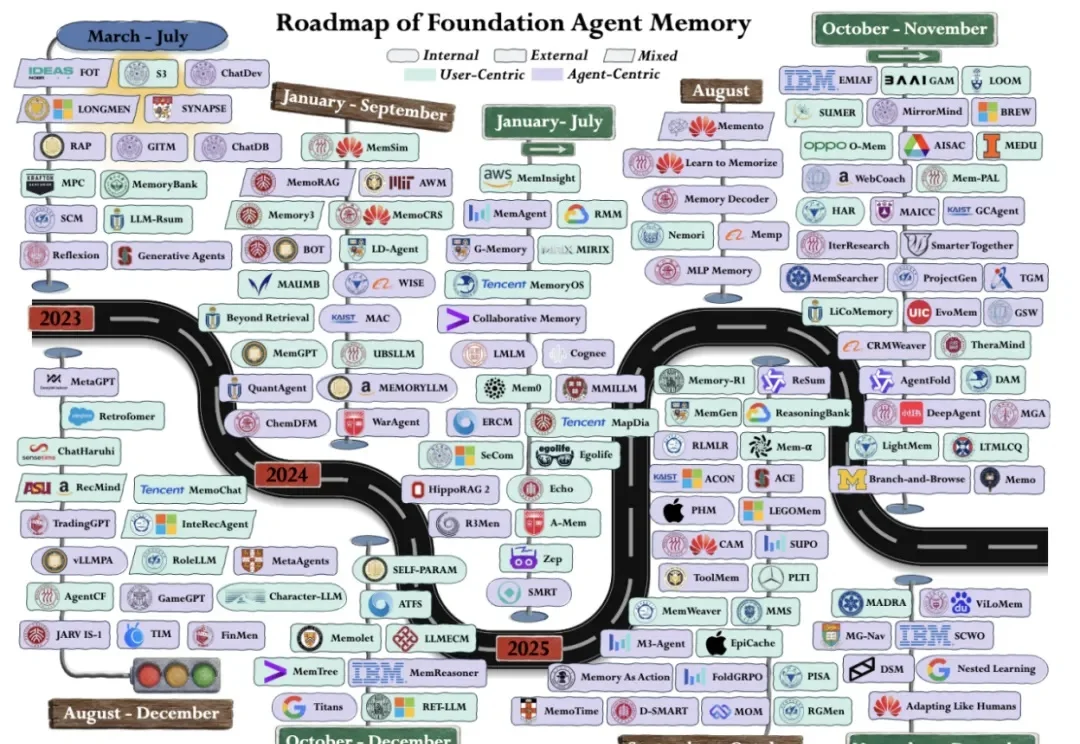
市面上已有几十种Agent记忆方案,有的基于向量检索,有的基于知识图谱,有的靠定期总结“压缩”对话,有的则完全依赖模型自身的上下文窗口。它们各有各的说法,但在系统层面,到底哪种方案靠得住?哪种方案在你的工作负载下既不贵又准?
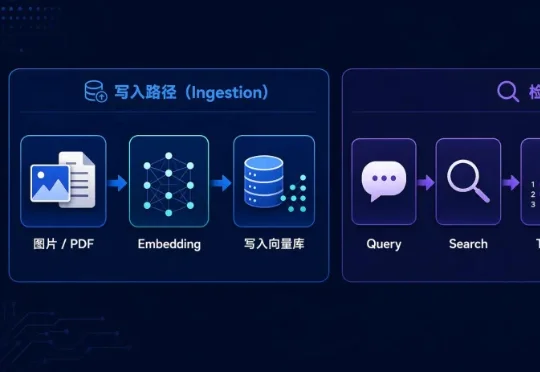
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
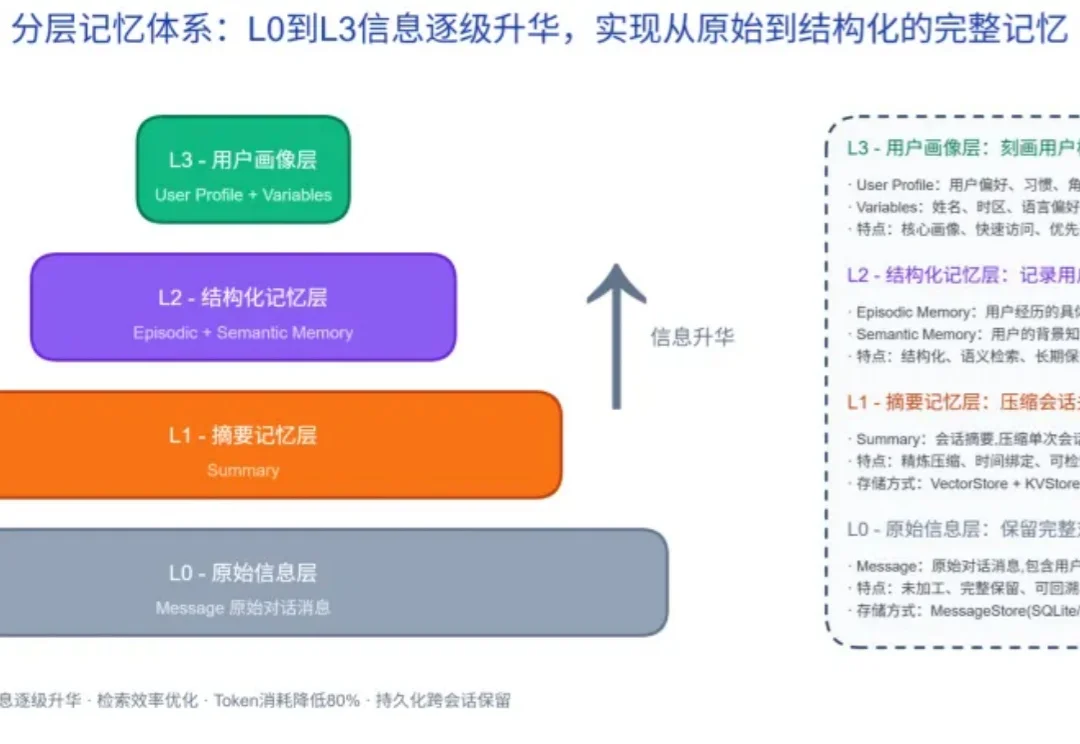
当大模型应用进入深水区,决定一个 Agent 体验上限的,早已不只是 "答得对不对", 而是 "能不能持续记住同一个人"。
在做 Agent Memory 工程化探索的这几个月里,我经常有种被概念淹没的窒息。图结构记忆、AutoMemory、做梦机制、各种层出不穷的 Memory 框架……整个技术社区似乎陷入了一种每遇到一个新场景就要发明一套新词汇的群体焦虑中。
过去半年,几乎所有Agent框架都在补长期记忆能力。最常见的做法,是给系统接一个向量数据库,把历史对话、用户偏好、项目经验、工具调用结果、失败案例都存进去。看起来,只要把“记忆”这块补上,Agent就能从一次性对话工具变成长期协作伙伴。
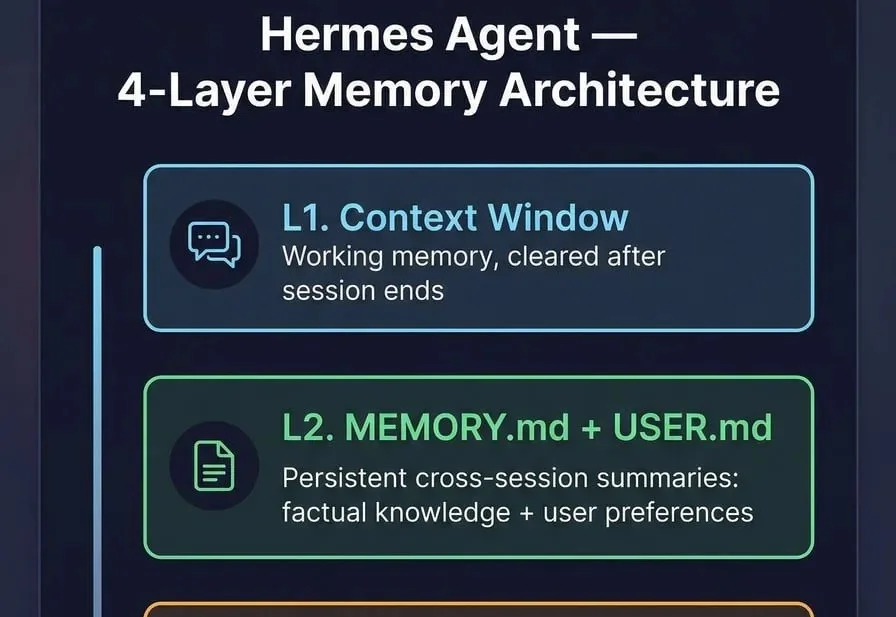
最近Hermes agent被讨论得沸沸扬扬的,今天,我们来深度拆解下它是怎么做Skills 闭环系统的。
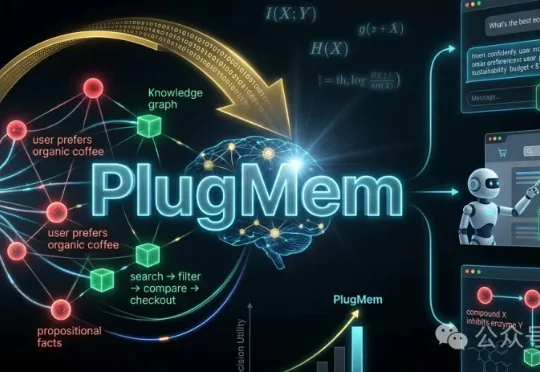
现在的AI agent往往把长交互历史直接存起来,但很难高效复用。最朴素的方法直接从「原始记忆」里检索,但常常把模型淹没在冗长、低价值的上下文里。PlugMem把经验转化为结构化、可复用的知识,并提出一个任务无关(task-agnostic)的统一记忆模块,在多种Agent基准上提升性能,同时消耗更少。
最近,一个叫OpenClaw(小龙虾)的开源项目突然爆火,甚至出现线下排队安装的场面。很多人第一次直观地看到,AI不只是chatbot,而是可以真正“动手”操作电脑、完成复杂任务和个性化工作流的智能体。这意味着AI正在进入下半场,开始走向真实应用,并逐渐进入普通人的日常生活。