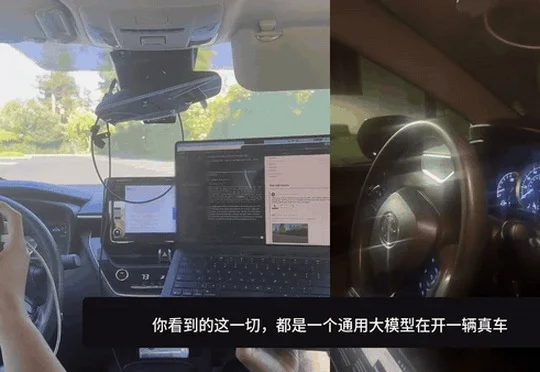
刚刚,GPT-6开真车考过了科目二!
刚刚,GPT-6开真车考过了科目二!硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
来自主题: AI资讯
7388 点击 2026-09-28 16:26

 搜索
硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
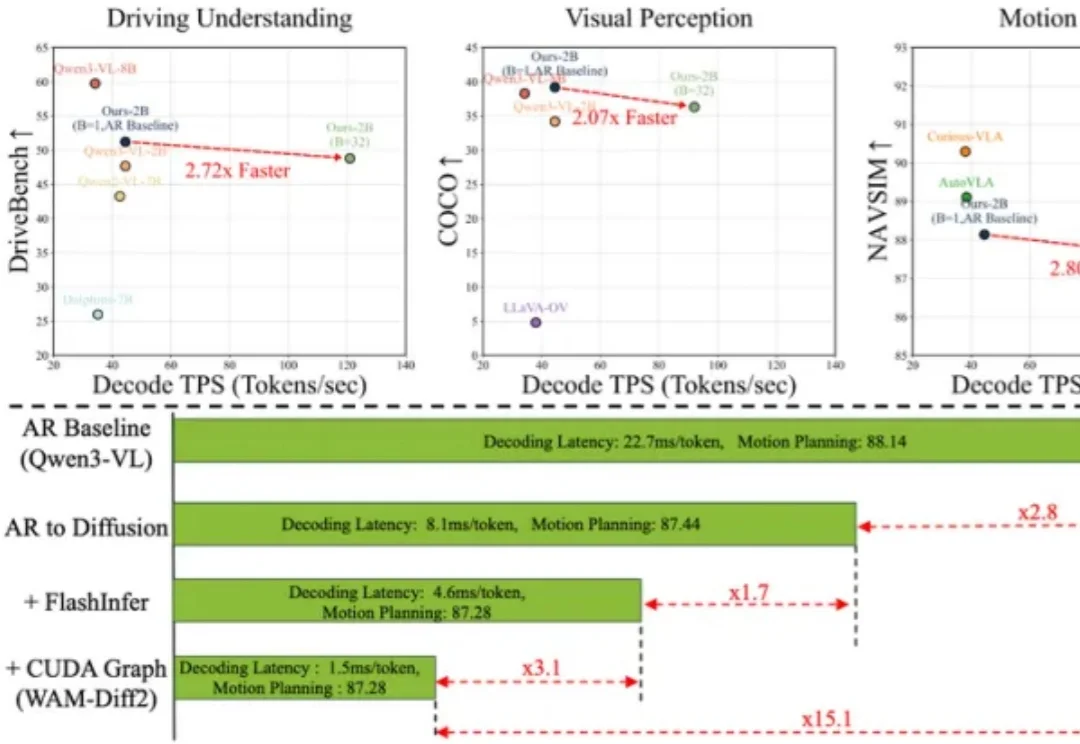
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
7 月 17 日,北京,2026 奇点智能产品大会主会场。吴甘沙站在台上,用一个极其东方的思维框架,拆解了一家物理 AI 公司如何在巨头环伺中活过十年——他把《孙子兵法》的“不败”与“不战”,和诸葛亮《隆中对》的“益州”“荆州”格局,嵌入了一套完整的创业竞争策略。
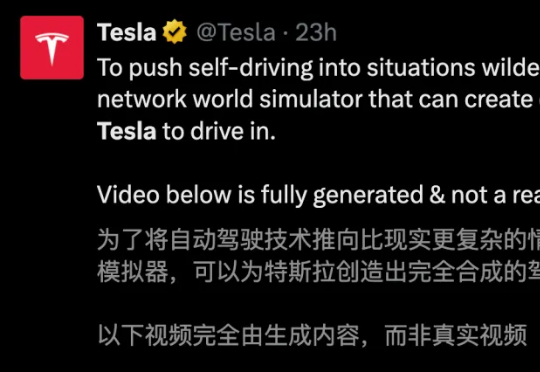
马斯克的终极设想,正在成形。今天,特斯拉放出了「世界模拟器」震撼演示。一个神经网络,每天狂吞500年人类驾驶经验,并在无限的虚拟世界中自我进化。同款AI大脑,擎天柱也可共用。
来自香港中文大学(深圳)等单位的学者们提出了一种名为 DriveGEN 的无训练自动驾驶图像可控生成方法。该方法无需额外训练生成模型,即可实现训练图像数据的可控扩充,从而以较低的计算资源成本提升三维检测模型的鲁棒性。
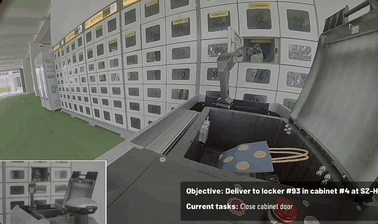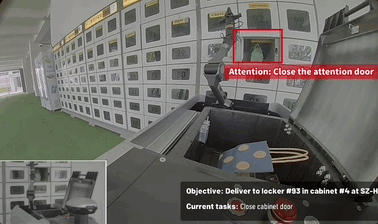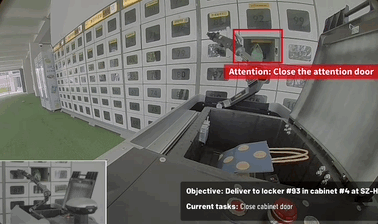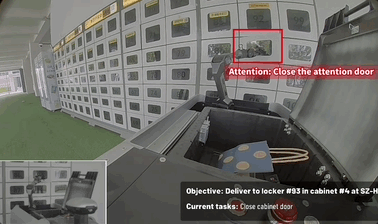
自动驾驶实现垂直领域的AGI,有了新路径。不是Robotaxi,而是RoadAGI。在英伟达GTC 2025上,元戎启行CEO周光受邀分享,提出用RoadAGI,能更快大规模商用自动驾驶,实现垂直道路场景下的AGI,RoadAGI的实施平台,是元戎最新分享的AI Spark:
因为就在岁末年初,一种全新的技术范式正在开启落地,头部玩家有了爆款证明,引领行业跟进对齐,隐隐成为共识趋势……这种技术范式,就是——VLA。
随着汽车进入“AI驱动”的时代,不止各大品牌新车拼智能,出行平台也在布局面向智驾产业的“自动驾驶工具链”。
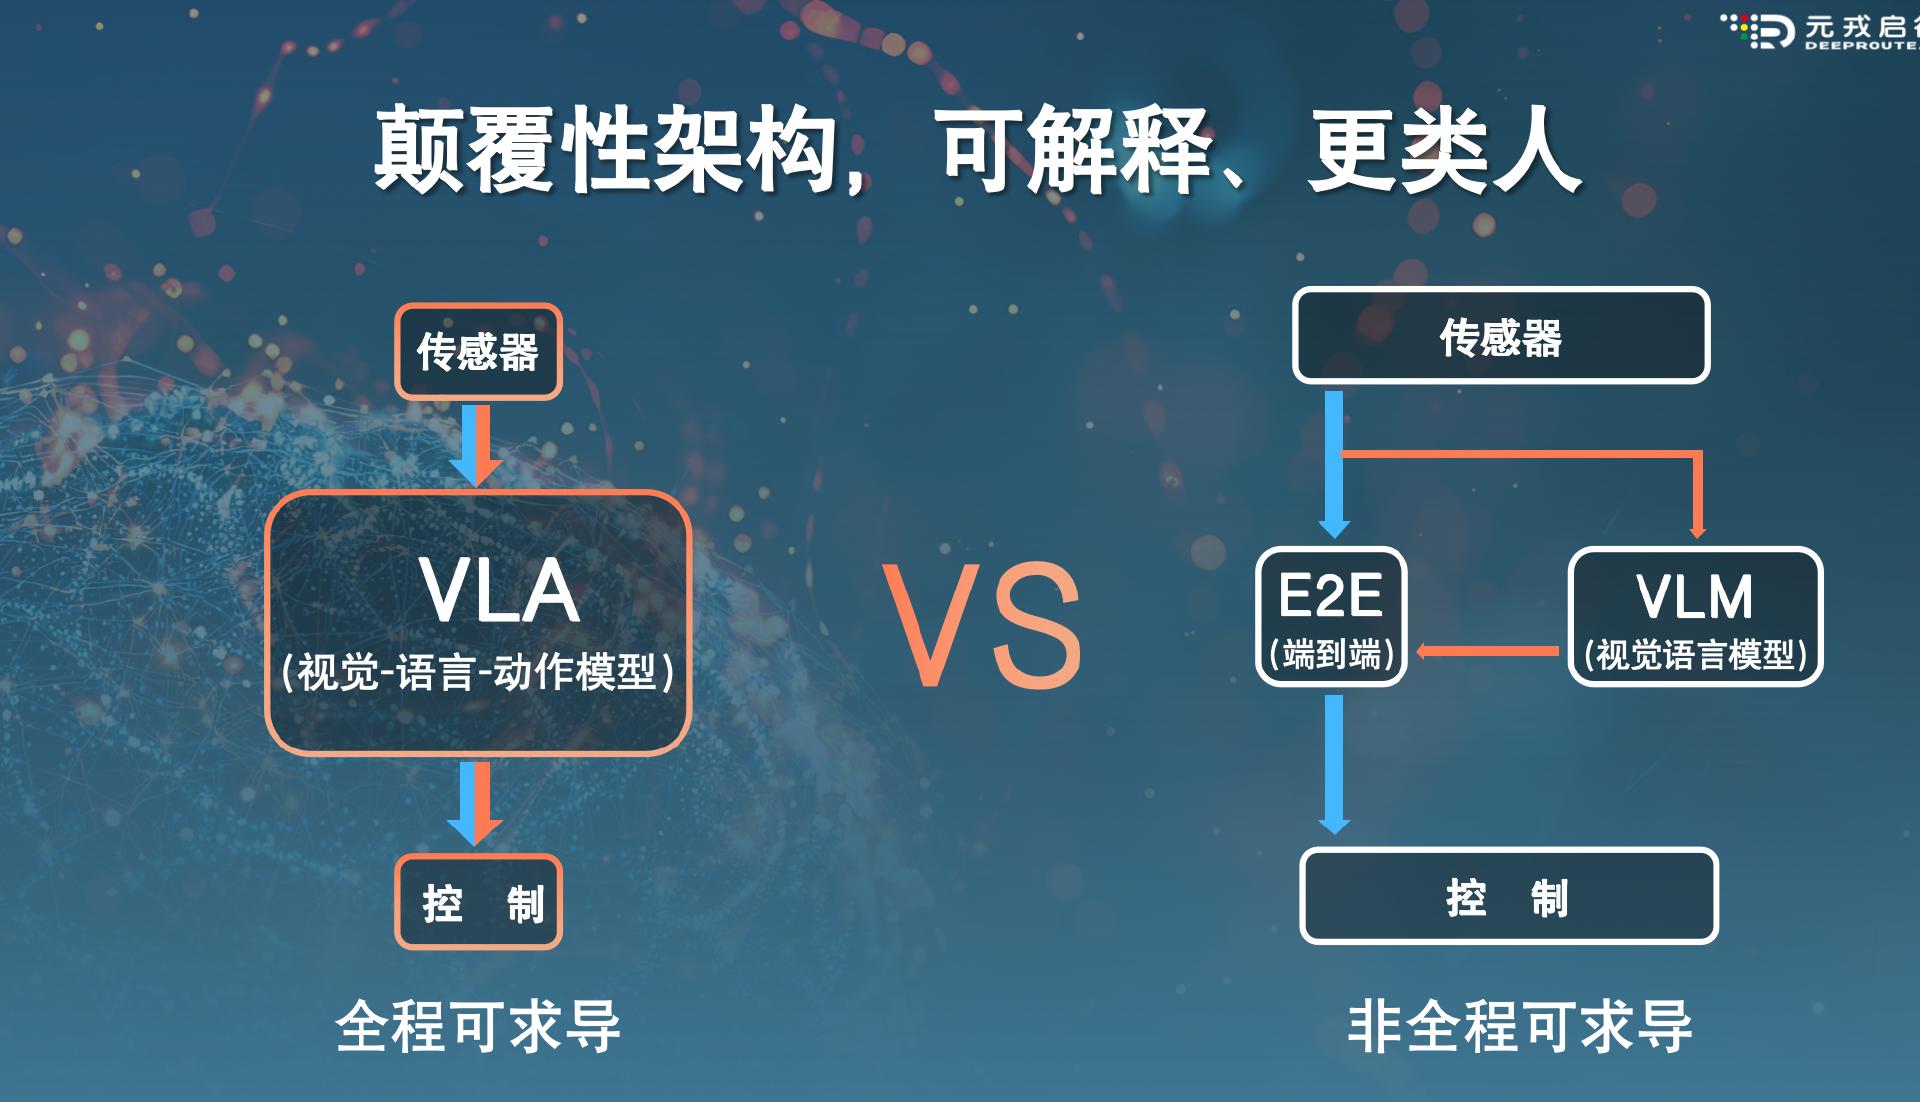
近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
全自动驾驶系统的纯视觉方案如特斯拉 “Tesla Vision”,仅依赖于摄像头收集的图像数据,旨在实现高效且成本效益高的自动驾驶技术。