实测Opus 5.5:一句提示词造出100个网页,还会做动画谱曲
实测Opus 5.5:一句提示词造出100个网页,还会做动画谱曲实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
来自主题: AI资讯
6735 点击 2026-09-25 10:12

 搜索
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
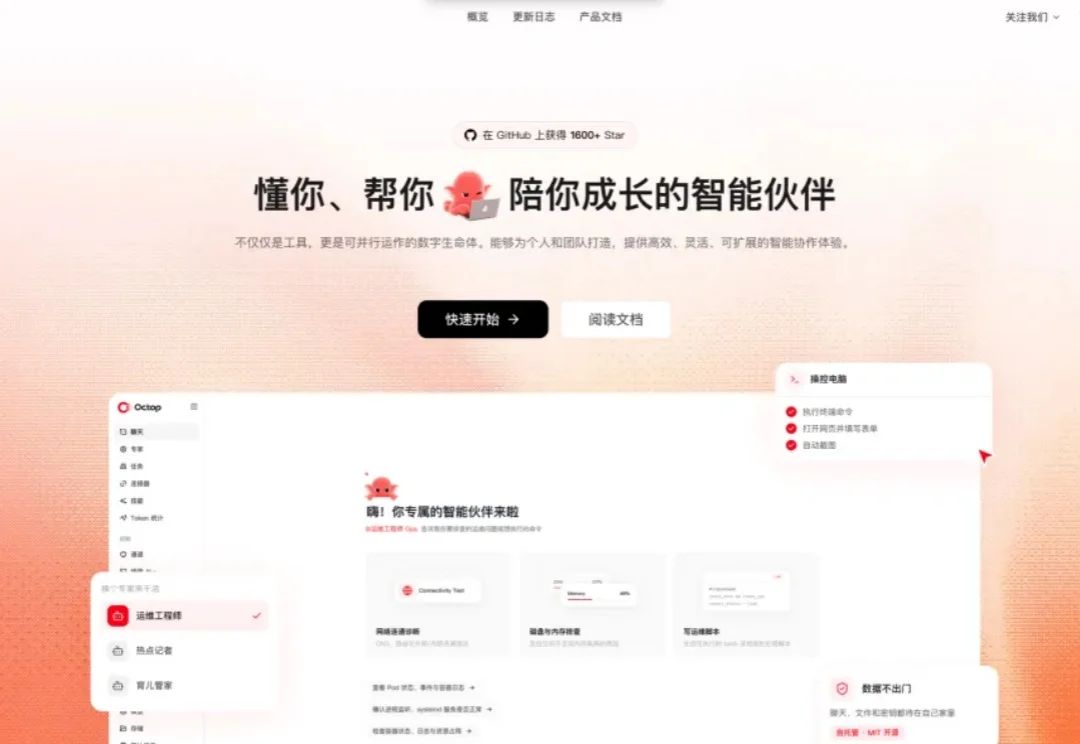
经过 Octop 团队与社区开发者一段时间的共同推进,在一次次测试、打磨与优化之后,我们正式推出 Octop 1.0 GA版本(General Availability,正式发布版),并同步上线腾讯云轻量应用服务器(Lighthouse)与云服务器(CVM)官方应用镜像——购买即用的自托管 AI 助手,现在触手可及。
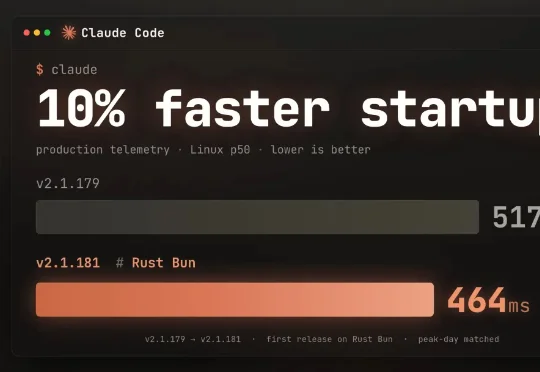
这个 JavaScript 运行时原本拥有 535,496 行 Zig 代码,不包括注释;同时,约 20% 的代码由 C++ 编写,并嵌入了多个 C/C++ 库。此次借助 AI 重写为 Rust,整个过程涉及超过 100 万行代码变更、6778 次提交,并在 Claude Code 中运行了大约 50 个动态工作流(dynamic workflows)。
硅谷创投哲学家纳瓦尔·拉维坎特(Naval Ravikant)有一个著名的论断,令人印象深刻:“在一个拥有无限杠杆的世界里,判断力是最重要的技能。”我们一直以来对AI的忧虑——失业、偏见、安全……,或许都只是冰山浮出水面的部分。海面之下,一个更巨大、更隐蔽的变革正在发生。
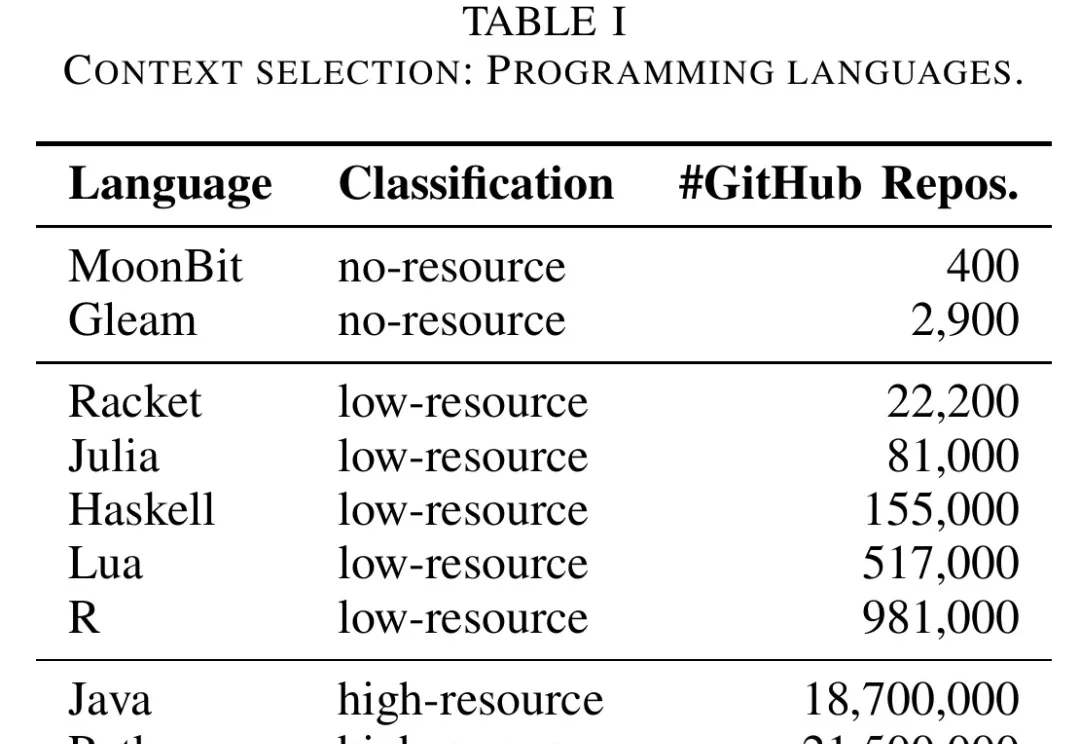
对于Python、Java、JavaScript这些语言,大模型通常能给出相当成熟的答案。
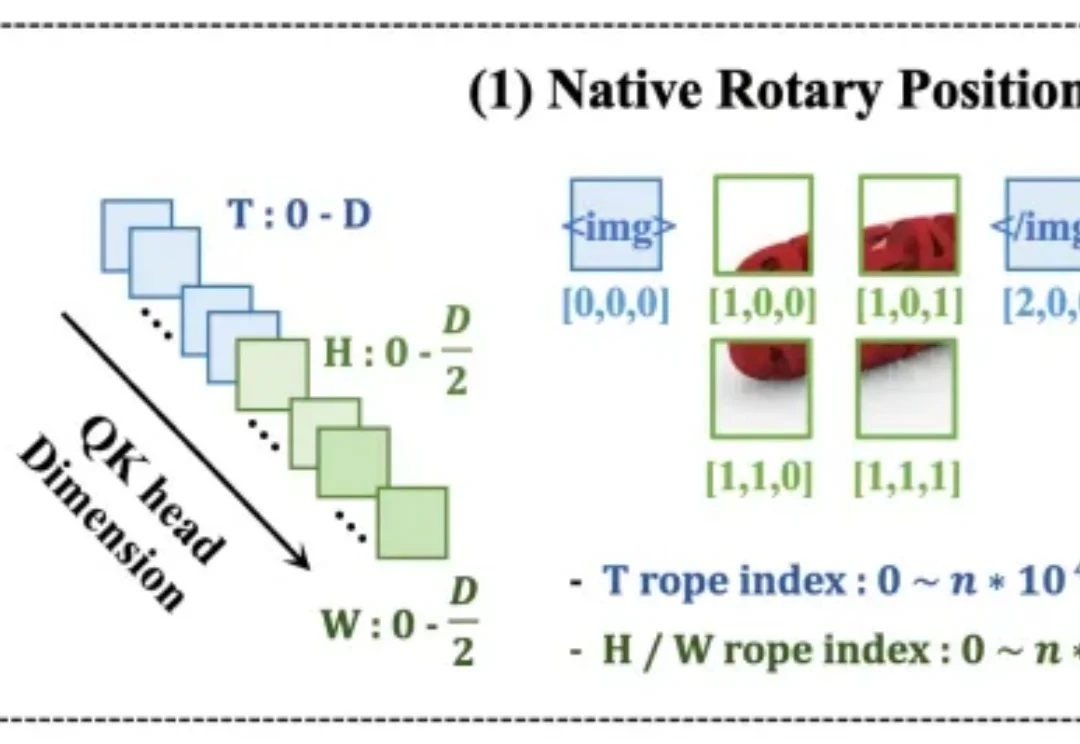
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
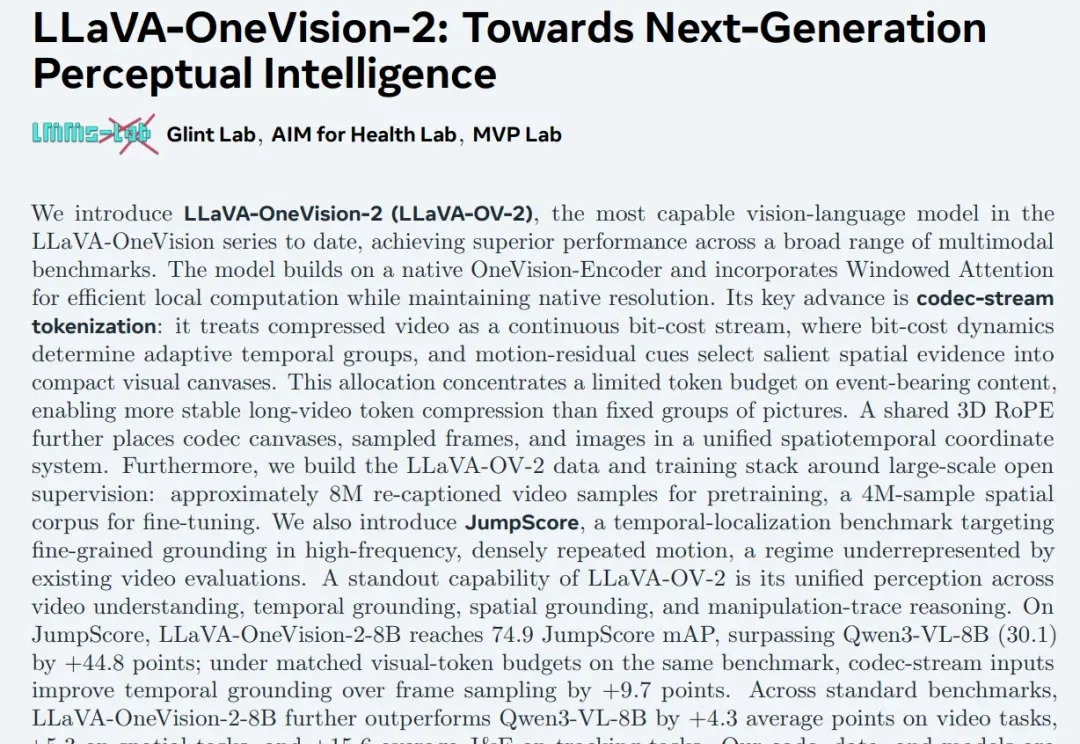
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
就在今天,美团龙猫大模型团队突然开源了商用级数字人视频生成模型 LongCat-Video-Avatar 1.5。在权威评测中,它的用户偏好胜率全面超越 Kling Avatar 2.0、OmniHuman-1.5 和 HeyGen 这三个头部玩家,并且直接以 MIT 协议开放,连商用限制都懒得设。
时隔近一年,那个在 B 站教大家阅读 AI 论文的大神李沐 @跟李沐学 AI,终于回归了!
最近,创作者平台 Wirestock 宣布完成 2300 万美元 Series A 融资,由 Nava Ventures 领投,SBVP(Sheryl Sandberg 参与创立)、Formula VC 与 I2BF Ventures 参投,公司累计融资规模达到约 2600 万美元。