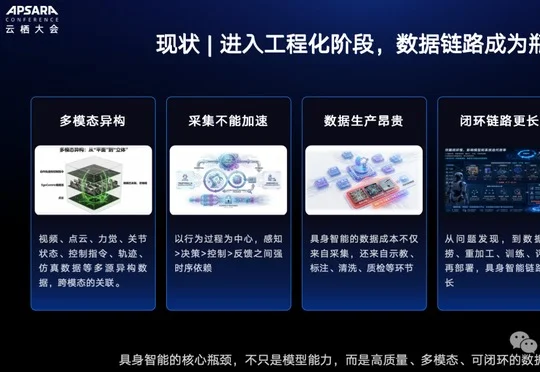
从真机到世界模型,具身智能正在补一条看不见的数据产线
从真机到世界模型,具身智能正在补一条看不见的数据产线在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
来自主题: AI资讯
7623 点击 2026-09-25 10:09

 搜索
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
艾斐智药成立一个多月便完成亿元天使轮融资,由襄禾资本领投、星连资本等跟投,并依托DrugCLIP、PharmAgents探索AI原生药物研发及共同开发模式。
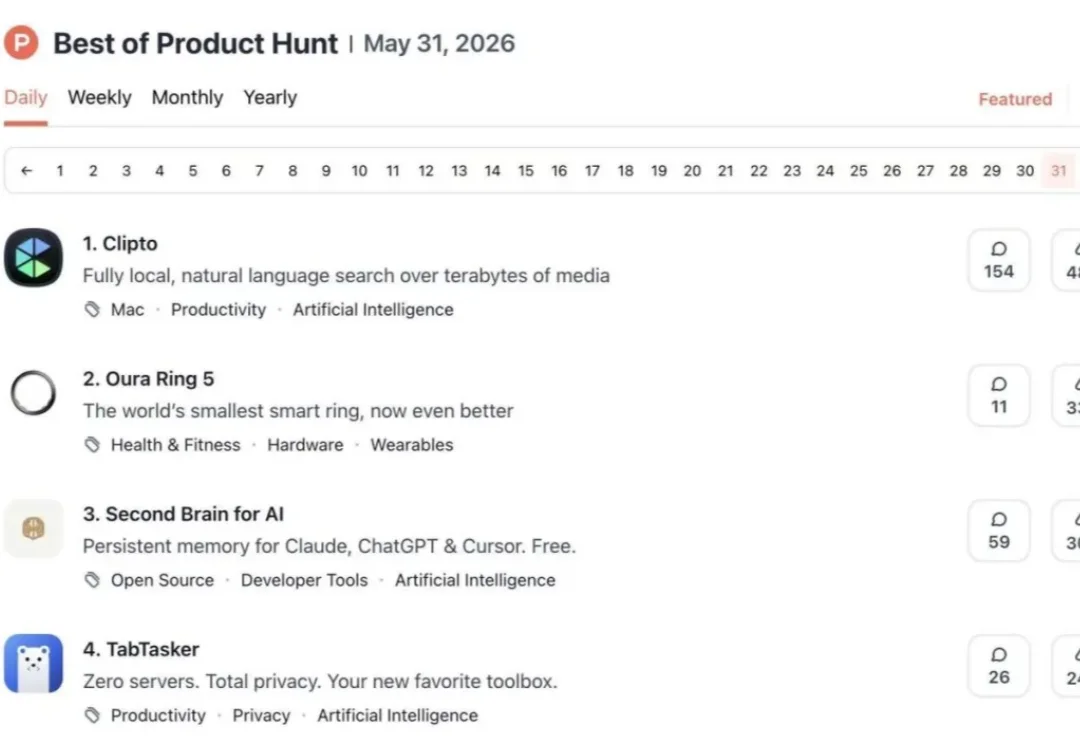
AI 文件搜索公司 Clipto 完成 1500 万美元融资,投后估值 2.5 亿美元,红杉中国、高瓴创投等参投,其创始人、CMU 博士 Henry Kang 带领团队利用 AI 为用户电脑中的视频、音频、图片和文档建立索引,公司年度经常性收入已达 1500 万美元。
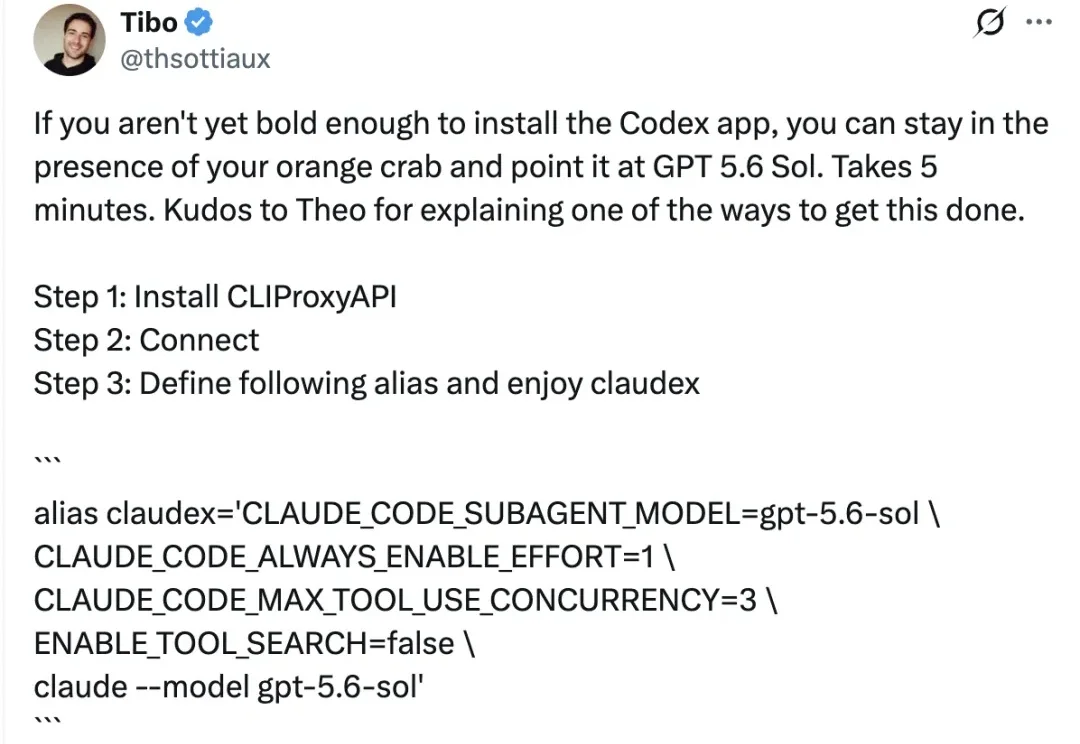
这事听着像钓鱼帖,但偏偏是真的。
OpenAI高管亲自下场,教开发者5分钟极速「策反」Claude Code,这波贴脸开大太狠了。
模型会升级,Agent会重构,但用户长期积累的记忆不会轻易迁移。
押注 AI 的 Memory Layer。
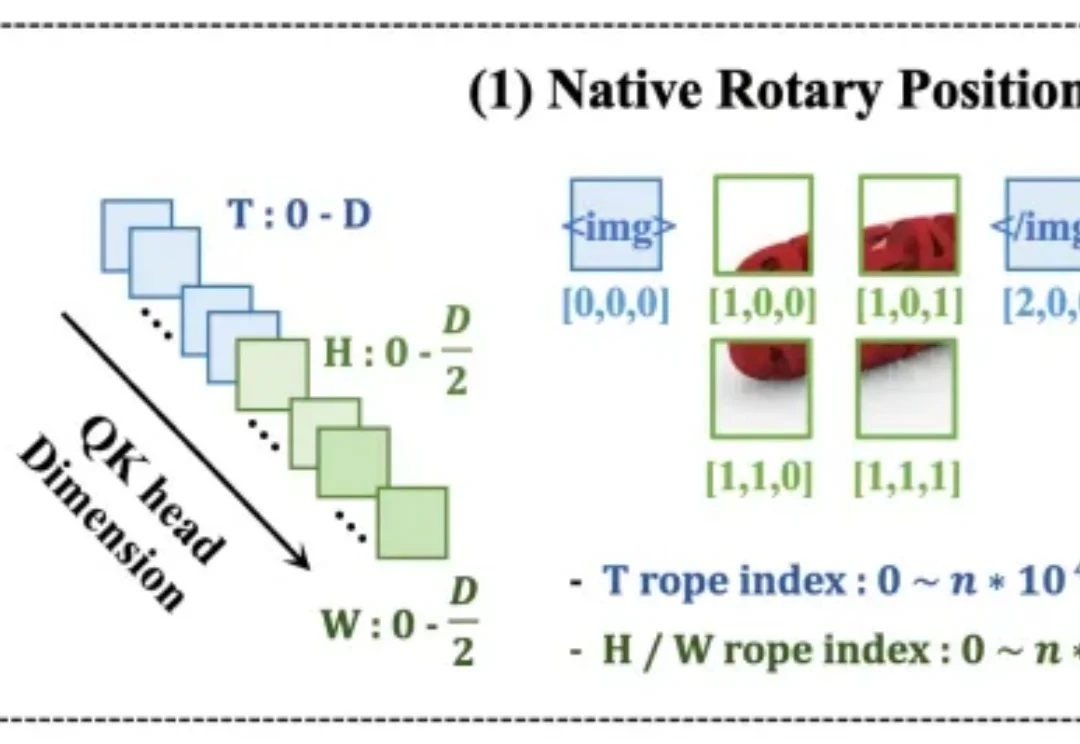
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
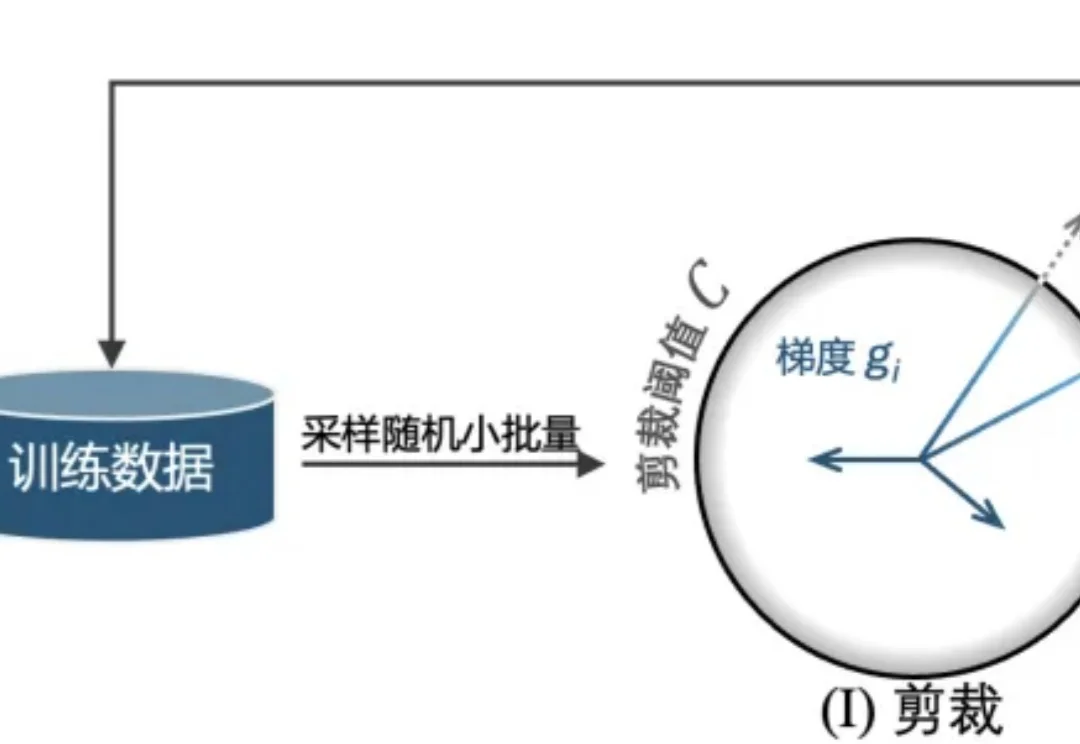
近日,来自英国南安普顿大学(University of Southampton)和广州大学的研究者团队提出 SlaClip,一种用于差分隐私随机梯度下降(DP-SGD)[1] 的自适应梯度剪裁方法。
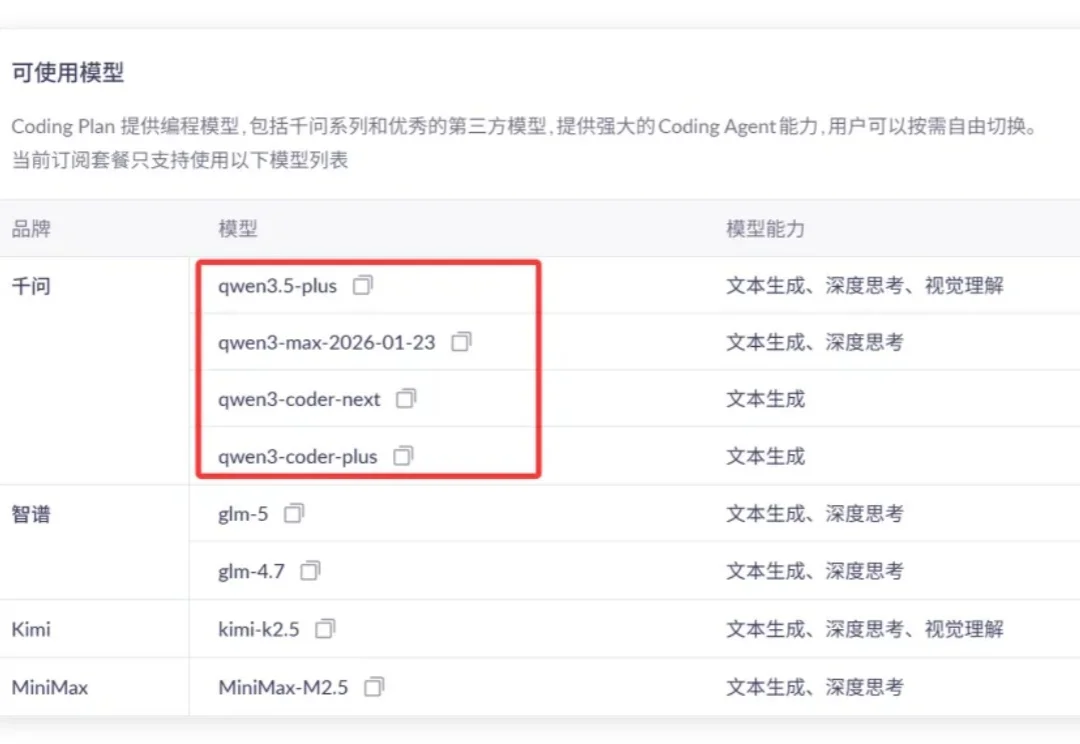
昨天我发现 Qwen3.6“倒反天罡”。