扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26
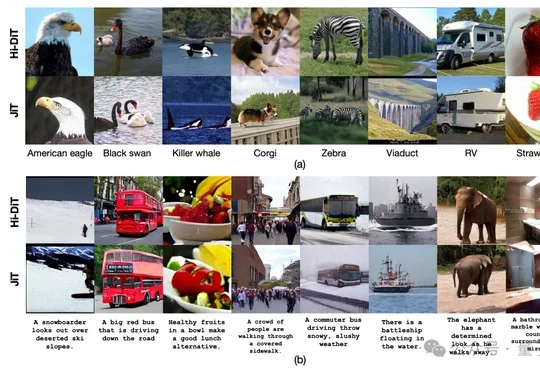
扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
搜索
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
最近看到了一个挺有意思的东西,就是TypeSafe AI 做的 Jev。Reddit 上很多人用它玩 DOOM,也有人拿它玩 Mario。我申请之后,拿到 API Key 后,也做了一个网页小游戏,想看看它到底在里面起什么作用。一开始,我最想弄清楚的其实很简单:同样是让 AI 操作游戏,为什么要用 Jev?GPT 不能做吗?当然能。
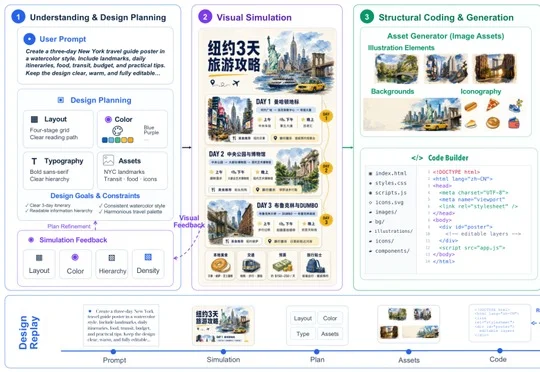
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。
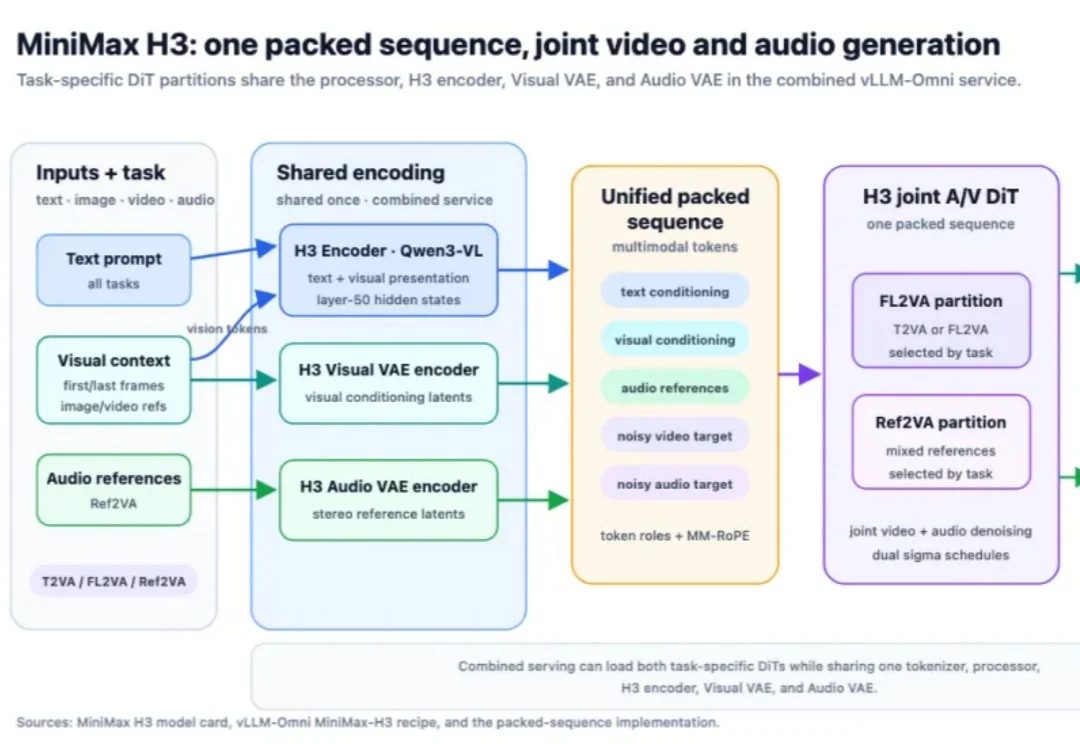
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
有多少人知道或者玩过人人网/校内网?绝对不是要蹭孙割流量……
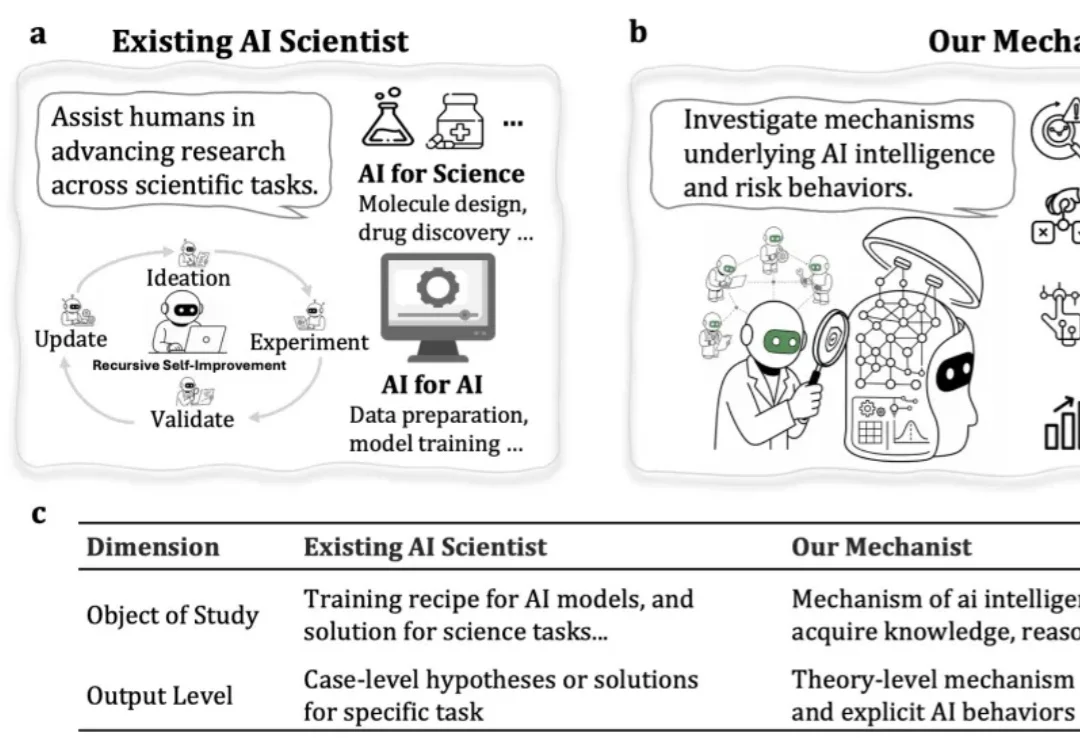
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
浙大与港大团队开源轻量化记忆路由器LayerRecall,通过选择性检索历史记忆并仅注入对长程信息敏感的特定DiT层,解决长视频生成中角色离场再返回时身份与属性丢失的问题,在MemoBench和MovieBench评测中取得Overall第一,且约6.6MB的路由权重可零再训练迁移至其他视频生成骨干。
香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
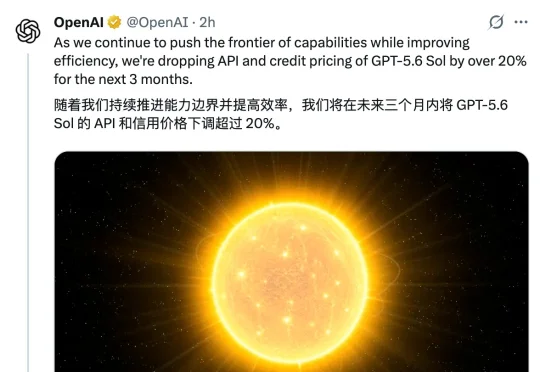
突发,GPT-5.6 Sol 开启大幅降价!未来三个月,API 价格和 credit 价格(超出计划包含额度后的按需付费用量)一起砍掉超过20%。目前,API 端已经即时生效,符合条件的 ChatGPT Work 和 Codex credits 正在陆续推送。
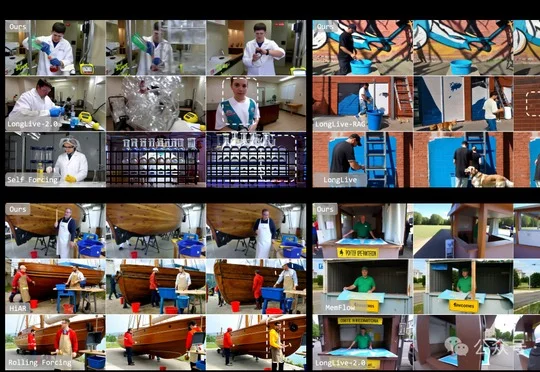
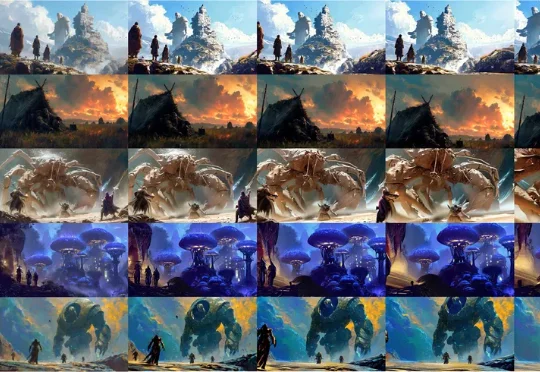
今天的视频生成模型,已经越来越像一个会拍电影的导演。