扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26
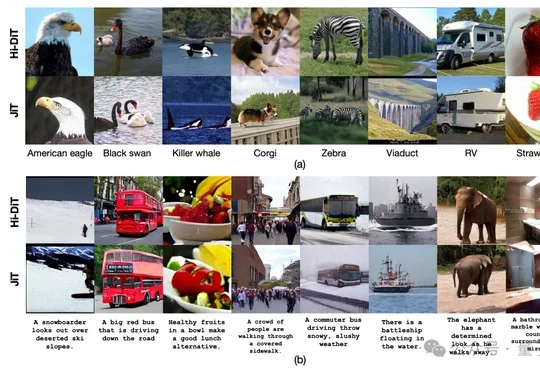
扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
搜索
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
AI 正从看懂画面,走向理解空间、预测变化、执行动作。
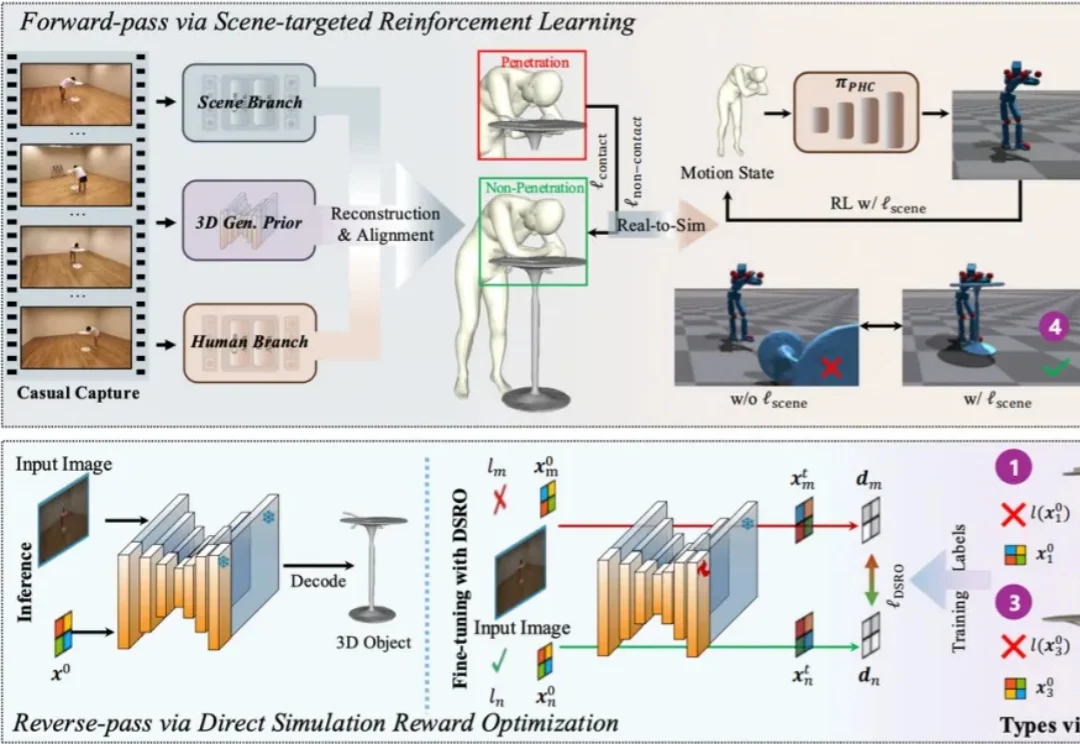
一段人坐上椅子的视频,对人类而言再普通不过。我们不仅能看见 “人坐了下来”,还天然理解椅子承受人体重量,人与椅面形成接触并最终稳定,这些重力、接触与作用关系共同构成真实世界中的物理交互。但对今天的三维重建系统而言,“看见动作” 与 “重建真实交互” 仍是两回事。一个视觉上准确坐在椅子上的人体,进入物理仿真后,椅子可能因结构缺失倒下,人体也可能与椅面严重穿模。视觉上成立,并不意味着物理交互上成立。
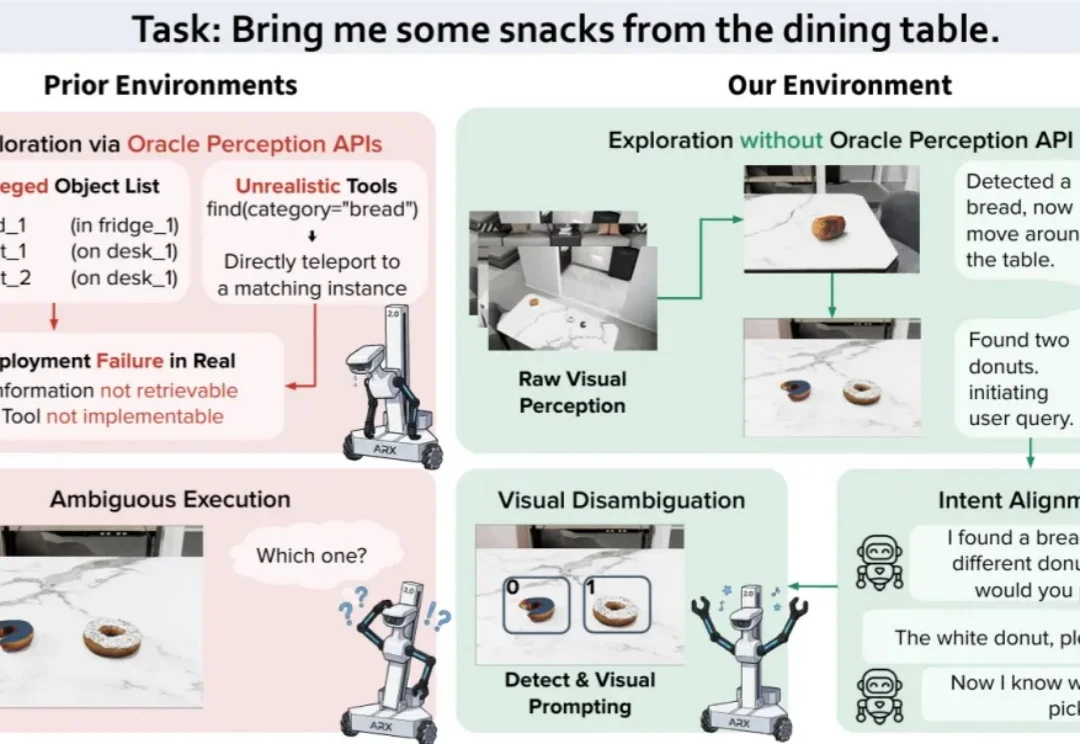
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。
给生成模型引入仿真,补上难以获得的声音感知。
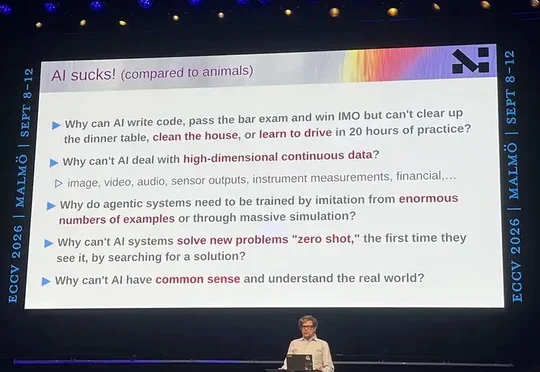
图灵奖得主Yann LeCun在ECCV 2026发表Keynote演讲,论证"预测像素"是伪命题,阐述JEPA在抽象表征空间预测世界的机制,并建议研究者放弃生成式模型与大语言模型,转向联合嵌入架构与世界模型以实现人类水平智能。
蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
机器之心编辑部 几个小时前,ECCV 公布了今年度的最佳论文奖等奖项。 ECCV(European Conference on Computer Vision,欧洲计算机视觉国际会议)是计算机视觉(C
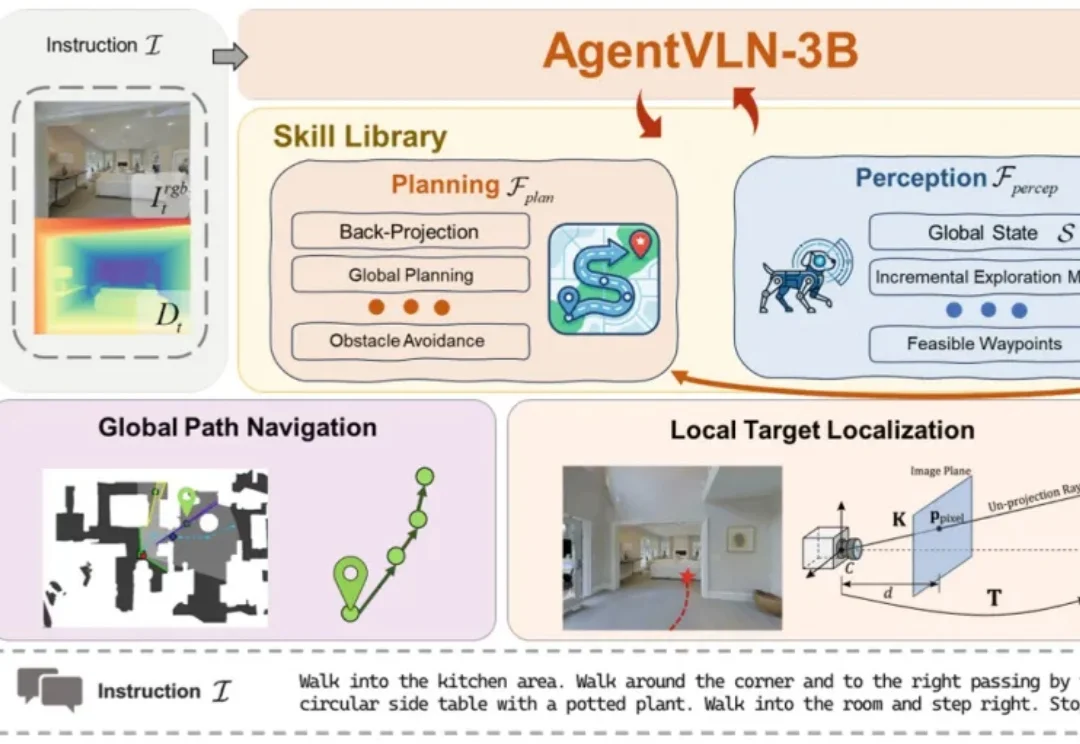
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
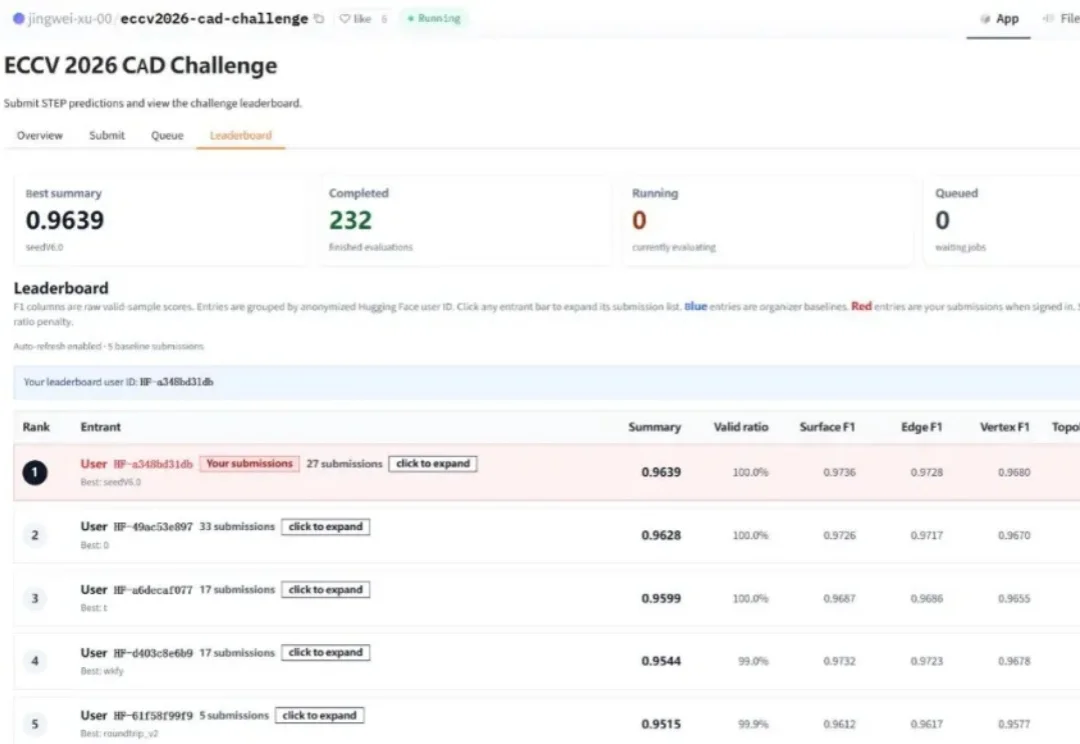
近日,ECCV 2026 官方 CAD Challenge 最新榜单公布,比特无限联合武汉大学团队,凭借自研智能体系统取得 96.39 分的成绩,击败其余 27 家全球队伍,拿下全球第一。