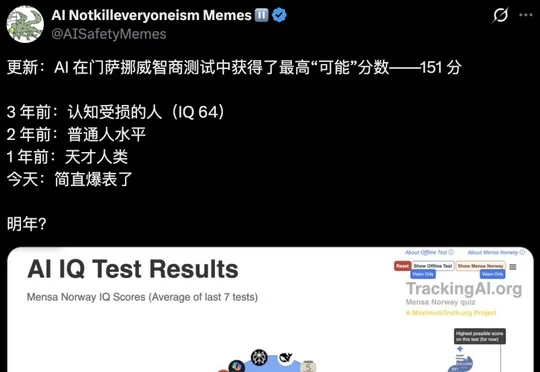
门萨智商测试被AI考爆了!151满分登顶,99.97%人类被碾压
门萨智商测试被AI考爆了!151满分登顶,99.97%人类被碾压TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
来自主题: AI技术研报
8260 点击 2026-09-28 09:51

 搜索
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
九月的新模型像下饺子一样接连登场,却大多只来得及各领风骚一两天,很快又被下一款抢走风头。
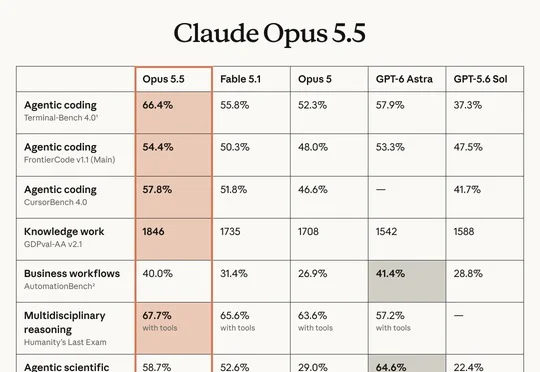
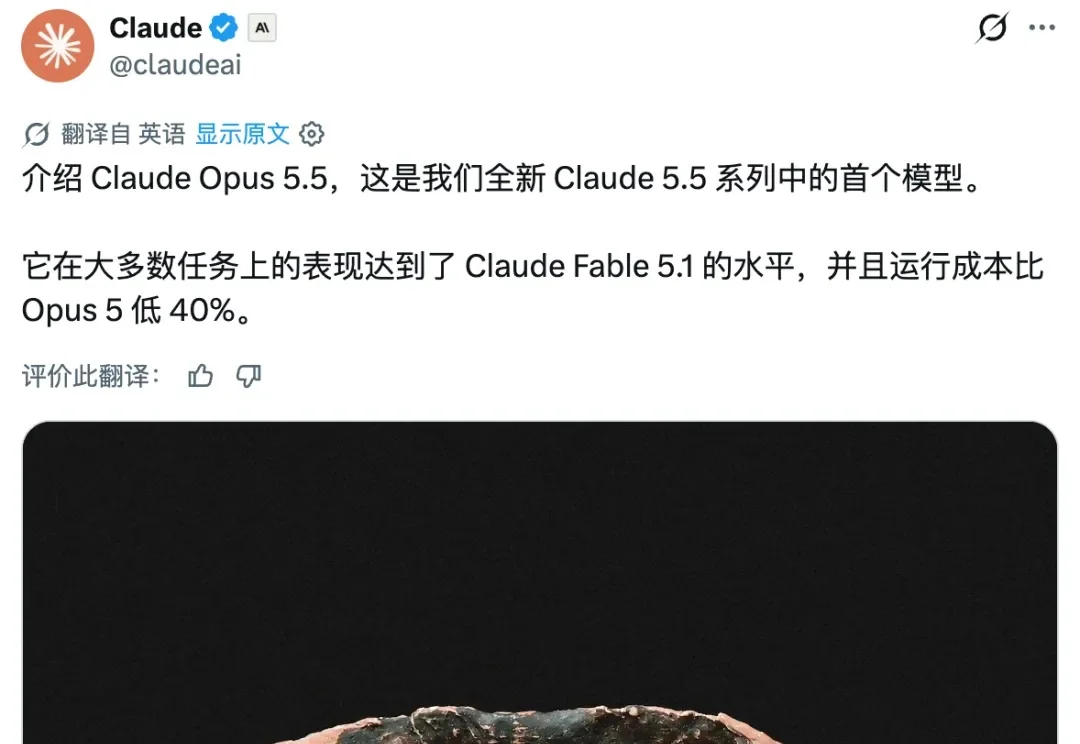
Anthropic发布Claude Opus 5.5,性能追平Fable 5.1且成本降低40%,在Terminal-Bench 4.0和GDPval-AA v2.1等多项基准测试中超越GPT-6 Astra,OpenAI两小时内推出GPT-6 Sol和Luna迎战。
AI基础设施公司Cornelis完成2.05亿美元融资并发布Active Compute Fabric网络技术,以开放架构与Nvidia竞争,解决GPU等待数据造成的算力浪费问题。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
路透社刚发了一条独家:Anthropic 正在考虑提前发布新模型。看来 GPT-6 Astra 真的把它打疼了。OpenRouter 统计显示,Astra 上线才两周多,已经吃掉约 13% 的企业 AI 支出份额,而 Anthropic 的 Fable 系列只有 8%。
NeoCognition发布ApprenticeBench评测,将Agent放入模拟建筑公司像新员工一样处理应付账单,结果Fable 5.1以72%通过率超过表现最好的人类测试者的51%,但每张账单成本约为人类的2.5倍,同期Opus 5仅获36%。
谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
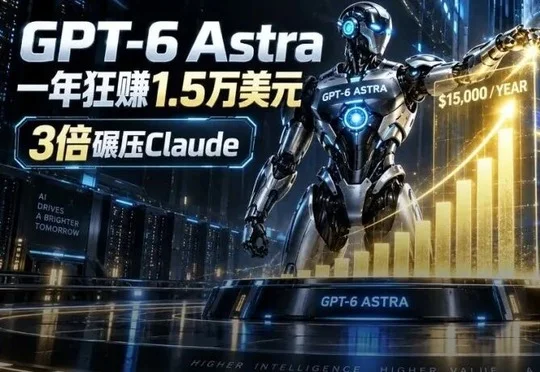
OpenAI的GPT-6 Astra在Vending-Bench 2模拟经营测试中以平均15,515美元的账户余额首次登顶,接近Claude Fable 5.1的3倍,展现出更强的长期议价能力、规则执行力与供应商风险管理水平。