ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式
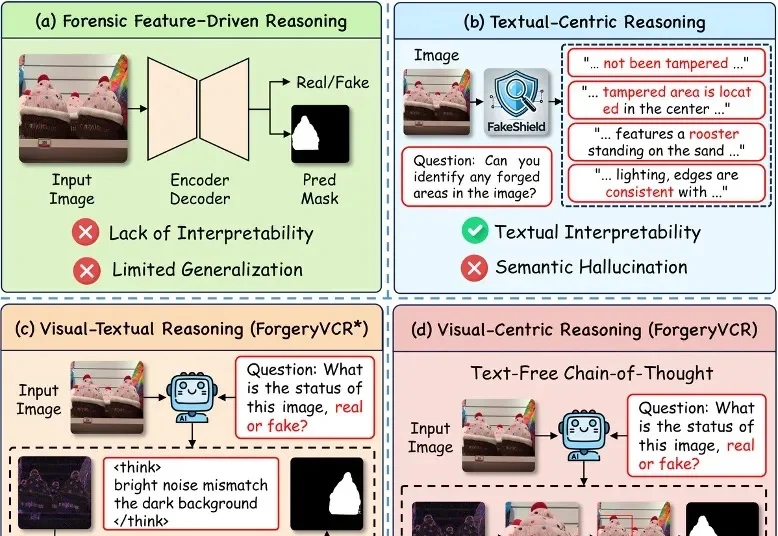
ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
搜索
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
AI几小时就能完成单个应用优化,研发效率提升百倍。
当前,中国正处于从「制造大国」向「智造强国」跨越的关键历史节点,其中工业软件(如CAE仿真、流体力学计算、电磁EDA等)是这一历史转折的核心桥梁。
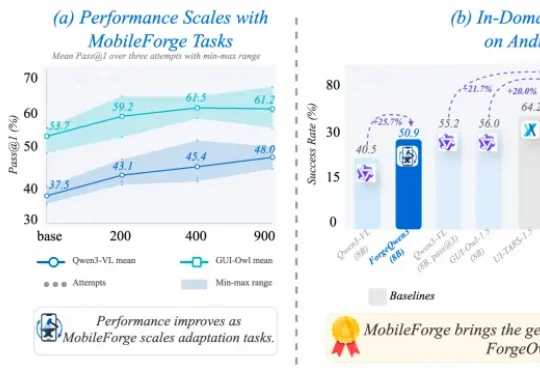
来自浙江大学 APRIL 实验室、快手主站技术部和清华大学的研究团队提出了 MobileForge,试图把手机 GUI Agent 的适配过程变成一个 “无标注、自探索、自反馈、自优化” 的闭环系统。
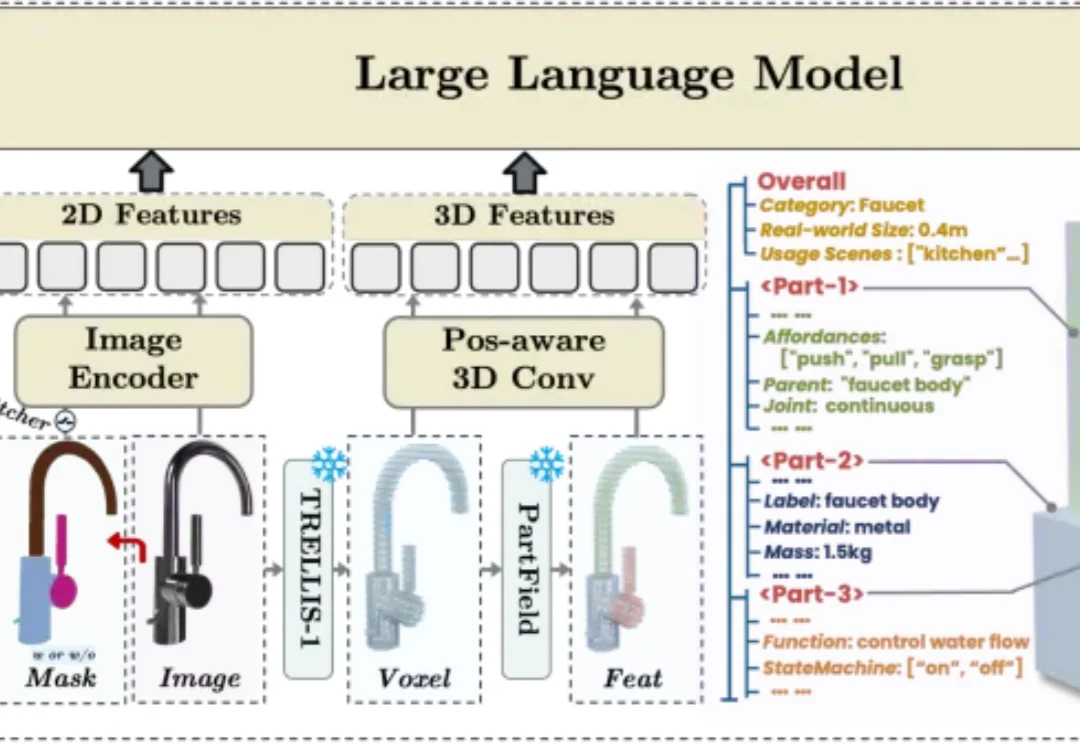
在交互式虚拟世界和具身智能快速发展的今天,高质量 3D 资产已经不再只是 “看起来像” 就足够。一个柜门不仅要有柜门的外观,还需要知道绕哪条轴旋转;一个按钮不仅要有按钮的形状,还需要具备 “按下 / 弹起” 的状态;一个抽屉不仅要有完整几何,还需要拥有滑动方向、运动范围、材质和质量等物理属性。该研究已被 ICML 2026 接收。
造AI这件事,现在的主角变成了AI。
随着 MiniMax M2.5 的发布并在社区引发热烈反响,很高兴能借此机会,分享在模型训练背后关于 Agent RL 系统的一些思考。 在大规模、复杂的真实世界场景中跑 RL 时,始终面临一个核心难
CUDA 代码的性能对于当今的模型训练与推理至关重要,然而手动编写优化 CUDA Kernel 需要很高的知识门槛和时间成本。与此同时,近年来 LLM 在 Code 领域获得了诸多成功。
自 Sora 亮相以来,AI 视频的真实感突飞猛进,但可控性仍是瓶颈:模型像才华横溢却随性的摄影师,难以精准执行 “导演指令”。我们能否让 AI 做到: 仅凭一张静态照片,就能 “脑补” 出整个 3D
近来,由AI生成的视频片段以前所未有的视觉冲击力席卷了整个互联网,视频生成模型创造出了许多令人惊叹的、几乎与现实无异的动态画面。