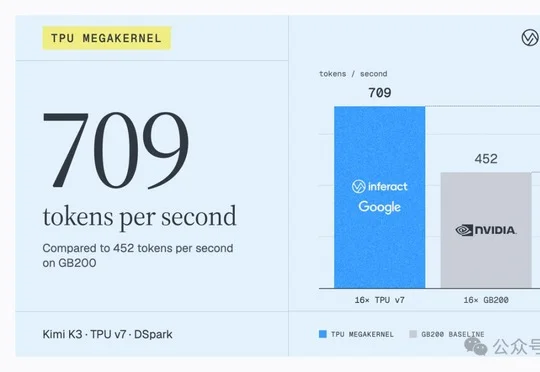
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
来自主题: AI资讯
9968 点击 2026-09-26 15:01

 搜索
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
就在刚刚,OpenAI首颗自研芯片Jalapeño「墨西哥辣椒」,交出了首批实测成绩单——AI推理性能,全面反超英伟达GB200和GB300。实测速度直接起飞!Jalapeño一秒能狂吐1459个Token,英伟达GB200只有535个,连一半都不到。
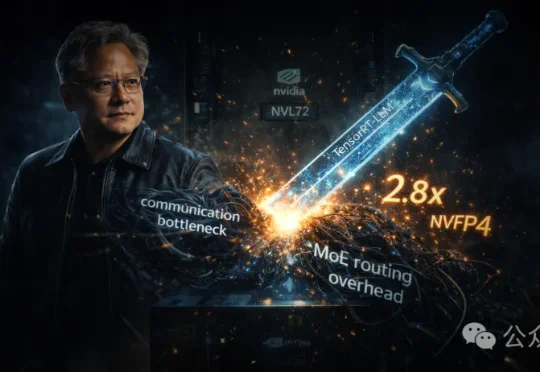
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
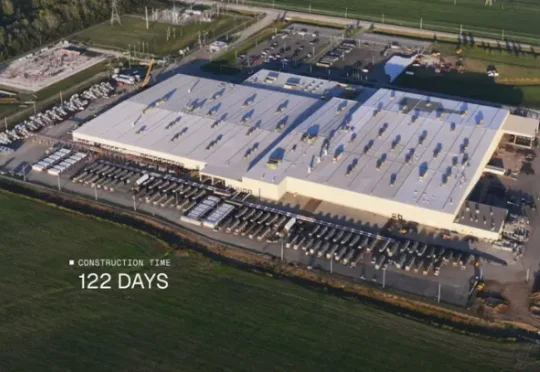
马斯克“巨硬计划”新消息,第三栋专属厂房已经买下来了,代号MACROHARDRR。果然更硬核,老马透露,其将具备2GW供电规模。若参照此前曝光的(200MW支持11万台GB200)的功耗密度与架构效率推算,可支持约110万台英伟达GB200 NVL72 GPU。
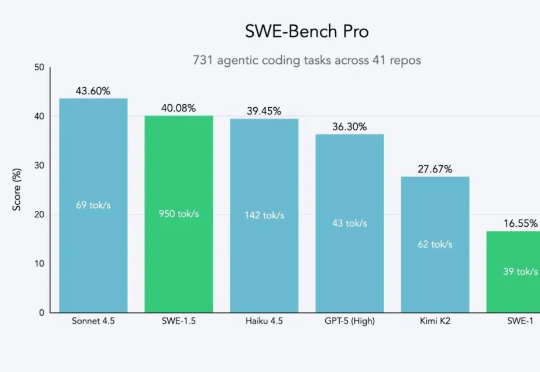
近日,开发出 Devin 智能体的知名人工智能公司 Cognition 推出其全新高速 AI 编码模型 SWE-1.5。据介绍,该模型专为在软件工程任务中实现高性能与高速度而设计,现已在 Windsurf 代码编辑器中开放使用。今年 7 月,Cognition 高调收购开发工具 Windsurf。
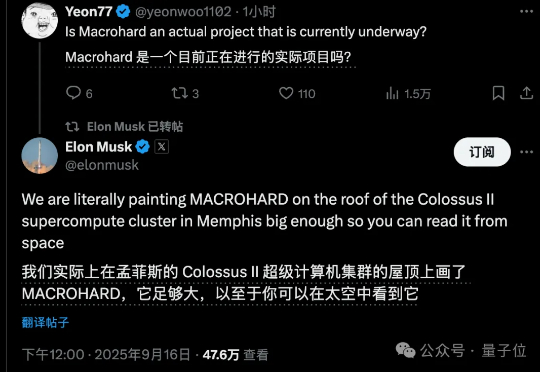
马斯克“巨硬计划”(MACROHARD)新动作曝光: 6个月从0建起算力集群,已完成200MW供电规模,足以支持11万台英伟达GB200 GPU NVL72。仅用6个时间,完成了OpenAI和甲骨文等合作花费15个月完成的工作,再次创造纪录。
“量子计算正在到达一个拐点。”
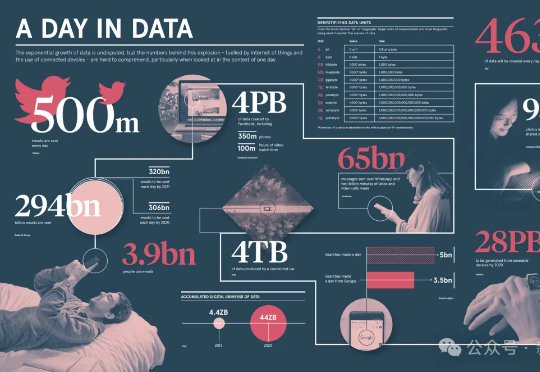
人类进化12000年,只为等AI觉醒?黄仁勋宣布「AI工厂时代」正式到来!从农业到工业再到AI革命,英伟达如何用算力推动历史巨轮?未来,每家公司都将有一个专属的超级智能工厂。并全览目前最先进的GB200 NVL72的详细参数。
2024年英伟达GPU全球最大买家,竟是微软?购买总量将近50万块,超所有竞争对手近两倍。xAI已开心晒出首批发货的GB200 NVL72,喜滋滋的像是提前过年了。囤的GPU越多,模型就会越好吗?来不及解释了,赶紧上车,车门焊死!
抢疯了!马斯克找老黄加价插队拿显卡——为了加速xAI产品研发。