AI资讯新闻榜单内容搜索-GLM

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: GLM
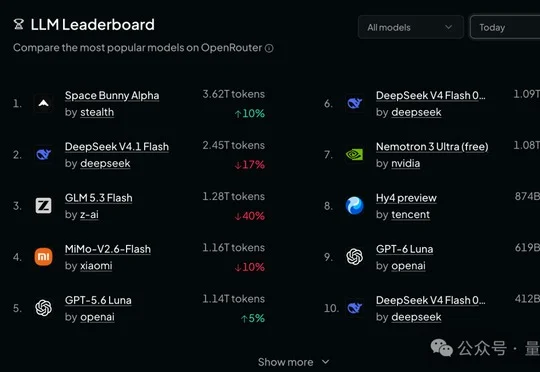
又快又能打!匿名模型玉兔模型杀上双榜第一,Coding实测全记录

又快又能打!匿名模型玉兔模型杀上双榜第一,Coding实测全记录

又快又能打!匿名模型玉兔模型杀上双榜第一,Coding实测全记录

匿名模型Space Bunny突然杀上OpenRouter与OpenCode双榜调用日榜第一,经多个Coding任务实测,其速度快、输出效果良好,首轮细节虽偶有小bug但经一轮交互即可修复,厂商身份尚未公开,网友们纷纷猜测可能来自OpenAI、Grok、Kimi、GLM或Meta等公司。

来自主题: AI资讯
9615 点击    2026-09-27 23:13
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub

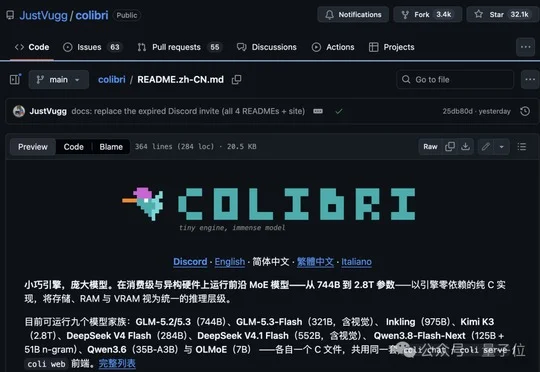
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub

笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub

GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。

来自主题: AI资讯
9711 点击    2026-09-26 15:01
我的上下文资产,凭什么被大厂绑架?

我的上下文资产,凭什么被大厂绑架?

我的上下文资产,凭什么被大厂绑架?

开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。

来自主题: AI资讯
8878 点击    2026-09-25 10:13
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

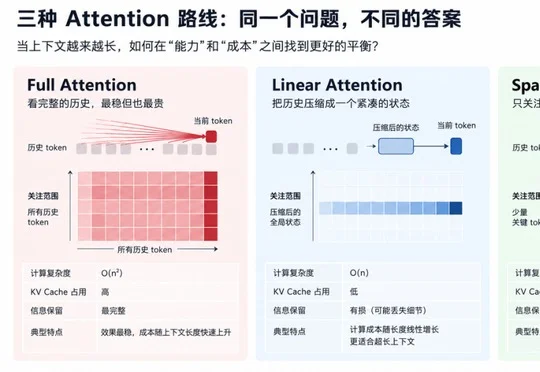
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。

来自主题: AI技术研报
6689 点击    2026-09-25 10:11
PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

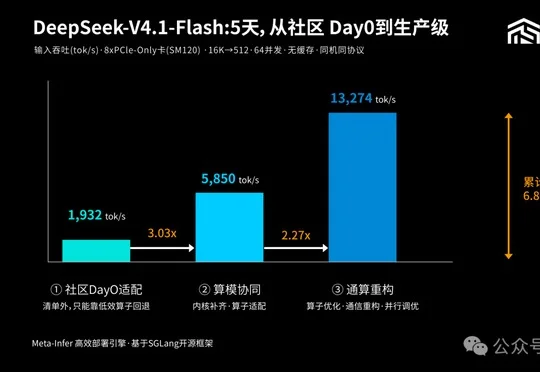
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。

来自主题: AI资讯
7978 点击    2026-09-25 10:09
马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。

来自主题: AI资讯
9316 点击    2026-09-24 10:10
GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

GLM-5.3-FlashX 上线:200 tokens/s

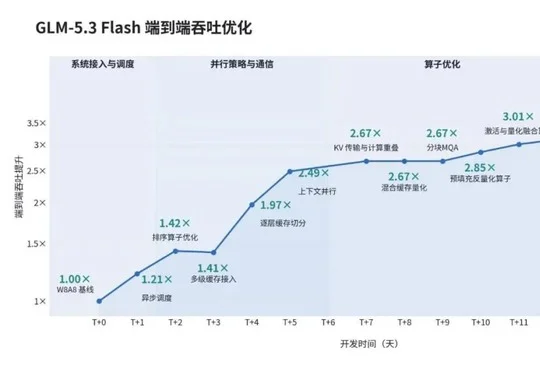
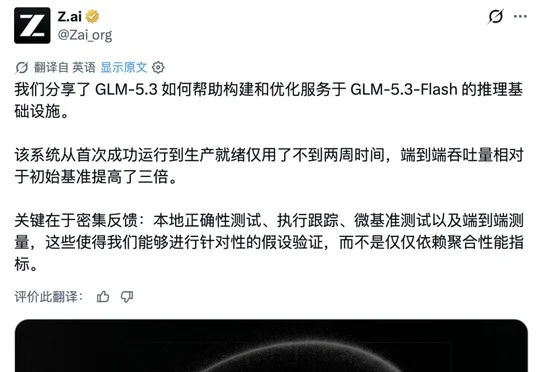
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。

来自主题: AI资讯
8778 点击    2026-09-18 15:49
智谱唐杰突发长文曝RSI进展:Agent优化10万卡集群吞吐暴涨200%,AI造AI还远吗?

智谱唐杰突发长文曝RSI进展:Agent优化10万卡集群吞吐暴涨200%,AI造AI还远吗?

智谱唐杰突发长文曝RSI进展:Agent优化10万卡集群吞吐暴涨200%,AI造AI还远吗?

智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。

来自主题: AI资讯
9489 点击    2026-09-18 15:47
刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

刚刚,智谱首个 RSI 成果发布,10 万国产卡用 GLM 造 GLM

智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。

来自主题: AI资讯
9590 点击    2026-09-17 22:08