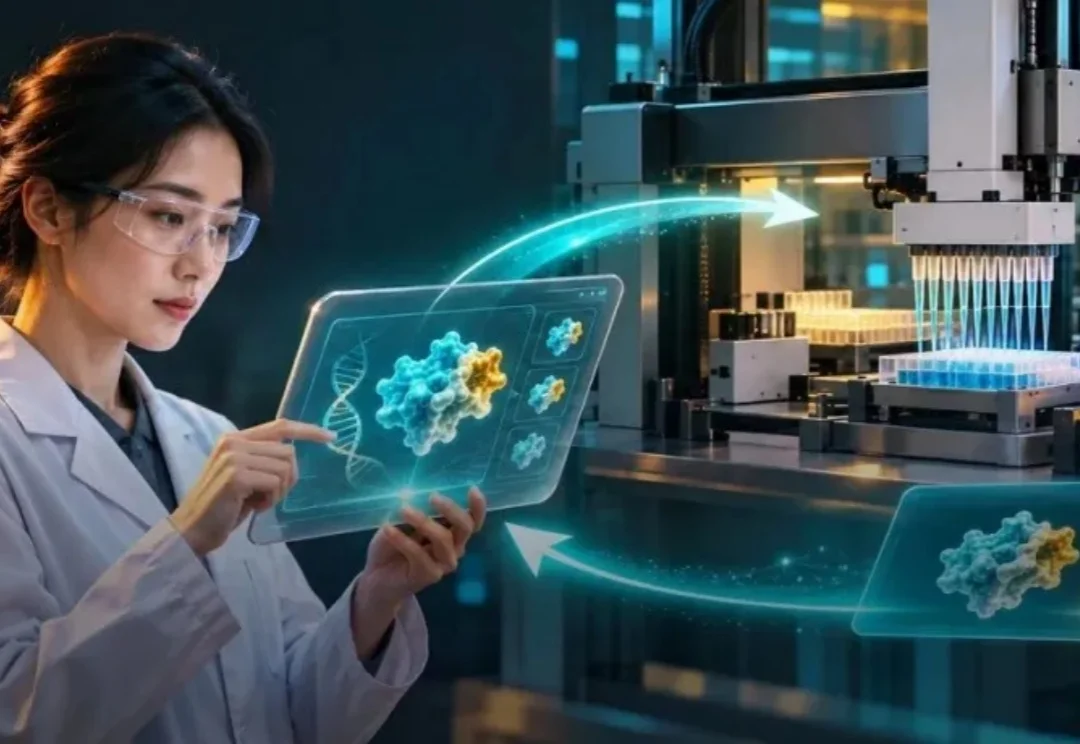
OpenAI、Anthropic接连出手!中国黑马把实验室变成AI「进化训练场」
OpenAI、Anthropic接连出手!中国黑马把实验室变成AI「进化训练场」今年2月,OpenAI干了件挺轰动的事: 把GPT-5接进Ginkgo Bioworks的云实验室。AI设计实验,机器人执行,结果回传,AI再设计下一轮。
来自主题: AI资讯
6292 点击 2026-11-09 11:05

 搜索
今年2月,OpenAI干了件挺轰动的事: 把GPT-5接进Ginkgo Bioworks的云实验室。AI设计实验,机器人执行,结果回传,AI再设计下一轮。
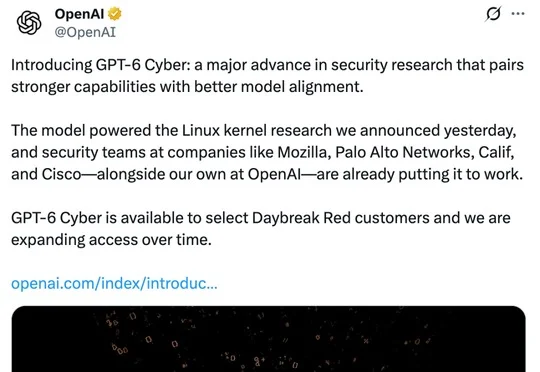
OpenAI推出主攻安全研究的GPT-6 Cyber,在ExploitGym得分48.5%超GPT-5.6 Cyber的32.1%,已发现81个Firefox新漏洞并为948个Linux漏洞开发利用程序,目前仅向Daybreak Red认证客户开放,OpenAI同时设立10亿美元一线防御者资助计划。
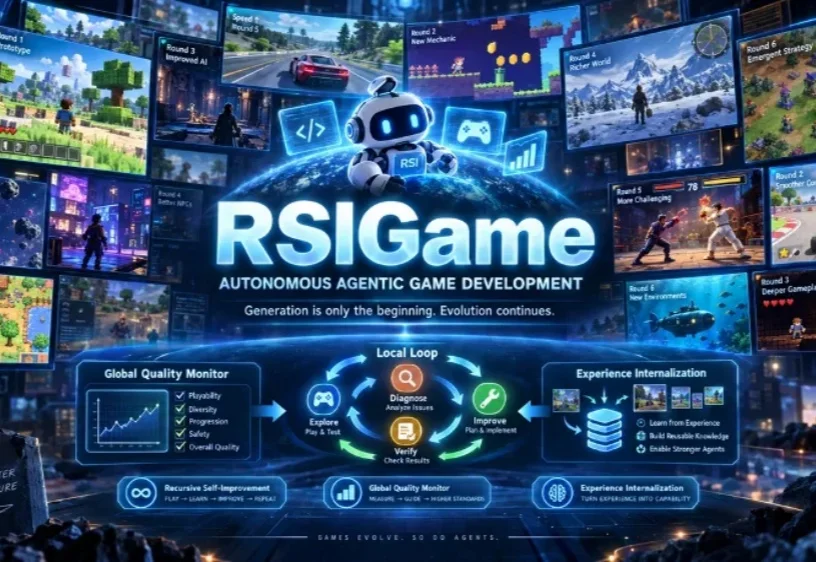
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
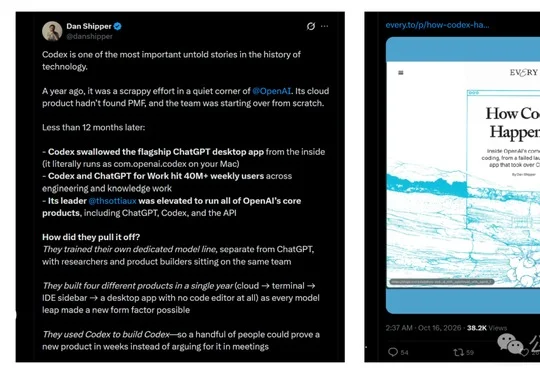
《How Codex Happened》首次披露Codex从首发遇冷、转向本地Agent并借GPT-5系列突围,最终成为ChatGPT桌面端底座,后续将重回云端并探索无固定界面的主动式Agent。
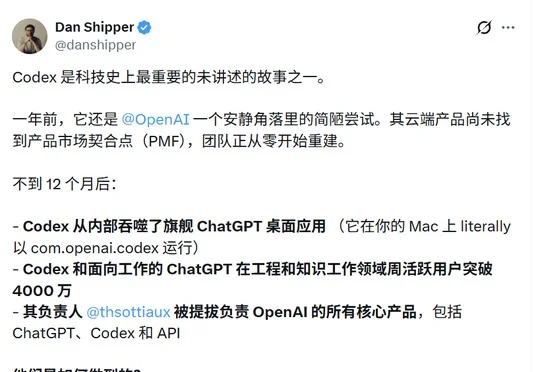
OpenAI的Codex在Tibo接手后从云端转向本地,并推出不含代码编辑器的桌面应用;随着GPT-5.3 Codex拓展至知识工作,Codex于2026年7月成为新版ChatGPT桌面应用,Codex与ChatGPT for Work合计周活超4000万。
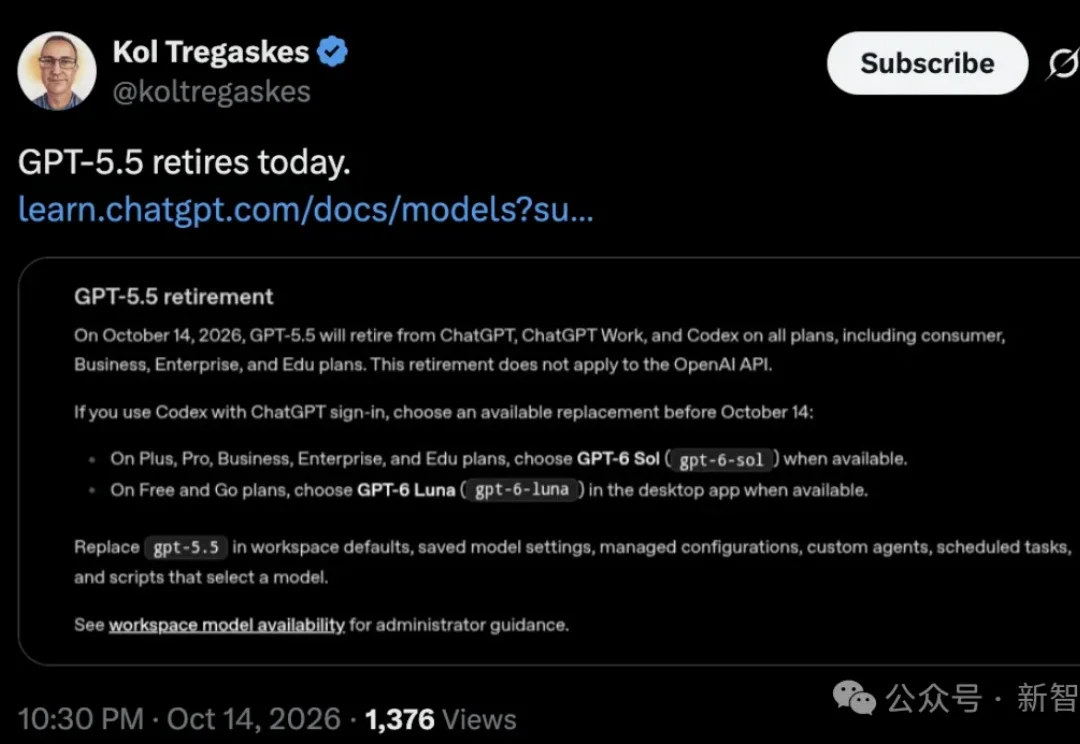
GPT-5.5,正式告别ChatGPT!
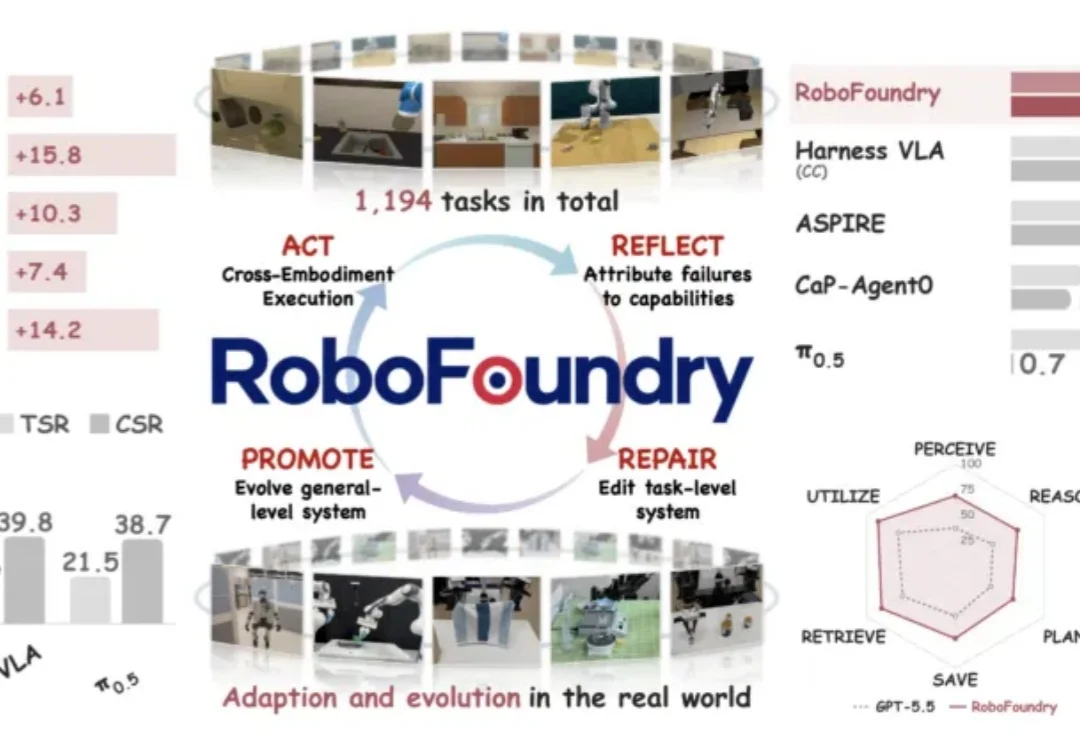
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
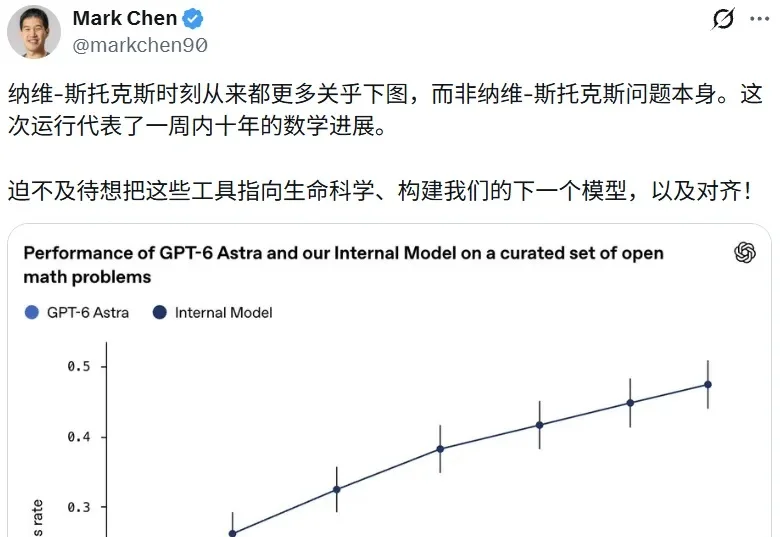
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
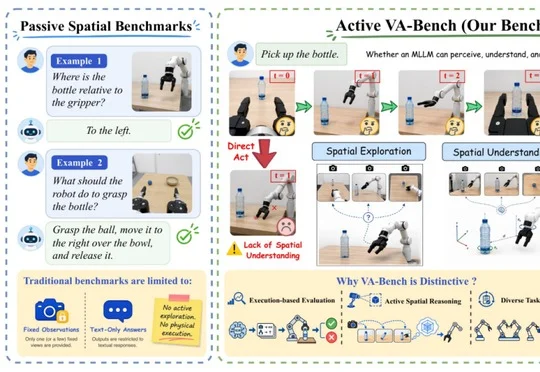
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
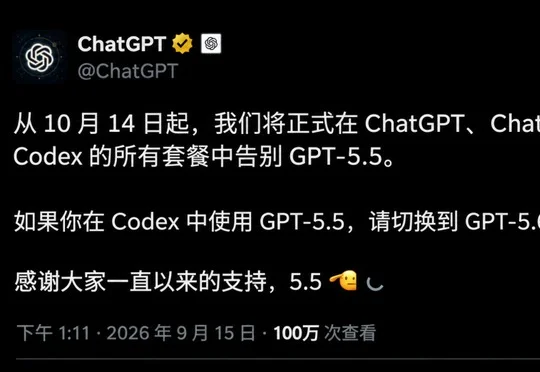
ChatGPT官宣:10月14日起,GPT-5.5将在ChatGPT、ChatGPT Work以及Codex全套餐中彻底下线。 没有缓冲期,没有退路,消费端、企业端、编程端一刀切。 取而代之的,是官方轻描淡写的指路: