250名三甲医生输给中国AI!引发中美医疗权威热议
250名三甲医生输给中国AI!引发中美医疗权威热议上个月,微软在《科学》杂志上甩出一篇论文:自家AI诊断系统诊断正确率83%,对照组的全科医生只有36%。
来自主题: AI资讯
8017 点击 2026-11-12 15:11

 搜索
上个月,微软在《科学》杂志上甩出一篇论文:自家AI诊断系统诊断正确率83%,对照组的全科医生只有36%。
继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
小时候想拥有一台 Game Boy,长大后想自己做一款 Game Boy 游戏,没想到 OpenAI 准备同时实现你这两个愿望。
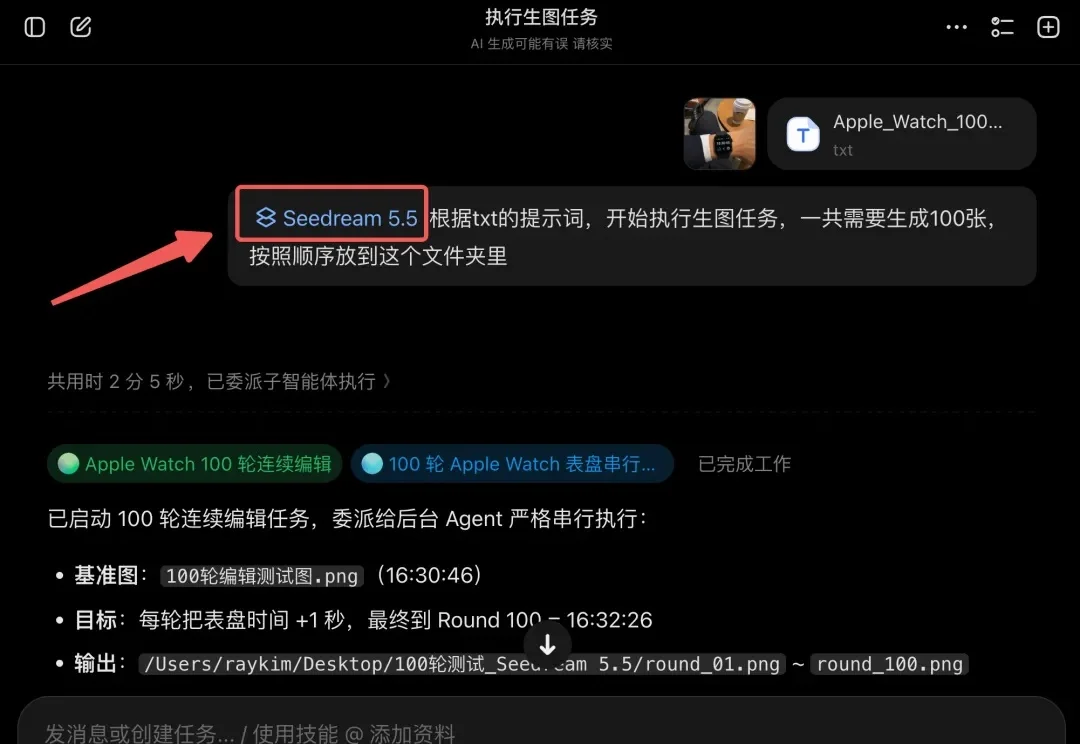
说真的,即便强如新出的GPT-Image 2.6,遇到连续编辑100轮图像这种高压任务,也得大喊那句“名人名言”: 我画地为牢啊,厉娜!
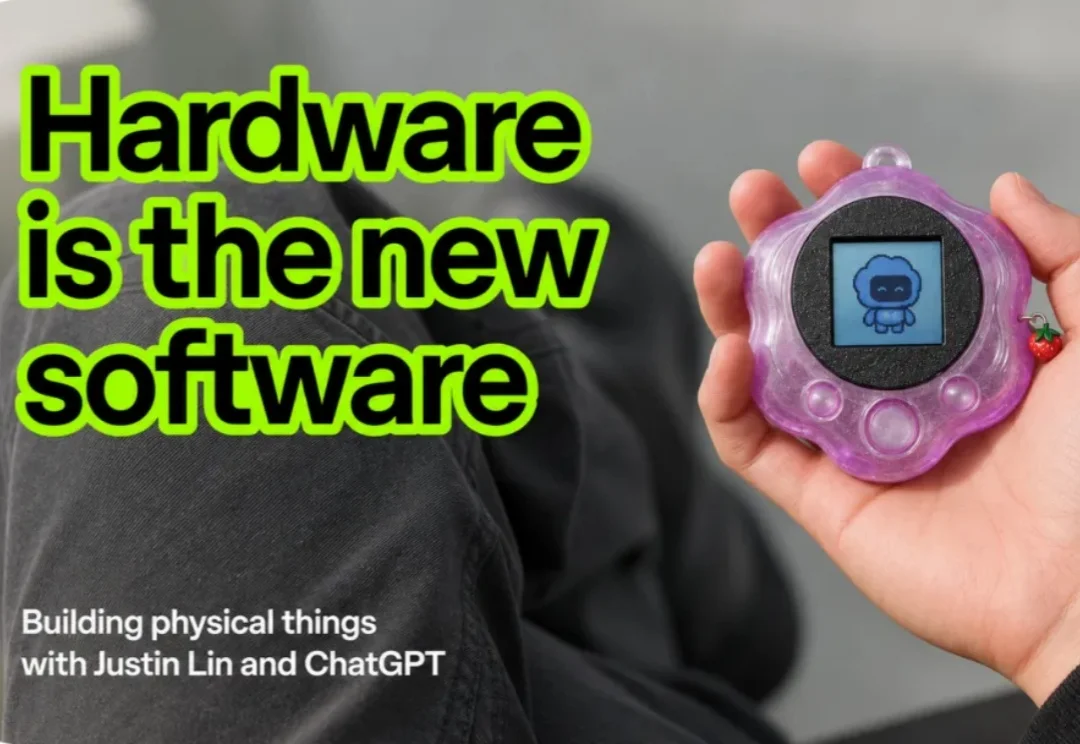
这是一台看起来像电子宠物的紫色设备,有屏幕、有实体按键,旁边还挂着一颗小草莓。用户可以拿起它,直接用语音和 Codex 对话。
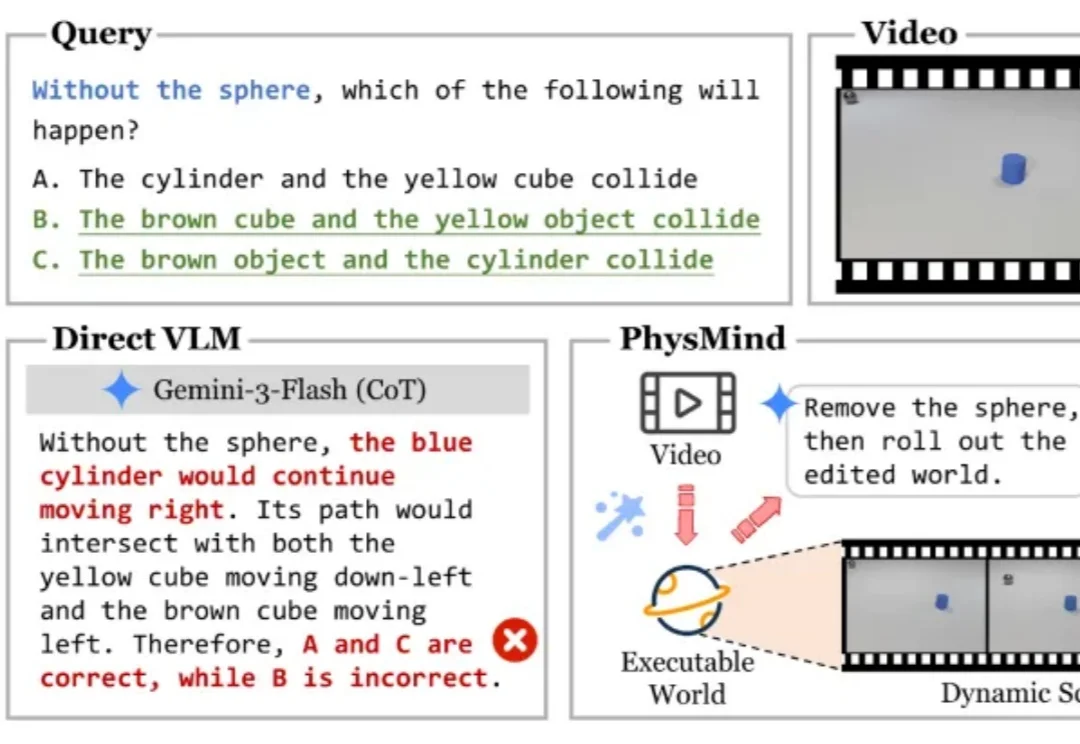
AI 能逼真地 “搭出” 一个世界,就能准确预测它如何运转吗?GPT-6 Astra 展现出的场景建模能力令人印象深刻。但几何与外观的逼真还原,并不意味着对物理规律的准确把握。避免物体穿模、借助语义先验估计物理属性,与准确推演物体运动之间,仍有距离。后者还需要进一步识别质量、摩擦系数和阻尼等难以仅凭外观确定的属性与参数。
上世纪 40 年代,计算机还是占据一整个房间的庞然大物。它们体积庞大、造价高昂,只有少数科研机构和大型组织能够使用。那时,计算是一种昂贵而稀缺的资源。
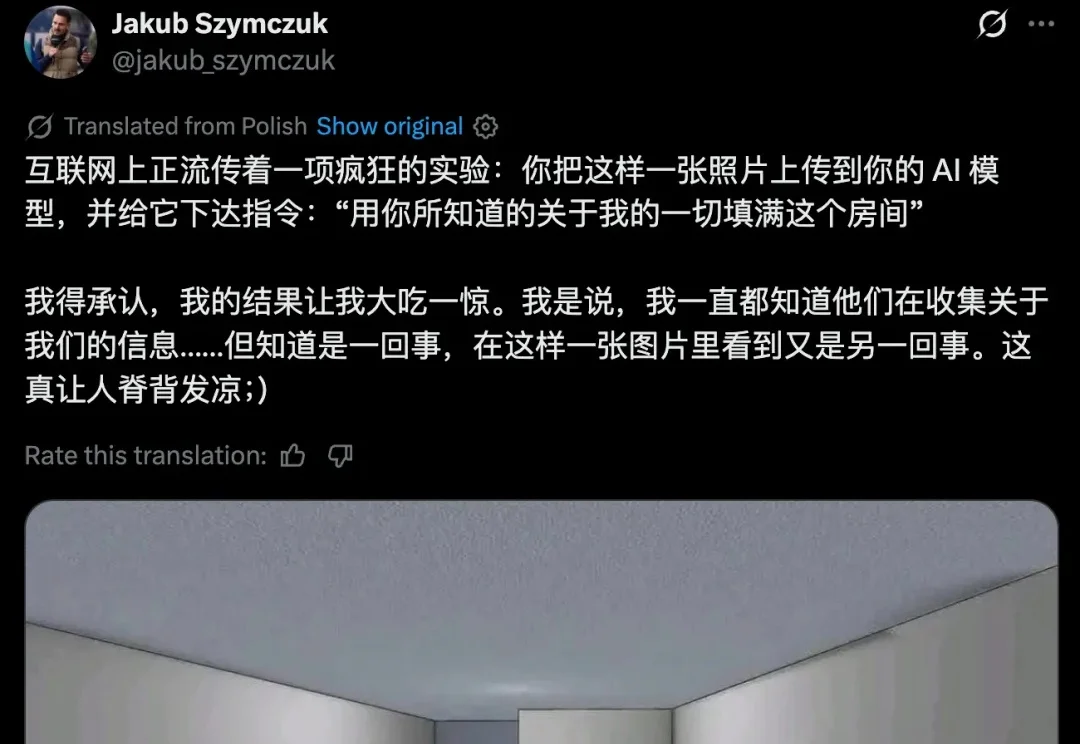
AI太懂你了,简直让人毛骨悚然!
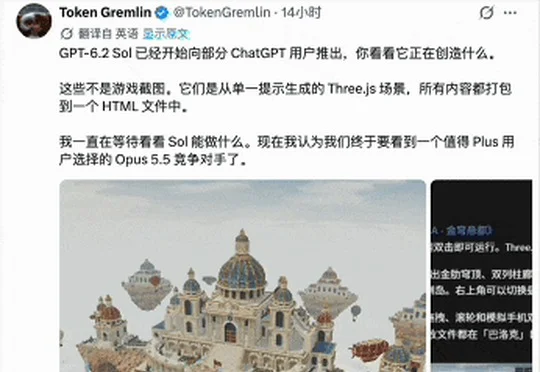
部分ChatGPT和Codex用户疑似被灰度到OpenAI尚未正式发布的GPT-6.2 Sol,实测显示其可完成复杂推理、编程及3D场景生成,并在一次对比中以约20分钟、9美元的表现优于Opus 5.5的1小时、20美元。
AI 圈等了一整天,OpenAI 期待已久的新模型还是没有出现。