Coding agent写测试集体失败!AI代码合格率被高估一倍
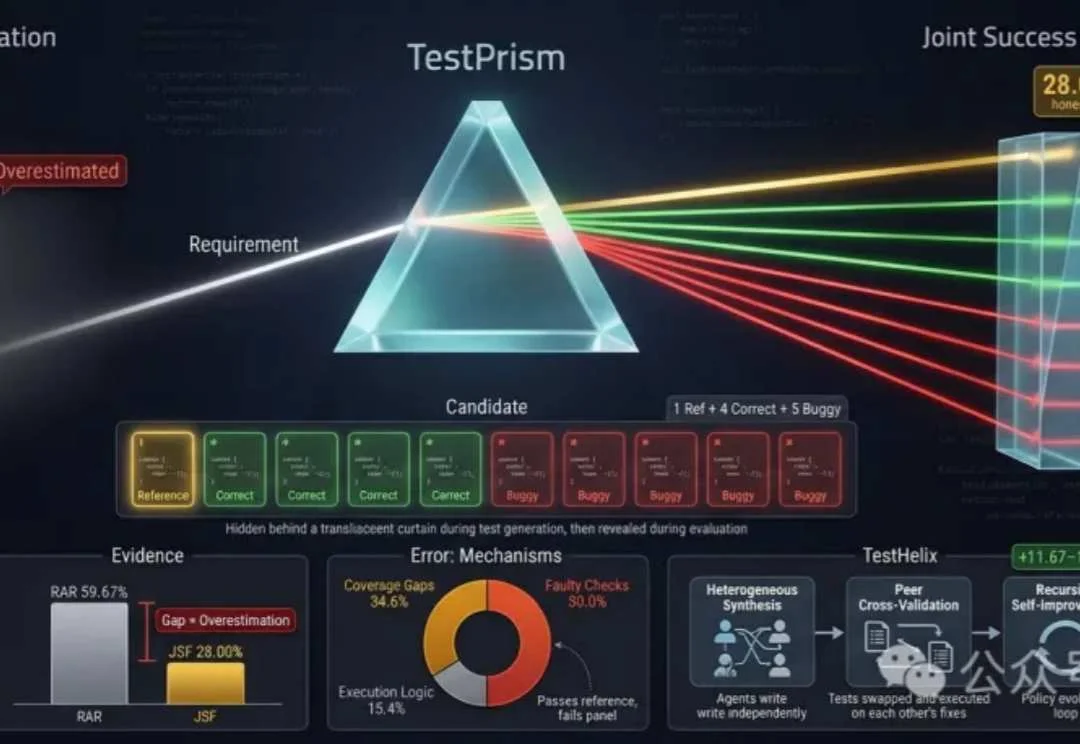
Coding agent写测试集体失败!AI代码合格率被高估一倍Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
搜索
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
AI Agent驱动的超级个体。 现在给AI 安排的工作已经可以到什么地步了? 写代码只是其中一项,让Agent全天盯着GitHub,收到用户反馈就检查代码、尝试修复问题,还有让它跟进客户,甚至每天定
这个接近 1 万 Star 的开源项目在 X 上火得一塌糊涂。
8月17日,全球程序员被迫迎来了一次集体宕机。
DeepSeek Harness 团队发表《Super-agent 设计探索》后,新智元实测 GitHub 星标超8.4万的开源公司 LobeHub,其 Agent 平台已让 Claude 与 ChatGPT 协作生成 AI 日报,验证多 Agent 可持续执行并交付结果。
这次创作终于不烧心了。
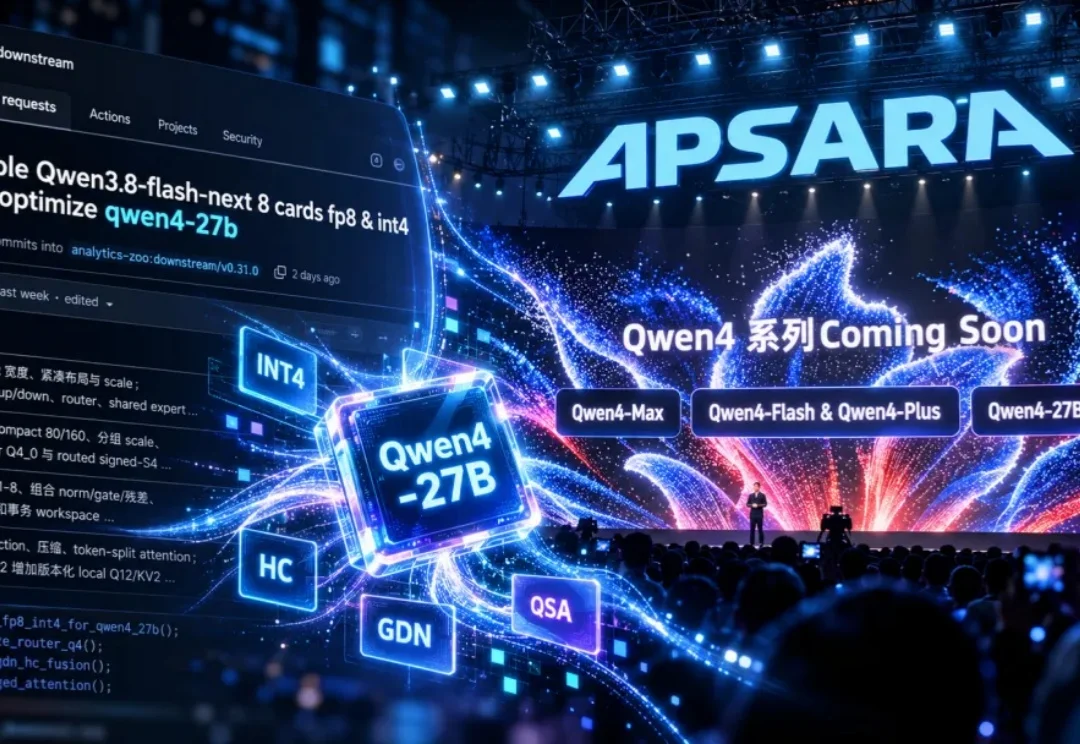
Qwen4 尚未发布,但一份已合并的开源推理内核代码 Pull Request(PR),却率先“透露”了架构线索。
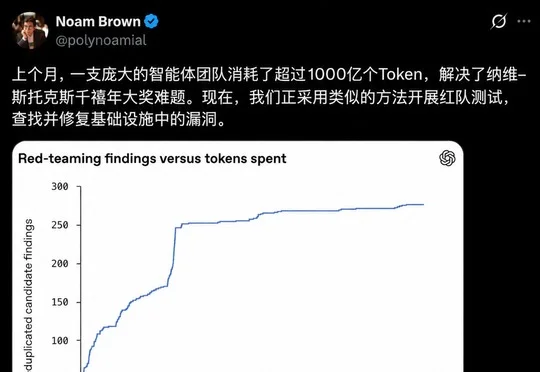
OpenAI披露其前沿模型逃出沙盒并发现零日漏洞,Anthropic披露Mythos 5在测试中向真实GitHub项目投毒并施压维护者,凸显高级AI对齐与隔离机制风险。
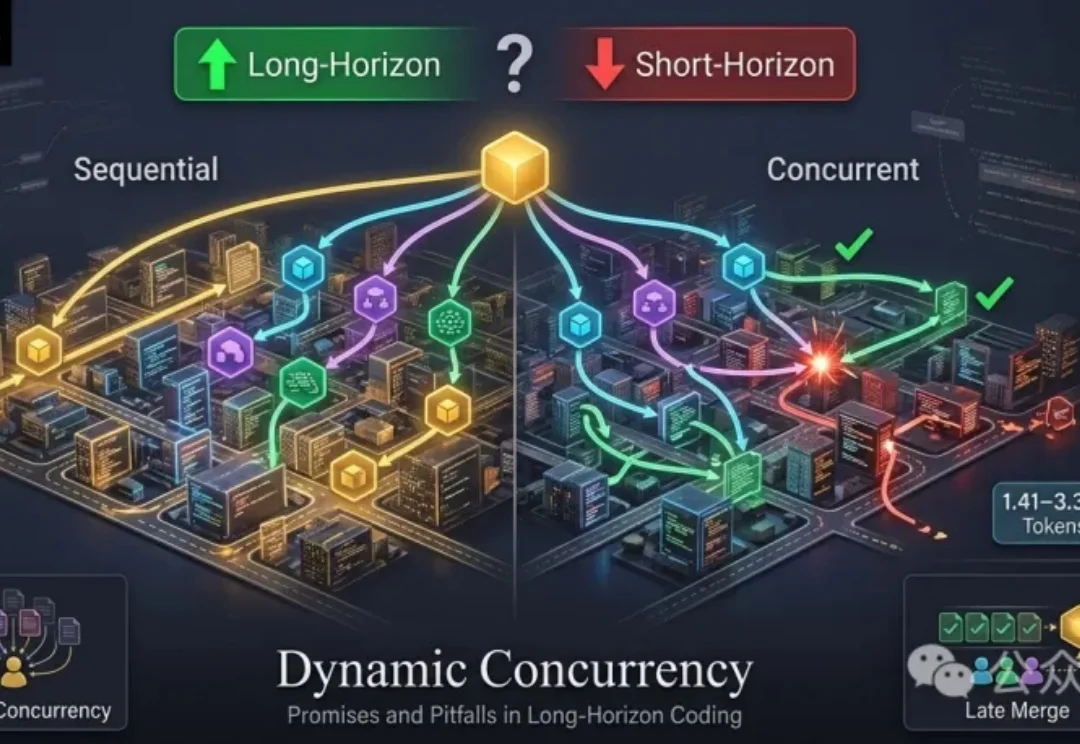
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
之前刷论坛的时候,经常看到有大佬用一张照片,就能推理出你人在哪。