NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」
NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
来自主题: AI技术研报
5351 点击 2026-11-11 10:27

 搜索
论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
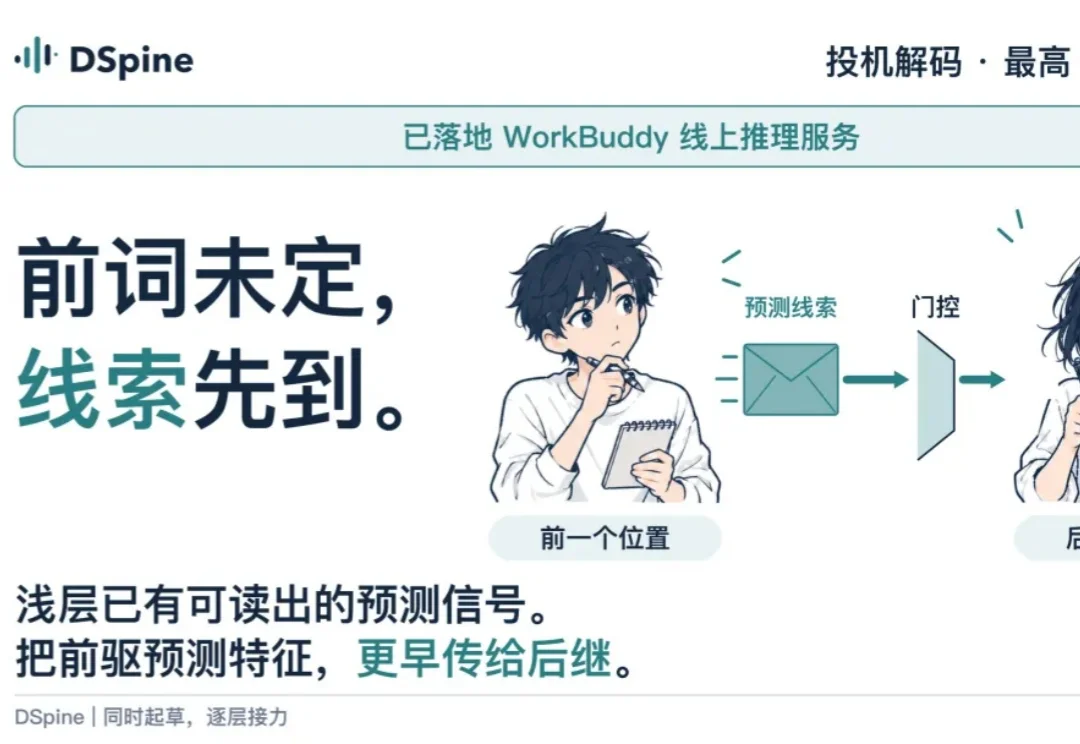
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
中国LLM讨论纪要认为,反蒸馏措施正令国产模型蒸馏成本上升5—10倍甚至20倍,算力与融资成为竞争核心,中美模型差距或由3—4个月拉长至约12个月。
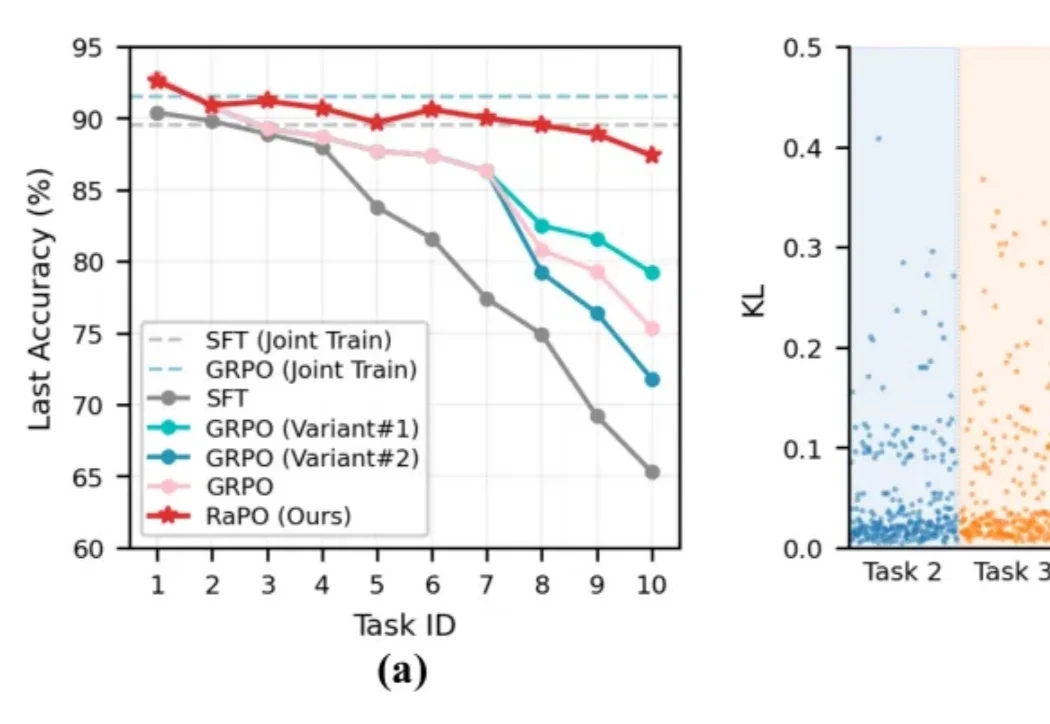
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
据Z Finance报道,周畅已离开字节Seed、转向Physical AI创业并获头部美元基金投资,但接近字节的人士否认离职;Seed将VLM并入LLM体系,折射出多模态统一路线调整。
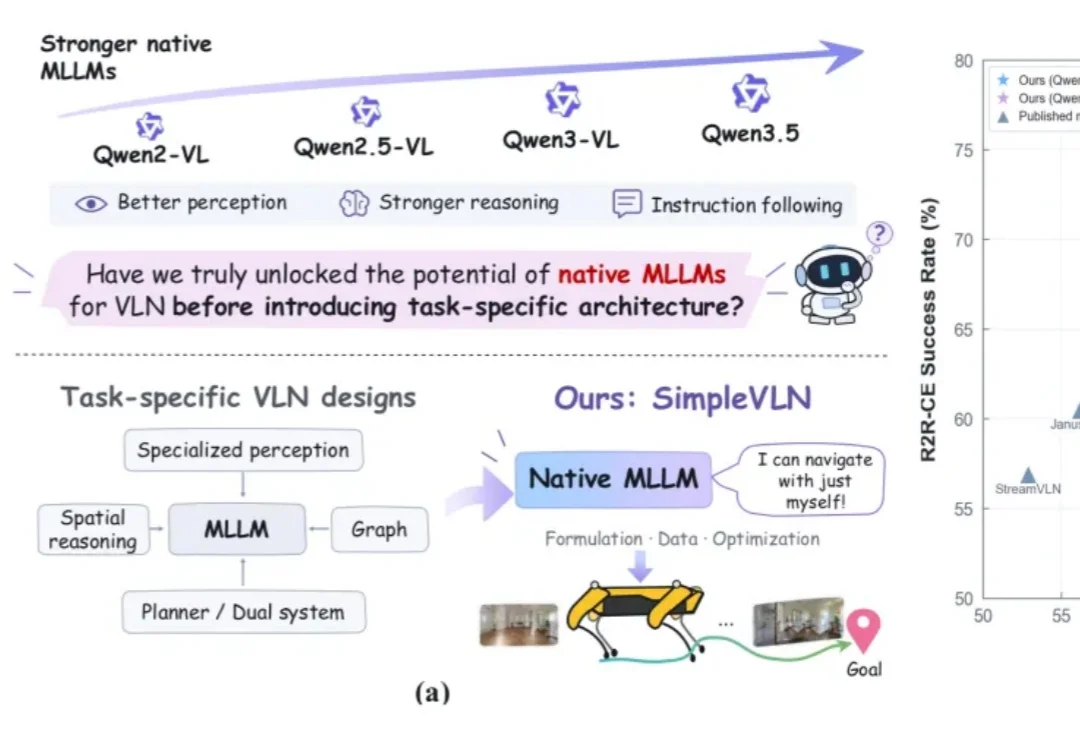
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
还得是「源神」D老师,善呐!
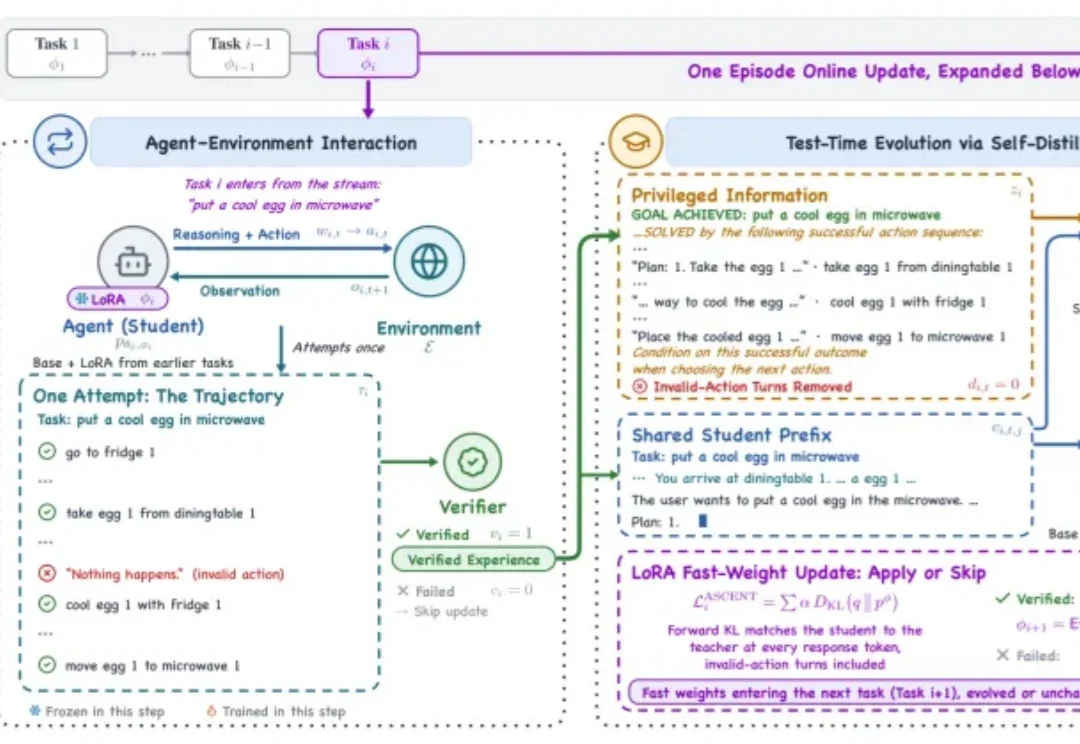
LLM智能体如何在部署过程中,通过自身执行持续进化?
GPT-6 Luna 要被扩散 LLM 抢饭碗了?
谷歌与Meta联合开源TorchTPU,使TPU成为PyTorch原生设备,并完成vLLM、SGLang、Hugging Face、Ray、TorchTitan等主流项目接入,CUDA的软件生态护城河开始松动。