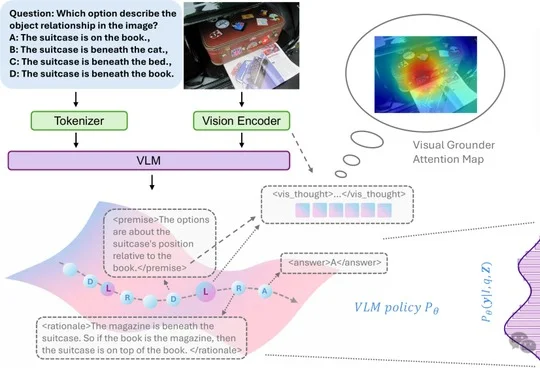
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
来自主题: AI技术研报
7827 点击 2026-09-28 16:22

 搜索
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
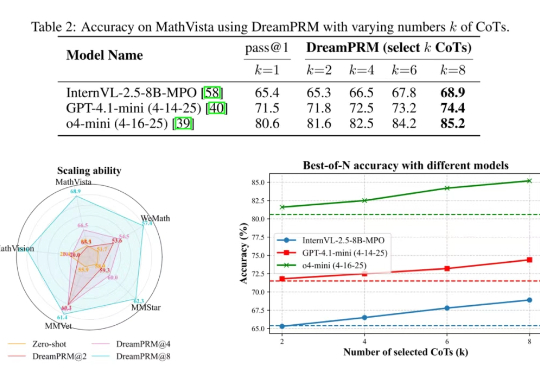
使用过程奖励模型(PRM)强化大语言模型的推理能力已在纯文本任务中取得显著成果,但将过程奖励模型扩展至多模态大语言模型(MLLMs)时,面临两大难题:

大型多模态模型会做数学题吗?在UCLA等机构最新发布的MathVista基准上,即使是当前最强的GPT-4V也会感到「挫败感」。