AI资讯新闻榜单内容搜索-Mu

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Mu
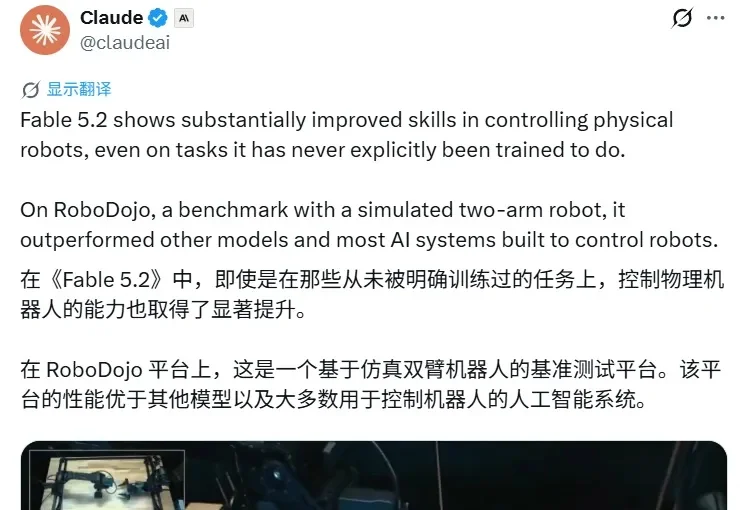
机器人版「苦涩的教训」来了?  Claude 5.2操作性能大涨,前Optimus研究员加盟

机器人版「苦涩的教训」来了? Claude 5.2操作性能大涨,前Optimus研究员加盟

机器人版「苦涩的教训」来了? Claude 5.2操作性能大涨,前Optimus研究员加盟

今天凌晨,Anthropic 一口气发布两款顶级模型 Claude Fable 5.2 和 Mythos 5.2。新模型在科学研究方面展示了多项成果,包括通过约 1000 个 AI 智能体协作,仅用 30 小时完成费马大定理证明的形式化。
来自主题: AI资讯
10307 点击    2026-11-11 14:44
为什么「陪伴」,注定是 Personal AI 的核心

为什么「陪伴」,注定是 Personal AI 的核心

为什么「陪伴」,注定是 Personal AI 的核心

Muse 的实时语音与拟人化形象降低了个人 AI 的交互门槛,并通过承接琐碎需求积累上下文,但研究显示过度使用语音 AI 可能加剧孤独感与情感依赖。
来自主题: AI资讯
9189 点击    2026-11-08 14:47
不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

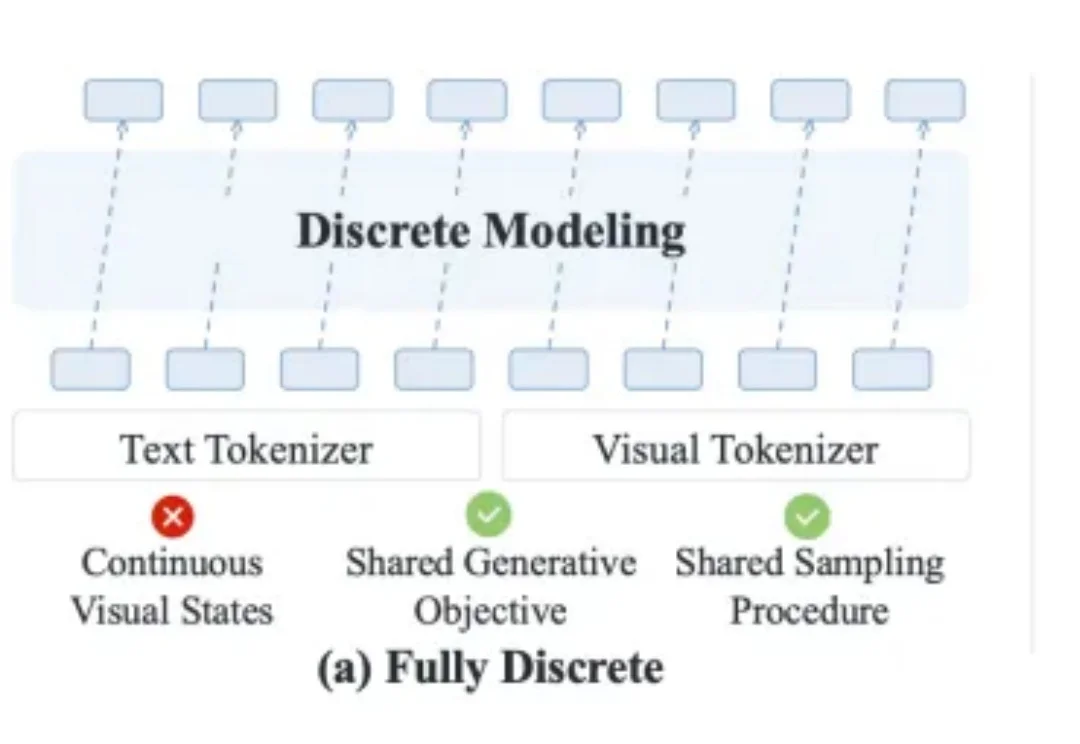
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
来自主题: AI技术研报
9535 点击    2026-11-06 10:29
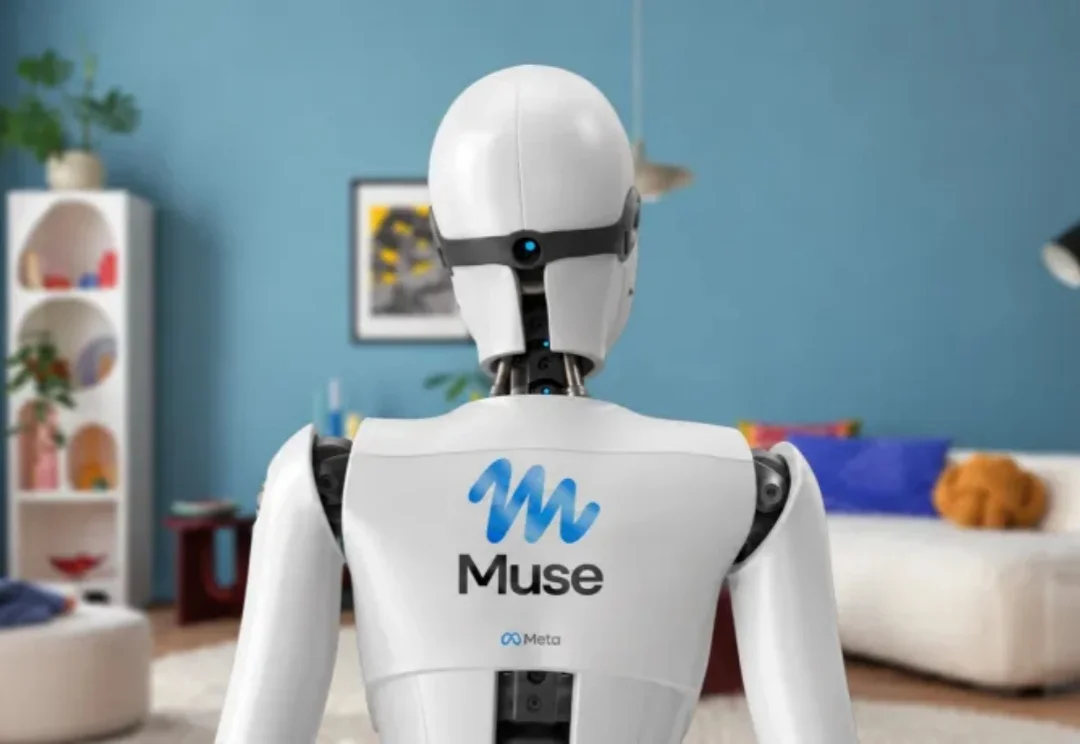
Muse人形机器人来了!小扎带队,中国造

Muse人形机器人来了!小扎带队,中国造

Muse人形机器人来了!小扎带队,中国造

Meta机器人业务产品副总裁曾来上海工作近两个月。

来自主题: AI资讯
6211 点击    2026-11-02 11:35
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
来自主题: AI技术研报
9392 点击    2026-11-02 10:33
连拿四个第一,力压Genie 4和Atlas!中国团队造出真物理世界模型

连拿四个第一,力压Genie 4和Atlas!中国团队造出真物理世界模型

连拿四个第一,力压Genie 4和Atlas!中国团队造出真物理世界模型

大晓机器人联合南洋理工大学S-Lab发布世界模型Mundo,通过照片重建可探索、可交互的物理环境,并支持多款机器人训练及酒店场景实测。
来自主题: AI资讯
10237 点击    2026-10-30 22:03
蚂蚁版Muse背后模型开源!Agent测评赶超DeepSeek-V4-Pro

蚂蚁版Muse背后模型开源!Agent测评赶超DeepSeek-V4-Pro

蚂蚁版Muse背后模型开源!Agent测评赶超DeepSeek-V4-Pro

5600亿总参数,主攻个人智能体与复杂工作流。

来自主题: AI技术研报
6993 点击    2026-10-30 10:55