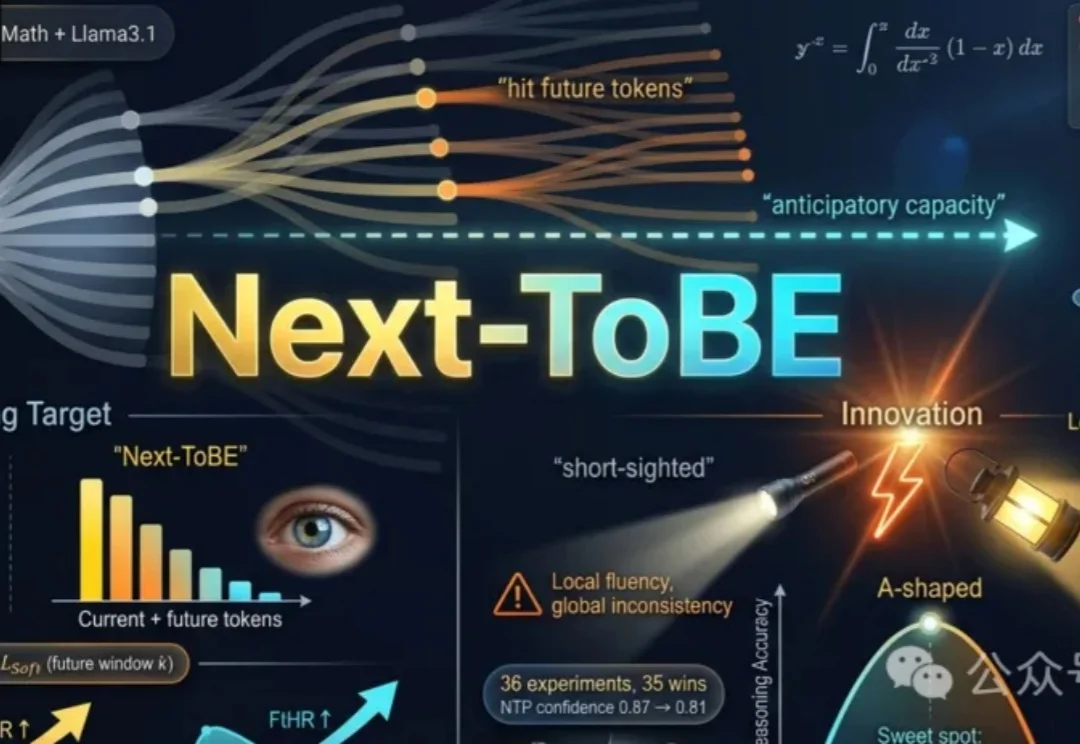
大模型自信且短视!Next-ToBE破除Next Token预测诅咒 | ICLR'26
大模型自信且短视!Next-ToBE破除Next Token预测诅咒 | ICLR'26大模型常因只关注当前预测而显得短视。Next-ToBE通过调整训练目标,让模型在每一步预测时兼顾未来token分布,从而提升整体推理能力。
来自主题: AI技术研报
7458 点击 2026-05-11 09:03

 搜索
大模型常因只关注当前预测而显得短视。Next-ToBE通过调整训练目标,让模型在每一步预测时兼顾未来token分布,从而提升整体推理能力。
今天,硅谷一篇长文《The next biggest moat in AI》刷屏了,作者是 Foundation Capital 合伙人、前麦肯锡咨询师 Jaya Gupta。这篇文章在 X 上 12 小时获得了130万阅读,被一群创始人和打工人同时转发,原因是它同时提供了两套视角:
AI内容创作工具迈入Next Level!
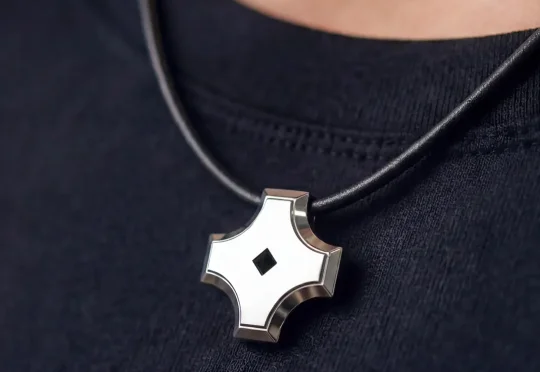
直到这一次我们在旧金山 DREAME NEXT 大会上深入了解了这款 AI 饮食吊坠(首发报道)后才发现,其实对于特定人群的特定场景,通过吊坠完成无感的记录分析,可以是一个很「刚」的需求。
在 AGI-Next 前沿峰会上,腾讯姚顺雨举了一个很生活化的例子:当你问 AI “今天吃什么” 时,真正限制答案质量的,可能不是模型不够大,也不是推理不够强,而是它不知道你今天冷不冷、想不想吃热的、最近和朋友聊过什么、家人又有什么偏好需要纳入考虑。
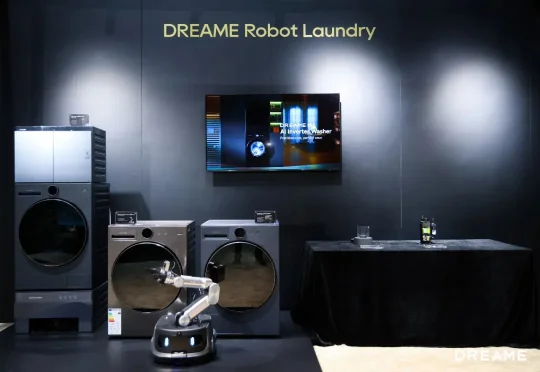
近期,追觅在硅谷举办了「DREAME NEXT」发布会,并把视线投向 2036:未来十年的硬件形态和生活方式,将如何随着 AI 发生变化。在这个宏大命题下,这场发布会也给外界提供了一个观察切片:追觅将如何在 AI 时代重新定义自己。
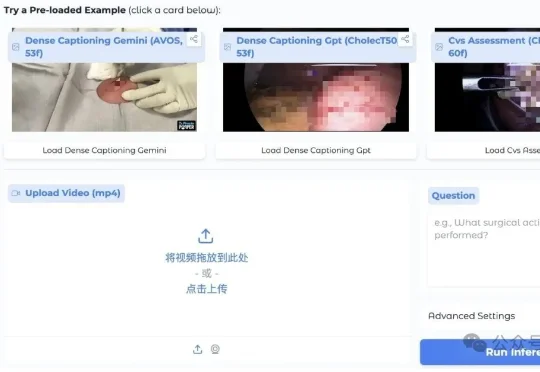
就在这两天,GitHub和Hugging Face社区上线了一枚医疗大模型领域的“核弹”。全球规模最大、性能最强的医疗视频理解大模型——uAI Nexus MedVLM(中文名:元智医疗视频理解大模型)开源!
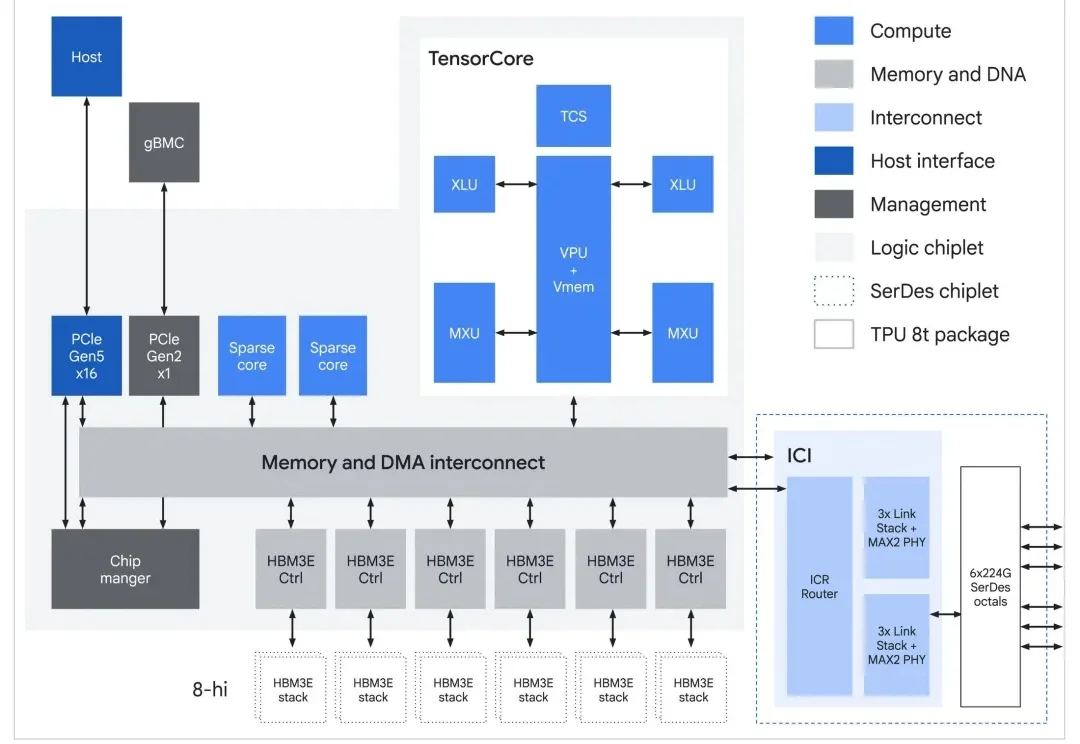
今天,谷歌在 Cloud Next '26 峰会上发布了其第八代 TPU 架构(TPU 8t 与 TPU 8i),TPU 8t 主攻训练,TPU 8i 主攻推理,将在 2026 年晚些时候上市。第八代 TPU 采用申请制,Google Cloud 用户如需使用,需要在官网提交登记需求。
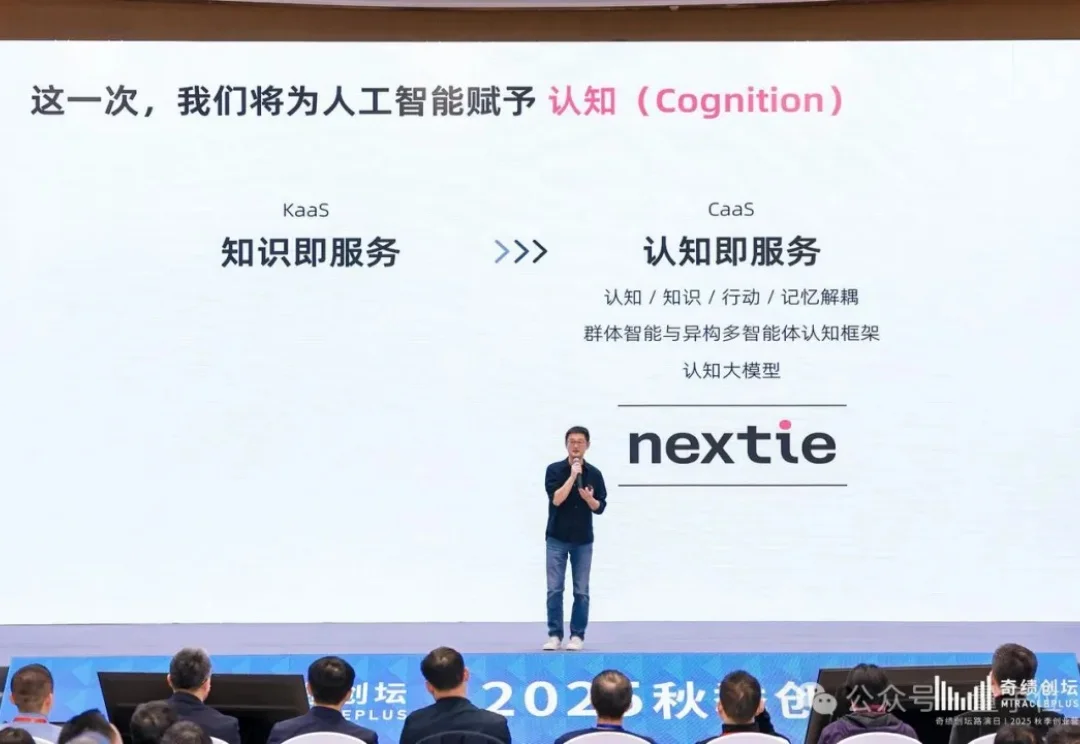
多智能体赛道爆发,Harness成为破局关键,资本加速布局。
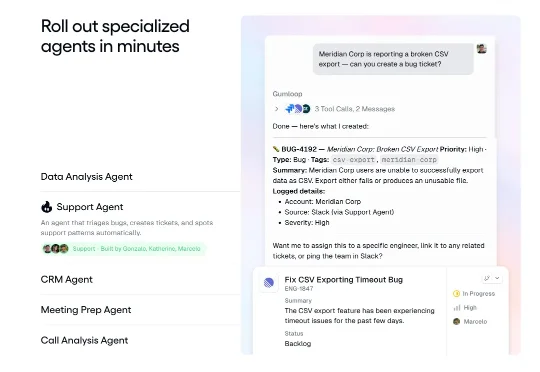
Gumloop 刚刚宣布完成 5000 万美元的 B 轮融资,由 Benchmark 领投,Nexus VP、First Round Capital、Y Combinator、Box Group、The Cannon Project 和 Shopify Ventures 参与跟投。