想入局VLA却不知从何下手?NTU&中大开源「终极菜谱」:从基座到频域建模,每一步都有实验支撑
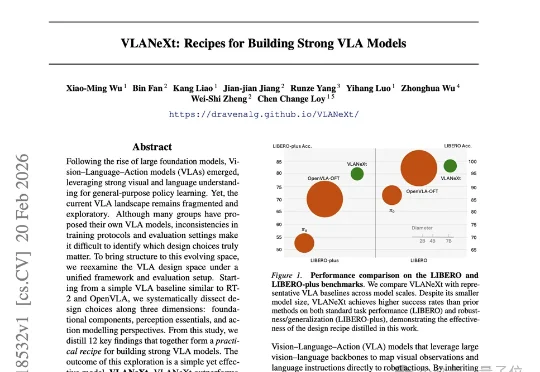
想入局VLA却不知从何下手?NTU&中大开源「终极菜谱」:从基座到频域建模,每一步都有实验支撑MMLab@NTU联合中山大学的最新研究,给出了一份从入门到精通的终极“菜谱”——VLANeXt。这项研究没有简单提出一个新模型了事,而是系统性地从12个关键维度,深度剖析了VLA的设计空间。从基础组件到感知要素,再到动作建模的额外视角,每一步都有扎实的实验支撑。
搜索
MMLab@NTU联合中山大学的最新研究,给出了一份从入门到精通的终极“菜谱”——VLANeXt。这项研究没有简单提出一个新模型了事,而是系统性地从12个关键维度,深度剖析了VLA的设计空间。从基础组件到感知要素,再到动作建模的额外视角,每一步都有扎实的实验支撑。
这家成立两年的初创公司周四表示,已完成900 万美元种子轮融资,由 Susquehanna International Group(SIG)和光速创投领投,B Capital、Seaborne Capital、Beenext、Sparrow Capital 和 2.2 Capital 跟投。
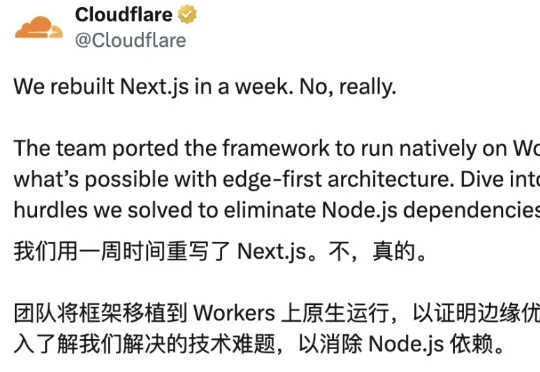
今天,Web 开发社区爆发了一条令人咋舌的技术新闻。Cloudflare 的一名工程师在一周之内,借助 AI 模型从头重建了 Next.js 。该公司的首席技术官 Dane Knecht 发推庆祝这一史诗级的成就,称之为「Next.js 的解放日」,Next.js 属于每个人。
在经济学和博弈论的世界里,找到「纳什均衡」往往意味着找到了复杂局势下的最优解。多所顶尖高校的研究人员开发出了一位名为PrimeNash的「AI数学家」,不仅能像人类专家一样推导公式,还能解决许多连传统算法都束手无策的复杂博弈难题,成果已发表在Cell Press旗下的交叉学科期刊Nexus上。
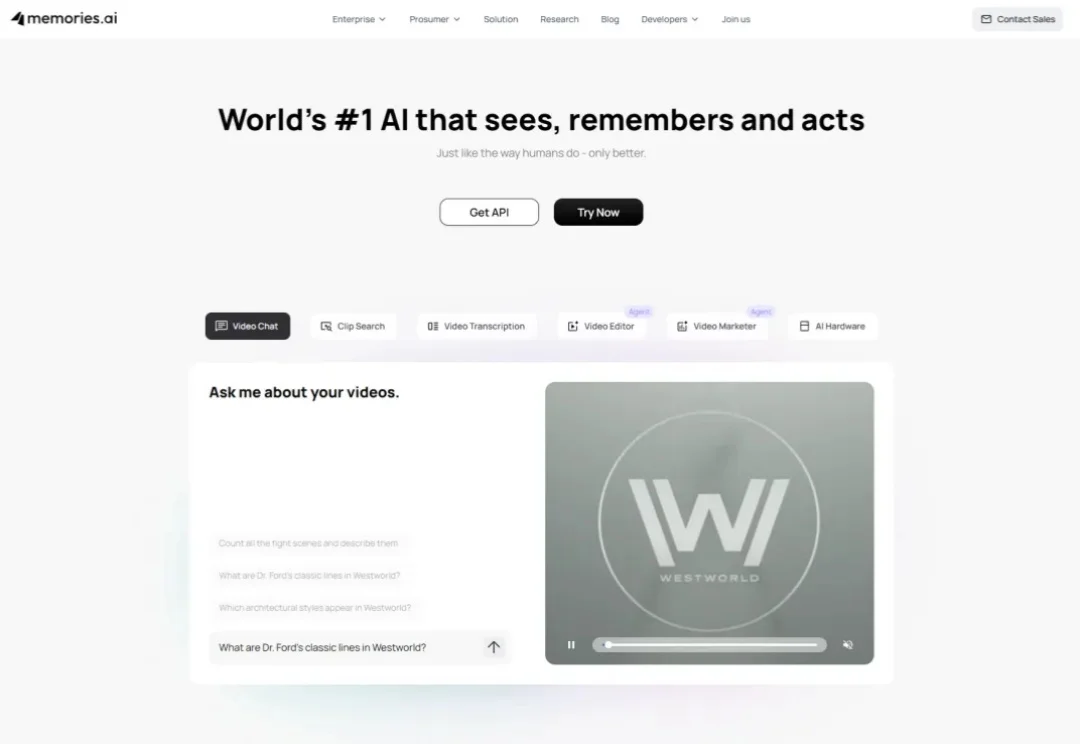
过去几年,AI 行业几乎把所有注意力都投向了“会不会想”:更强的推理、更大的模型、更快的生成。但在真实世界里,很多问题并不是想不想得出来,而是你到底记不记得发生过什么——尤其是视频。
大规模表格模型(LTM)而非大规模语言模型(LLM)的 Fundamental 公司 Nexus 模型,在多个重要方面突破了当代人工智能实践。该模型具有确定性——即每次被询问相同问题时都会给出相同答案——且不依赖定义当代大多数人工智能实验室模型的 Transformer 架构 。
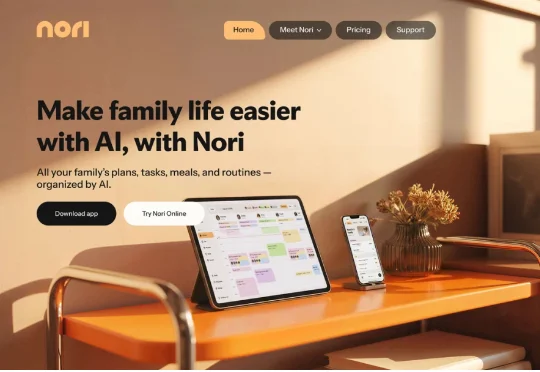
最近,一家名为 Domus Next 的 AI 公司,在美国科技圈内引起了业界的广泛关注。它的产品 Nori,在 2026 年 1 月正式发布前,仅通过为期一个月的私密内测,就悄然渗透进了超过 10 万个家庭,发布当天在 App 生产力排行榜一度超过了 Google Calendar 和 Google Keep,还超过了 Perplexity、Manus 等一众 AI 产品。
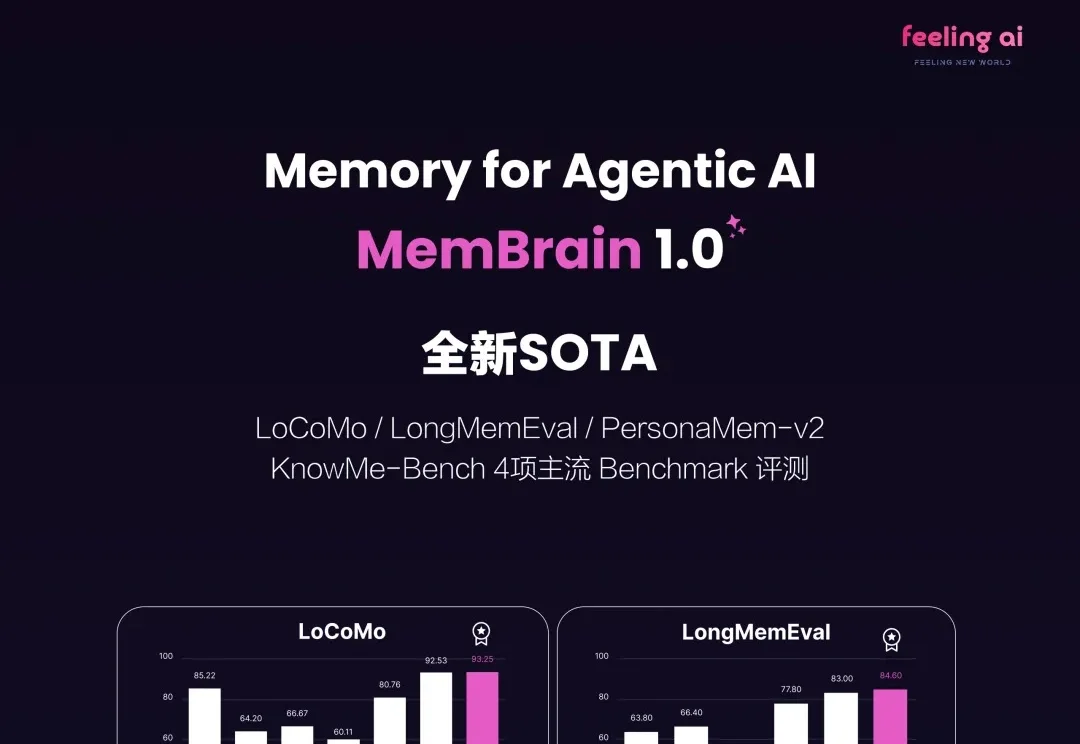
2026 刚来到 2 月,无论是底层模型大厂还是初创公司统统加速开卷,其中 Agentic Memory 方向的快速进化更是把大模型的能力上限推向了 NEXT LEVEL!
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
不久前在 AGI-Next 前沿峰会上,姚顺雨曾分享过一个核心观点:模型想要迈向高价值应用,核心瓶颈就在于能否「用好上下文(Context)」。