ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式
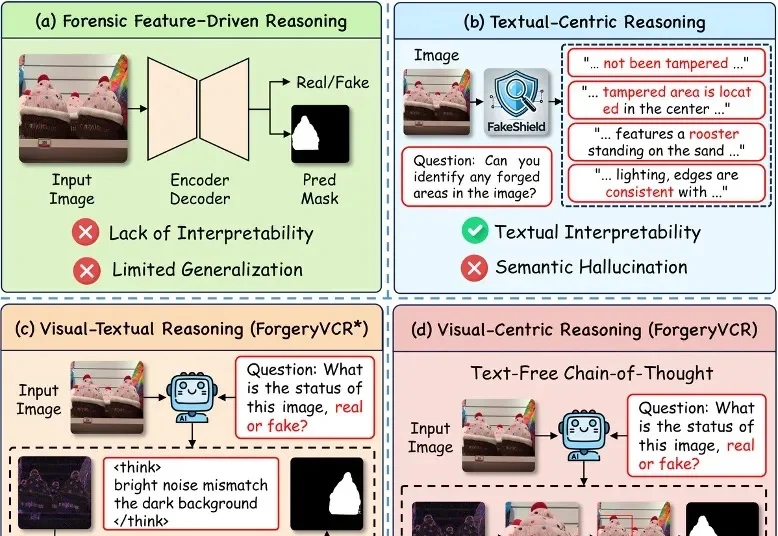
ACM Multimedia 2026 Oral|从「转述痕迹」到「看见证据」:ForgeryVCR用视觉中心推理重塑图像取证范式随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
搜索
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
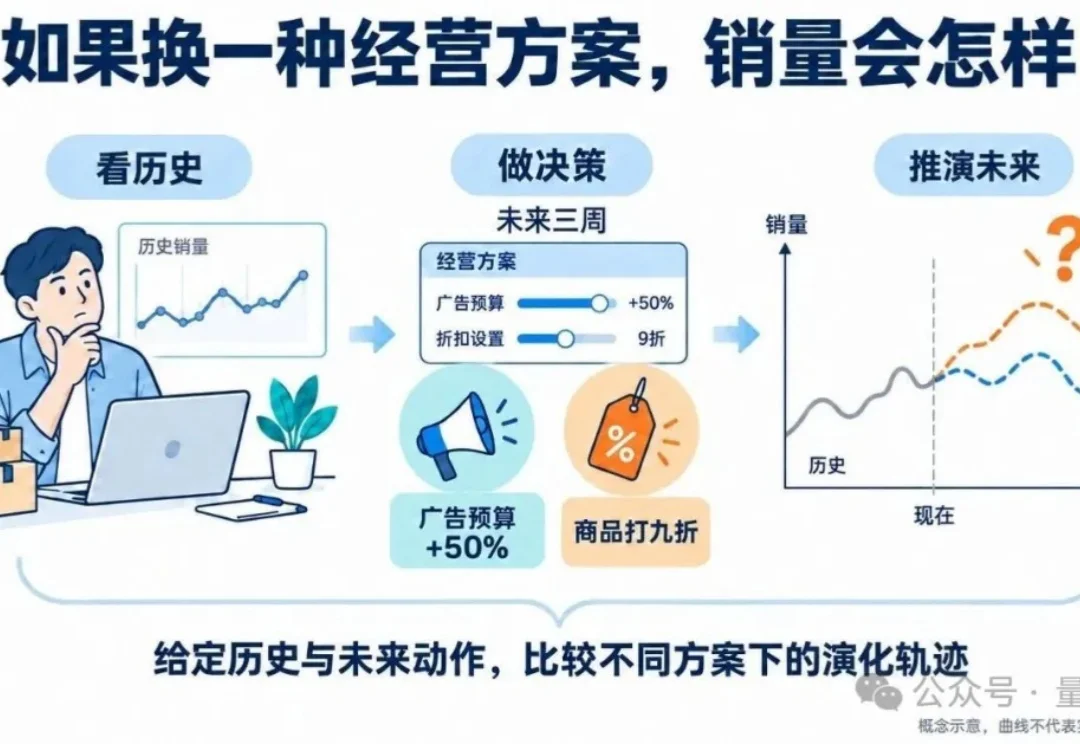
真实世界的时间序列,不仅被外部事件冲击,也被人为决策持续重塑。
蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
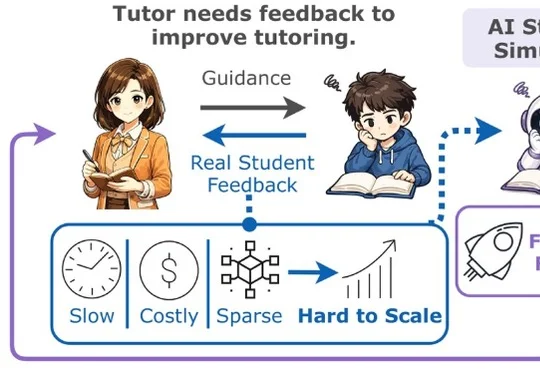
微软与UIUC合作研究StudentSim框架,基于真实学生数据训练个性化学生模拟器,具备behavioral fidelity和guidance responsiveness两项能力,在国际象棋等三个领域验证其优于现有基线,并可作为AI教师强化学习的高通量奖励信号。
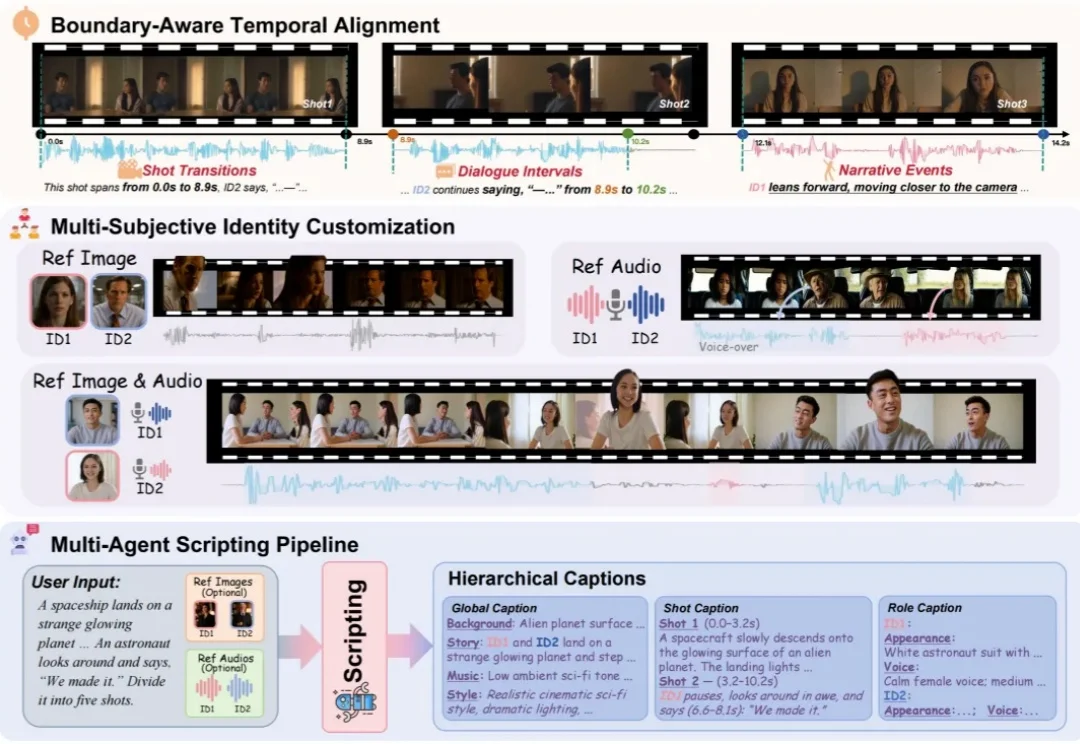
过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
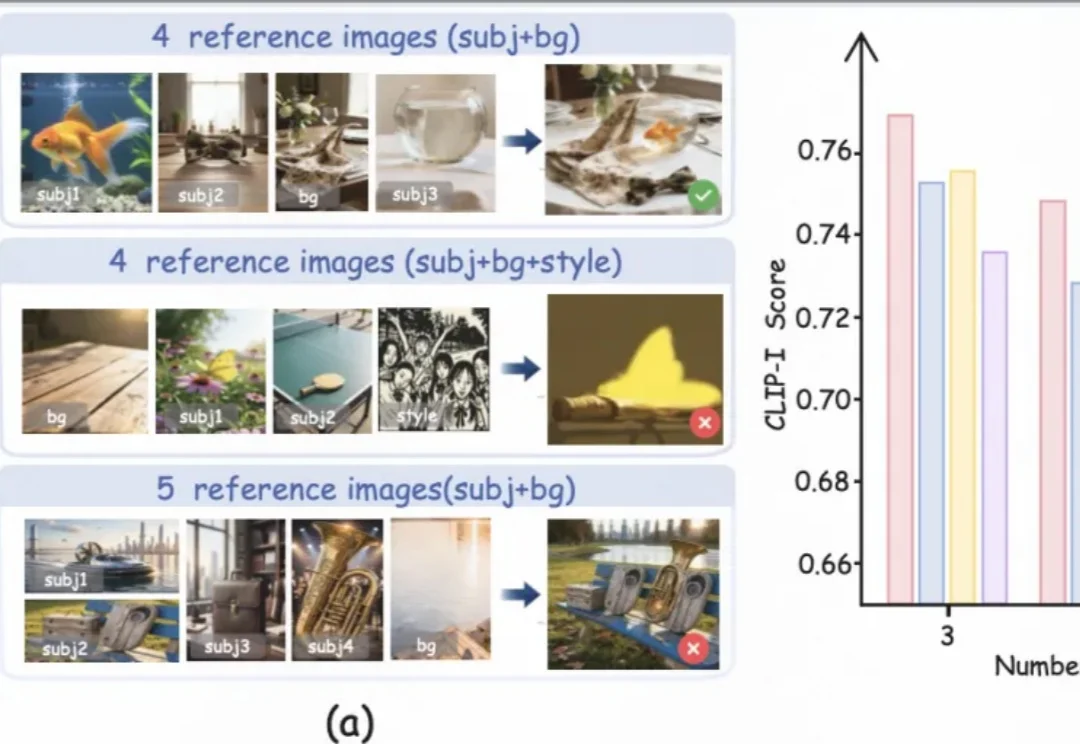
给图像生成模型一张人物参考图,它大概率能抓住身份特征。
昨天看到了一篇论文,特别有意思,让我连夜读完了。
3D空间数据的瓶颈,从来不是算法,而是标注。
近年来,大语言模型展现出了越来越强的能力,从上下文学习(In-Context Learning, ICL)到复杂推理、代码生成,这些能力不断刷新人们对模型能力边界的认知。
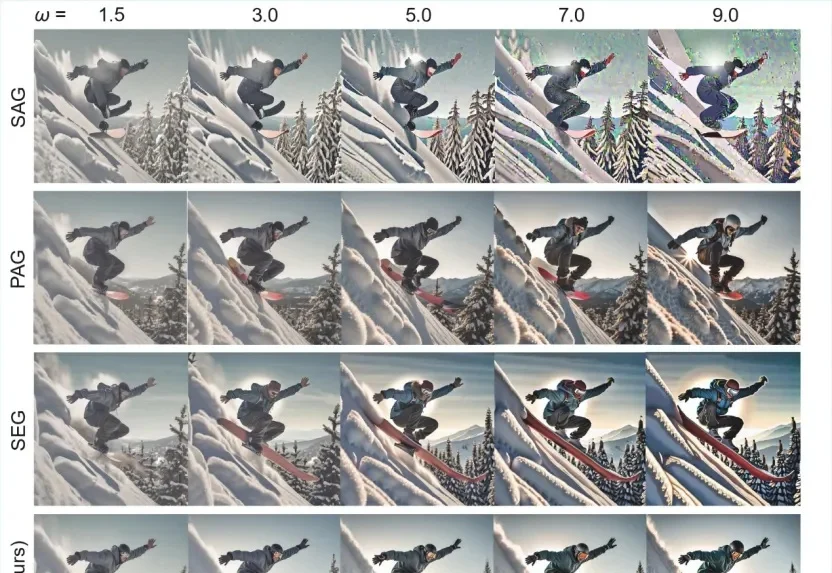
扩散模型又被玩出新花样了。