AI资讯新闻榜单内容搜索-Post-Train

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Post-Train
CoRL 2026 | 0条带力数据预训练!上海交大卢策吾、汶川团队让VLA学会力

CoRL 2026 | 0条带力数据预训练!上海交大卢策吾、汶川团队让VLA学会力

CoRL 2026 | 0条带力数据预训练!上海交大卢策吾、汶川团队让VLA学会力

上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。

来自主题: AI技术研报
6674 点击    2026-09-28 16:20
被开除的Thinking Machines CTO,又离开OpenAI回谷歌了

被开除的Thinking Machines CTO,又离开OpenAI回谷歌了

被开除的Thinking Machines CTO,又离开OpenAI回谷歌了

几个小时前,Barret Zoph 在 𝕏 上发了一条推文,他说自己将加入谷歌 DeepMind,而他的 AI 生涯正是从谷歌 Brain 的 Residency 项目起步的,这次算是重返旧地;他将专注于强化学习(RL)与后训练(Post-Training)方向,更多消息稍后公布;他还补了一句,谷歌拥有在 AI 领域持续成功所需要的全部要素,他很高兴能成为这个使命的一部分。

来自主题: AI资讯
9652 点击    2026-08-27 20:15
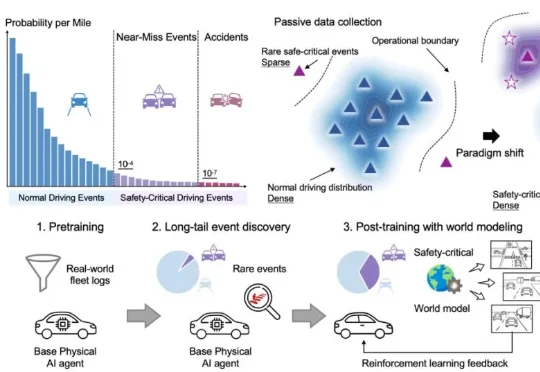
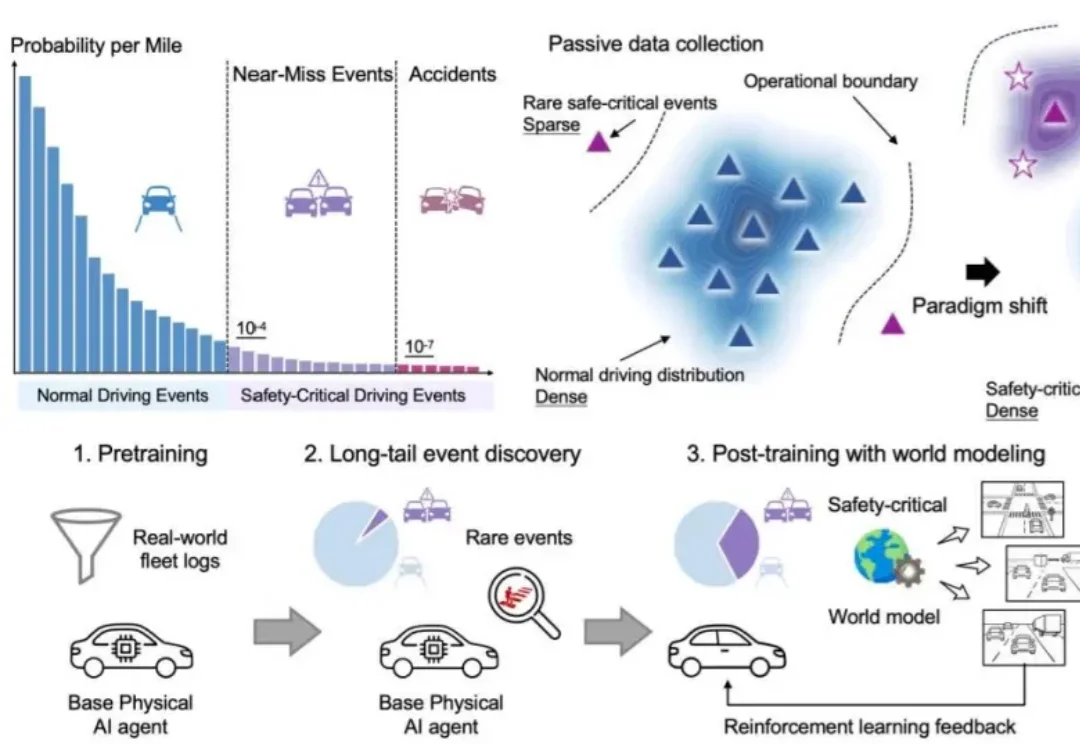
碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。

来自主题: AI技术研报
8914 点击    2026-06-20 10:24
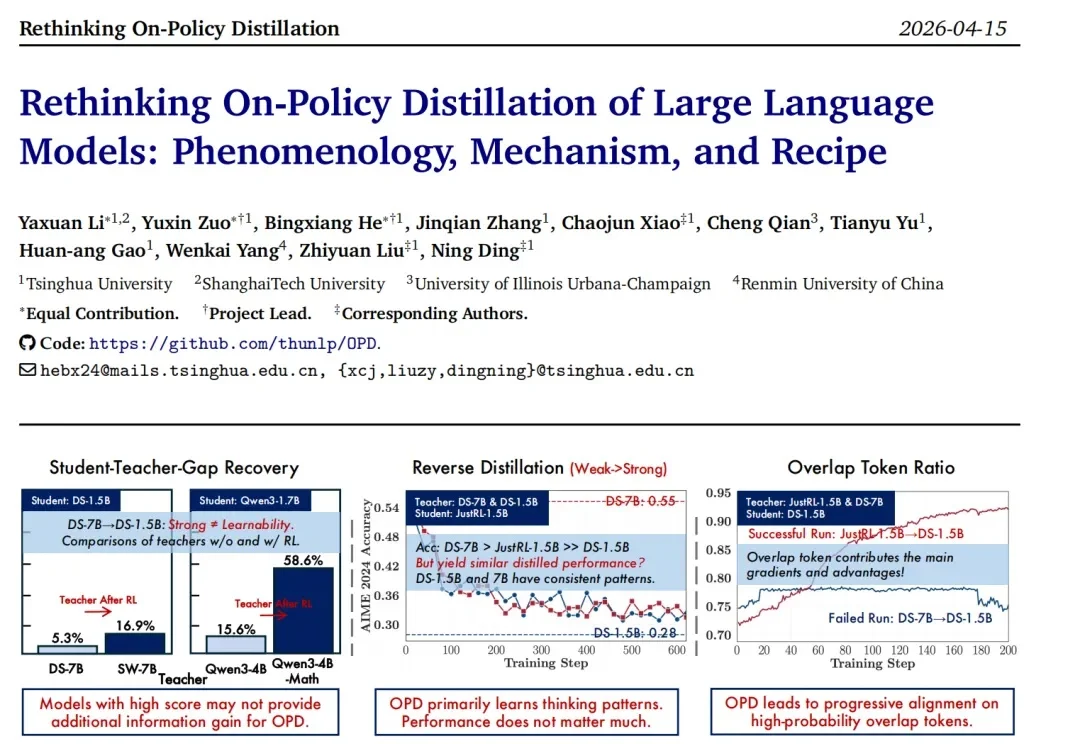
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」

当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。

来自主题: AI技术研报
11268 点击    2026-05-14 09:59
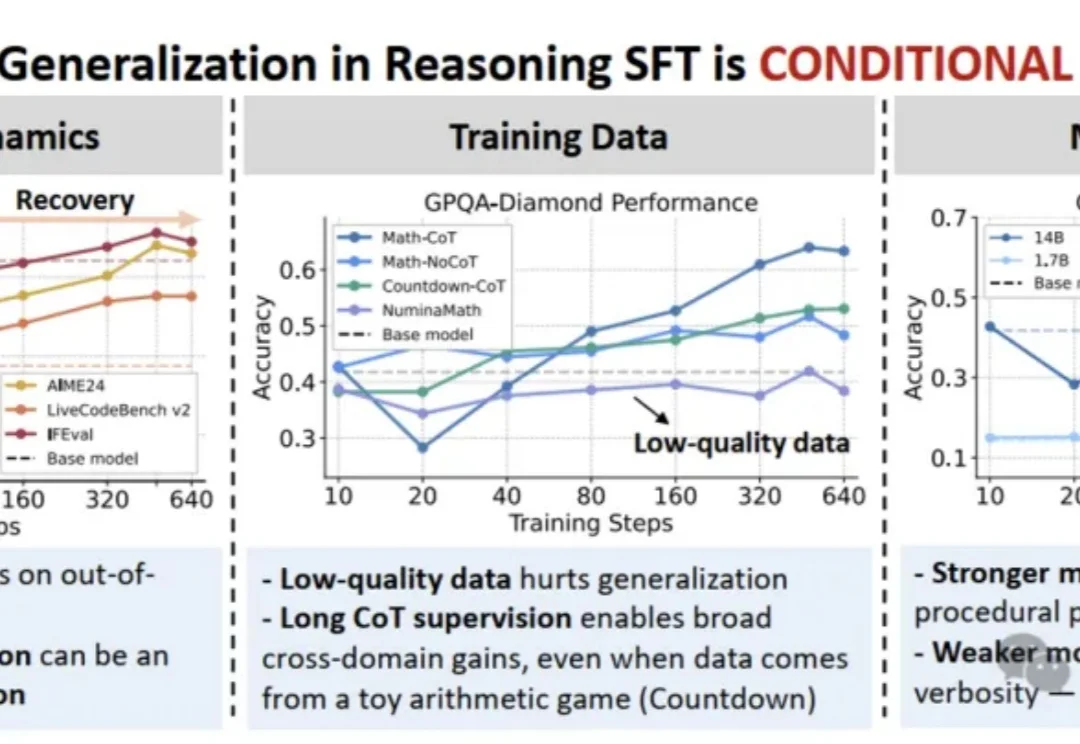
上海AI Lab新研究:SFT能泛化,只要满足这三个条件

上海AI Lab新研究:SFT能泛化,只要满足这三个条件

上海AI Lab新研究:SFT能泛化,只要满足这三个条件

随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。

来自主题: AI技术研报
10021 点击    2026-05-13 09:59
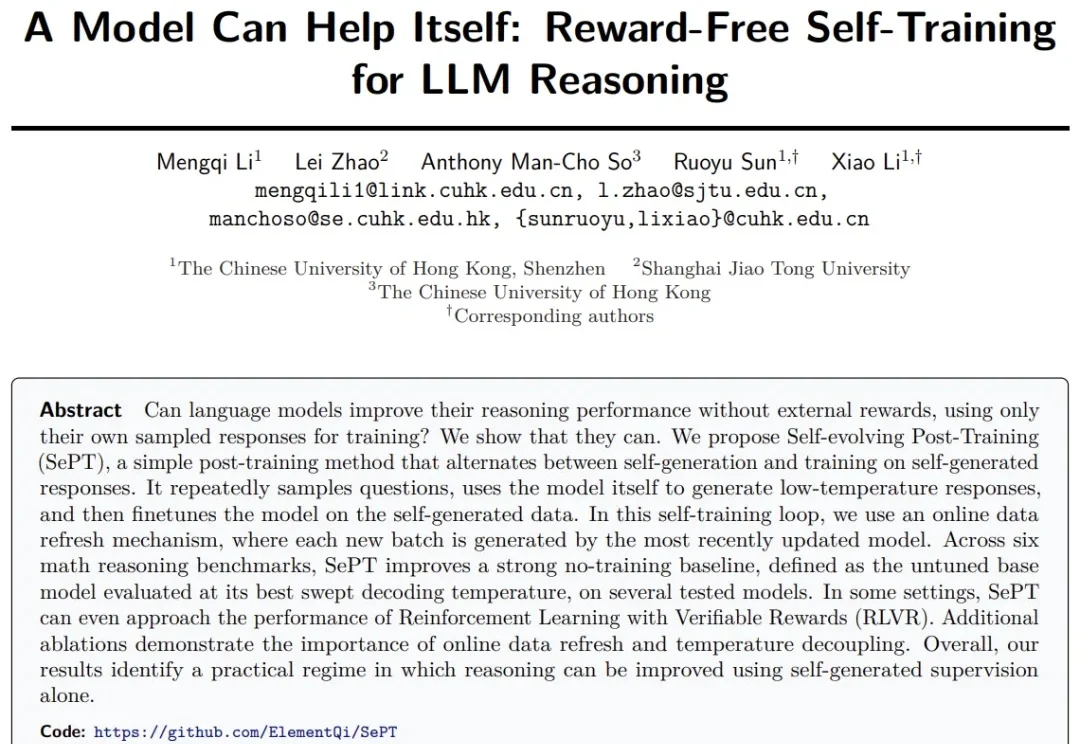
LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

LLM 仅靠自身就能增强推理?SePT 给出简洁在线自训练范式

在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!

来自主题: AI技术研报
6811 点击    2026-04-23 14:05
世界引擎:Post-Training开启Physical AGI新纪元

世界引擎:Post-Training开启Physical AGI新纪元

世界引擎:Post-Training开启Physical AGI新纪元

一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。

来自主题: AI技术研报
7283 点击    2026-04-20 09:00
又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

OpenAI的人才地震还在继续!刚刚,前研究副总裁Max Schwarzer宣布离职,这位亲手主导o1、o3和整个GPT-5系列post-training的核心人物,选择加入Anthropic,重返一线RL研究。

来自主题: AI资讯
10067 点击    2026-03-05 14:57
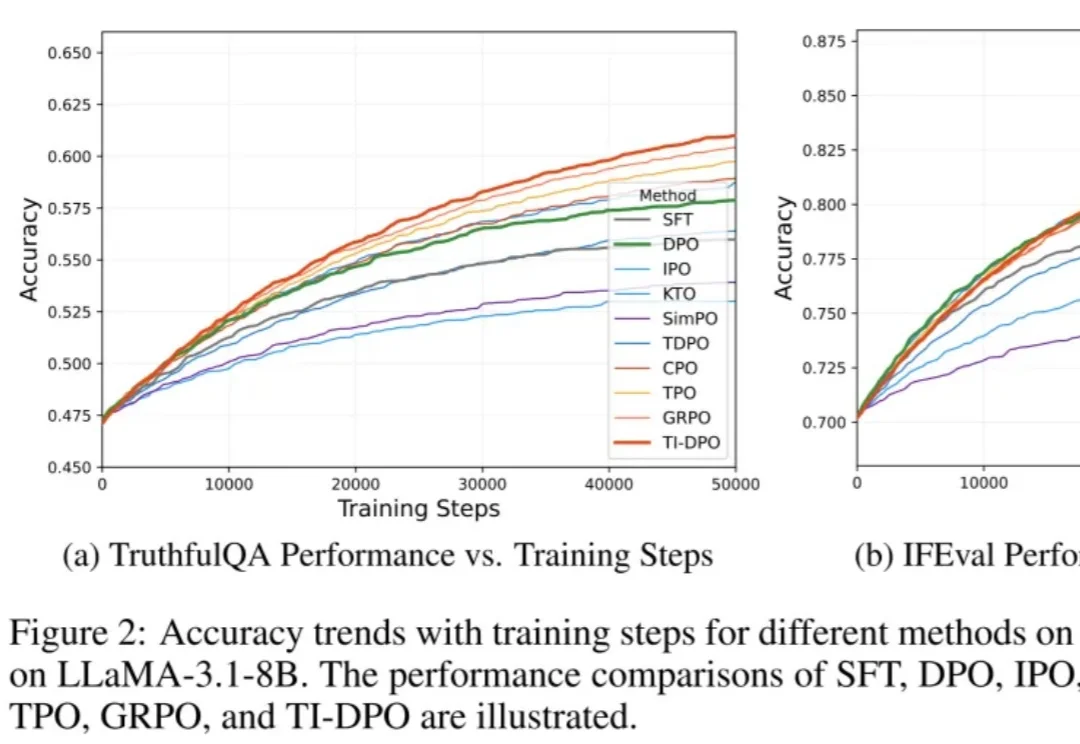
ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐

ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐

ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐

在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。

来自主题: AI技术研报
8960 点击    2026-02-11 13:58
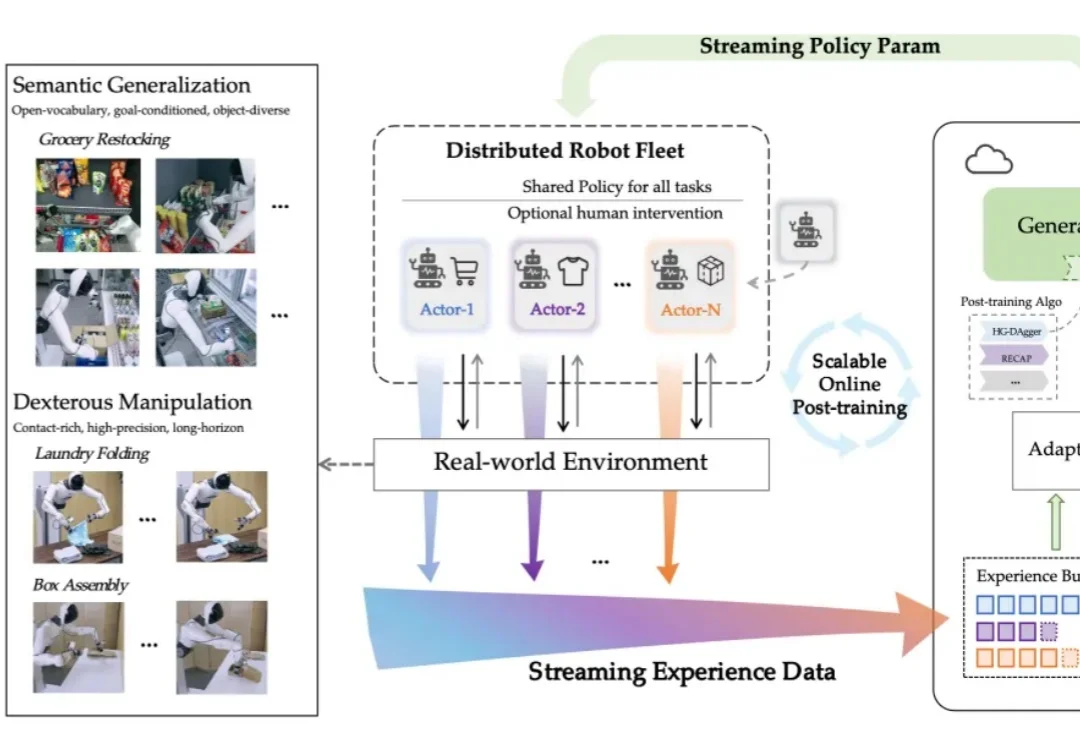
刚刚,智元提出SOP,让VLA模型在真实世界实现可扩展的在线进化

刚刚,智元提出SOP,让VLA模型在真实世界实现可扩展的在线进化

刚刚,智元提出SOP,让VLA模型在真实世界实现可扩展的在线进化

对于电子产品,我们已然习惯了「出厂即巅峰」的设定:开箱的那一刻往往就是性能的顶点,随后的每一天都在折旧。

来自主题: AI技术研报
9576 点击    2026-01-07 10:14